
Полгода я жил в одном и том же цикле. Собираешь скрапер, вечером он проходит все страницы, а к обеду следующего дня отдаёт сплошные капчи и 403. Добавляешь puppeteer‑stealth, сверху ещё десяток заплаток, гонишь трафик через резидентные прокси, и всё равно на третьи сутки прилетает бан. Я устал чинить симптомы и сел разбираться, что именно нас выдаёт.
Рубрика «scraping»
Почему любой антидетект на JavaScript спалится. Полгода назад я перестал латать скрапер и полез в C++ Chromium
2026-07-10 в 7:53, admin, рубрики: chromium, javascript, scraping, stealthПарсинг сайтов на Python: изучаем BeautifulSoup
2026-01-18 в 11:16, admin, рубрики: beautifulsoup, scraping, парсингBeautifulSoup используется для эффективного поиска элементов на html странице.
Установка:
pip install beautifulsoup4, lxml
Для запросов установите библиотеку requests, если она у вас не установлена:
pip install requests
Тренироваться будем на "тренажёре".
Получаем HTML-документ по HTTP и строим DOM-дерево с помощью BeautifulSoup
from bs4 import BeautifulSoup
import requests

response = requests.get('http://parsingme.ru/beautifulsoup/1.html')
soup = BeautifulSoup(response.text, 'lxml')
print(soup)
Первым параметром мы передаем html-код страницы, а вторым парсер. Помимо lxml (это лучший вариант) парсер может быть:
-
html.parser - не прощает ошибок в html, зато не требует установки
Спарсил 700к ютуб каналов и построил 16 графиков которые вы навряд ли где-то видели
2025-03-21 в 13:47, admin, рубрики: scraping, statistics, YouTube, исследование, парсинг, статистика, ютубКогда-то я пытался завести ютуб канал и стать знаменитым, но оказалось что для этого нужна харизма, чувство юмора и четкая дикция, а не то что у меня.
Но все же мне удалось нафармить 3,5к подписчиков мучительными душными видео, которые совершенно не понятно зачем терпели мои зрители
Теперь, я принял себя и нашел более подходящую площадку для своей духоты, поэтому представляю вашему вниманию несколько графиков про видео хостинг ютуб, который я парсил в течение 4 месяцев
Датасет
Парсинг с помощью LLM: зачем, как и сколько стоит?
2025-03-21 в 7:15, admin, рубрики: llm, OpenAI, openai api, parser, python, scrapingВо всю идет 2025 год, и нейросети перестают быть чем-то фантастическим. Они уже повсюду в нашей жизни: от умных колонок в квартирах до сложнейших систем, управляющих логистикой и финансами. Вместе с ними стремительно меняется подход к работе с данными. В этой статье мы поговорим о том, как современные LLM помогают автоматизировать сбор данных с веб-сайтов и сводят к минимуму рутинную настройку и "подкручивание" парсеров.
OpenAI Operator: нейросетевой ящик Пандоры или путь в будущее?
2025-01-25 в 12:39, admin, рубрики: bot, chatgpt, OpenAI, scraping
Как технооптимист и человек, который последние пару лет с удовольствием варился в стартапах, построенных на LLM, я долгое время считал, что нейросети — наше светлое будущее. Но свежий анонс инструмента от OpenAI под названием OperatorЧитать полностью »
Руководство по веб-скрейпингу на Python
2024-02-28 в 13:00, admin, рубрики: beautiful soup, ruvds_переводы, scraping, веб-скрейпинг, краулеры, краулинг, скрейпинг
В этом туториале мы создадим надёжные веб-краулеры с использованием таких библиотек, как BeautifulSoup, изучим техники, позволяющие преодолевать реальные трудности при скрейпинге, а также представим рекомендации по крупномасштабному скрейпингу.
Вы получите навыки для скрейпинга сложных сайтов и решения проблем, которые касаются ограничений частоты запросов, блокировок и генерируемых при помощи JavaScript страниц.Читать полностью »
Визуализация списка женщин-лауреатов Нобелевской премии в виде кристаллов в 3d с использованием Vue, WebGL, three.js
2020-06-13 в 19:11, admin, рубрики: Generative Art, geometry shader, glsl, javascript, scraping, shaders, vue, vuejs, WebGL, wikimedia api, визуализация данных, Работа с 3D-графикой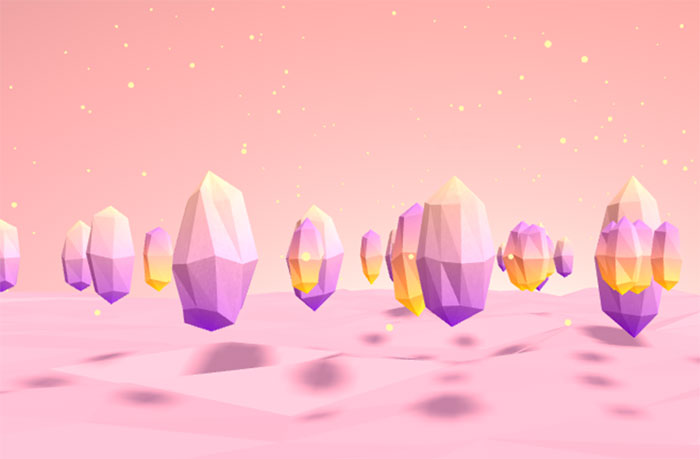
Год 1 | вдохновение
В этом месяце я очень долго пыталась определиться с датасетом и идеей для его обработки. Хотя я начала думать о нем еще в мае, по факту законить удалось только через 8 месяцев (черт, я плоха), а описать проект мне удалось еще спустя месяц (оу, я чертовски плоха).
Идея проекта пришла ко мне после просмотра фильма Безумно богатые азиаты. Мне очень понравилась актриса Мишель Йео, но идея оформилась только после того, как я прочитала больше о ней и узнала, насколько она была выдающейся и крутой. Это заставило меня задуматься выдающихся женщинах, о которых я понятия не имею. И вот — возникла идея как-то это визуализировать.
Читать полностью »
Введение
Всем привет. Недавно у меня возникла идея о том, чтобы поделиться с интересующимся кругом лиц о том как пишутся скраперы. Так как большинству аудитории знаком Python все дальнейшие примеры будут написаны на нём.
Данная часть рассчитана для того, чтобы познакомить тех, кто ещё не пробовал себя в данной сфере. Если вы уже продвинутый читатель, то можете смело листать дальше, но для сохранения закономерности я бы посоветовал уделить немного внимания данной статье.
print('Part 1. Get started')Инструменты
- Язык программирования и соответствующие библиотеки
Конечно, без него никуда. В нашем случае будет использован Python. Данный язык является довольно сильным инструментом для написания скраперов, если уметь правильно пользоваться им и его библиотеками: requests, bs4, json, lxml, re. - Инструменты разработчика
Каждый современный браузер имеет данную утилиту. Лично мне удобно пользоваться Google Chrome или Firefox. Если вы пользуетесь другим браузерами, рекомендую попробовать один из вышеперечисленных. Здесь нам понадобятся практически все инструменты: elements, console, network, application, debuger. - Современная IDE
Здесь выбор остаётся за вами, единственное, что хотелось бы посоветовать — наличие компилятора, debuger'a и статического анализатора в вашей среде разработке. Я отдаю своё предпочтение PyCharm от JetBrains.Читать полностью »
Web scraping на R, часть 2. Ускорение процесса с помощью параллельных вычислений и использование пакета Rcrawler
2019-08-26 в 6:46, admin, рубрики: data mining, parallel programming, R, scraping, параллельное программирование
В прошлой статье я с помощью скрэпинга-парсинга собрал с сайтов IMDB и Кинопоиск оценки фильмов и сравнил их. Репозиторий на Github.
Код неплохо справился со своей задачей, однако скрэпинг часто используют для "соскабливания" не пары-тройки страниц, а пары-тройки тысяч и для такого "большого" скрэпинга код из прошлой статьи не подходит. Точнее будет сказать не оптимален. В принципе, Вам практически ничего не мешает его использовать для задач обхода тысяч страниц. Практически, потому что столько времени у Вас просто нет Читать полностью »
Web scraping с помощью R. Сравнение оценок фильмов на сайтах Кинопоиск и IMDB
2019-08-08 в 9:41, admin, рубрики: data mining, dataviz, R, scraping, анализ данных, визуализация данных, извлечение данных, скраппинг
Всемирная паутина — это океан данных. Здесь можно посмотреть практически любую интересующую Вас информацию. Однако, "вытащить" эту информацию из интернета уже сложнее. Есть несколько способов получить данные и web-scraping один из них. Читать полностью »