Сегодня мне хотелось бы поведать вам историю о том, как мы определяли сайты, торгующие наркотиками в рунете, о масштабах проблемы, об опыте взаимодействия IT компании с Роскомнадзором, депутатами, различными палатами, и почему на это больше не хватает зла.
Читать полностью »
Рубрика «data mining» - 42
Как мы изгоняли наркоторговцев из рунета
2017-10-15 в 10:16, admin, рубрики: crawling, data mining, statoperator, органы государственной власти, Роскомнадзор, управление проектамиНестандартная кластеризация 4: Self-Organizing Maps, тонкости, улучшения, сравнение с t-SNE
2017-10-13 в 5:56, admin, рубрики: clustering, data mining, neural networks, python, self-organizing maps, SoM, theano, Алгоритмы, математика, машинное обучениеЧасть первая — Affinity propagation
Часть вторая — DBSCAN
Часть третья — кластеризация временных рядов
Часть четвёртая — SOM
Self-organizing maps (SOM, самоорганизующиеся карты Кохонена) — знакомая многим классическая конструкция. Их часто поминают на курсах машинного обучения под соусом «а ещё нейронные сети умеют вот так». SOM успели пережить взлёт в 1990-2000 годах: тогда им пророчили большое будущее и создавали новые и новые модификации. Однако, в XXI веке SOM понемногу уходят на задний план. Хоть новые разработки в сфере самоорганизующихся карт всё ещё ведутся (большей частью в Финляндии, родине Кохонена), даже на родном поле визуализации и кластеризации данных карты Кохонена всё чаще уступает t-SNE.
Давайте попробуем разобраться в тонкостях SOM'ов, и выяснить, заслуженно ли они были забыты.

Data Science Week 2017. Обзор второго и третьего дня
2017-10-12 в 11:06, admin, рубрики: big data, bitcoin, career, data mining, data science week, dsw, Блог компании New Professions Lab, машинное обучениеПривет! Продолжаем рассказывать о прошедшем 12-14 сентября форуме Data Science Week 2017, и на очереди обзор второго и третьего дня, где были затронуты вопросы построения рекомендательных систем, анализа данных в Bitcoin и построения успешной карьеры в области работы с данными.
О конференции Strata AI: будущее искусственного интеллекта
2017-10-12 в 7:48, admin, рубрики: AI, data mining, O’Reilly, Strata Artificial Intelligence, Алгоритмы, Блог компании ГК ЛАНИТ, искусственный интеллект, математика, машинное обучение
В этой статье я расскажу о конференции O’Reilly Strata Artificial Intelligence, которую мне довелось посетить этим летом в Нью-Йорке.
Strata AI – одна из главных конференций, посвященных искусственному интеллекту, проходит примерно раз в полгода. Конференцию не стоит путать с другим известным мероприятием Strata + Hadoop World – его также проводит O’Reilly, но то посвящено исключительно большим данным и по тематике они мало пересекаются.
Когда лучше не использовать глубинное обучение
2017-10-11 в 10:53, admin, рубрики: AutoML, big data, data mining, one-shot learning, pytorch, TensorFlow, Алгоритмы, байесовский вывод, биомедицинская информатика, вероятностная нумерика, вероятностное программирование, выпуклая оптимизация, глубинное обучение, математика, машинное обучение, механистическая модель, мешок слов, нейросети, обучение с первого раза, предрассудки, размер выборки, стохастический градиент, цепь МарковаЯ понимаю, что странно начинать блог с негатива, но за последние несколько дней поднялась волна дискуссий, которая хорошо соотносится с некоторыми темами, над которыми я думал в последнее время. Всё началось с поста Джеффа Лика в блоге Simply Stats с предостережением об использовании глубинного обучения на малом размере выборки. Он утверждает, что при малом размере выборки (что часто наблюдается в биологии), линейные модели с небольшим количеством параметров работают эффективнее, чем нейросети даже с минимумом слоёв и скрытых блоков.
Далее он показывает, что очень простой линейный предиктор с десятью самыми информативными признаками работает эффективнее простой нейросети в задаче классификации нулей и единиц в наборе данных MNIST, при использовании всего около 80 образцов. Эта статья сподвигла Эндрю Бима написать опровержение, в котором правильно обученная нейросеть сумела превзойти простую линейную модель, даже на очень малом количестве образцов.
Такие споры идут на фоне того, что всё больше и больше исследователей в области биомедицинской информатики применяют глубинное обучение на различных задачах. Оправдан ли ажиотаж, или нам достаточно линейных моделей? Как всегда, здесь нет однозначного ответа. В этой статье я хочу рассмотреть случаи применения машинного обучения, где использование глубоких нейросетей вообще не имеет смысла. А также поговорить о распространённых предрассудках, которые, на мой взгляд, мешают действительно эффективно применять глубинное обучение, особенно у новичков.
Читать полностью »
На пути к естественному интеллекту
2017-10-10 в 22:25, admin, рубрики: computer vision, data mining, machine learning, Блог компании JUG.ru Group, машинное обучение, обработка изображенийMachine Learning с каждым днём становится всё больше. Кажется, что любая компания, у которой есть хотя бы пять сотрудников, хочет себе разработать или купить решение на машинном обучении. Считать овец, считать свёклу, считать покупателей, считать товар. Либо прогнозировать всё то же самое.

Формула проста: если цена внедрения ниже, чем ты платишь охраннику — ставь управляемый шлагбаум. Потери от бездельников выше стоимости внедрения биометрической системы учёта времени — внедряй. «Эксперт» берёт взятки за контроль качества продукта? Продублируй его системой контроля качества.
Далеко не всегда можно оценить стоимость разработки. Но зачастую хватает даже порядка, чтобы начать работы и привлечь инвесторов.
Но статья, скорее, не про это. Статья про специалистов по машинному обучению. Про бум специальности, про то, какие люди начинают приходить, как из единого, общего массива специалистов начинают вырисовываться профессии, про то, как сейчас решать ML-задачи.
Читать полностью »
Книга «Python для сложных задач: наука о данных и машинное обучение»
2017-10-10 в 11:00, admin, рубрики: data mining, python, Блог компании Издательский дом «Питер», книги, машинное обучение, Профессиональная литература
Привет, Хаброжители! Данная книга — руководство по самым разным вычислительным и статистическим методам, без которых немыслима любая интенсивная обработка данных, научные исследования и передовые разработки. Читатели, уже имеющие опыт программирования и желающие эффективно использовать Python в сфере Data Science, найдут в этой книге ответы на всевозможные вопросы, например: как считать этот формат данных в скрипт? как преобразовать, очистить эти данные и манипулировать ими? как визуализировать данные такого типа? как при помощи этих данных разобраться в ситуации, получить ответы на вопросы, построить статистические модели или реализовать машинное обучение?
Ниже под катом обзор книги и отрывок «Гистограммы, разбиения по интервалам и плотность»
Читать полностью »
Как Яндекс учит искусственный интеллект разговаривать с людьми
2017-10-10 в 7:04, admin, рубрики: data mining, алиса, Блог компании Яндекс, голосовое управление, голосовой помощник, искусственный интеллект, машинное обучение, поисковые технологии, разработка мобильных приложений, яндексВ будущем, как нам кажется, люди будут взаимодействовать с устройствами с помощью голоса. Уже сейчас приложения распознают точные голосовые команды, заложенные в них разработчиками, но с развитием технологий искусственного интеллекта они научатся понимать смысл произвольных фраз и даже поддерживать разговор на любые темы. Сегодня мы расскажем читателям Хабра о том, как мы приближаем это будущее на примере Алисы – первого голосового помощника, который не ограничивается набором заранее заданных ответов и использует для общения нейронные сети.

Несмотря на кажущуюся простоту, голосовой помощник – один из самых масштабных технологических проектов Яндекса. Из этого поста вы узнаете, с какими сложностями сталкиваются разработчики голосовых интерфейсов, кто на самом деле пишет ответы для виртуальных помощников, и что общего у Алисы с искусственным интеллектом из фильма «Она».
Вести с полей больших и умных данных: программа конференции SmartData 2017 Piter
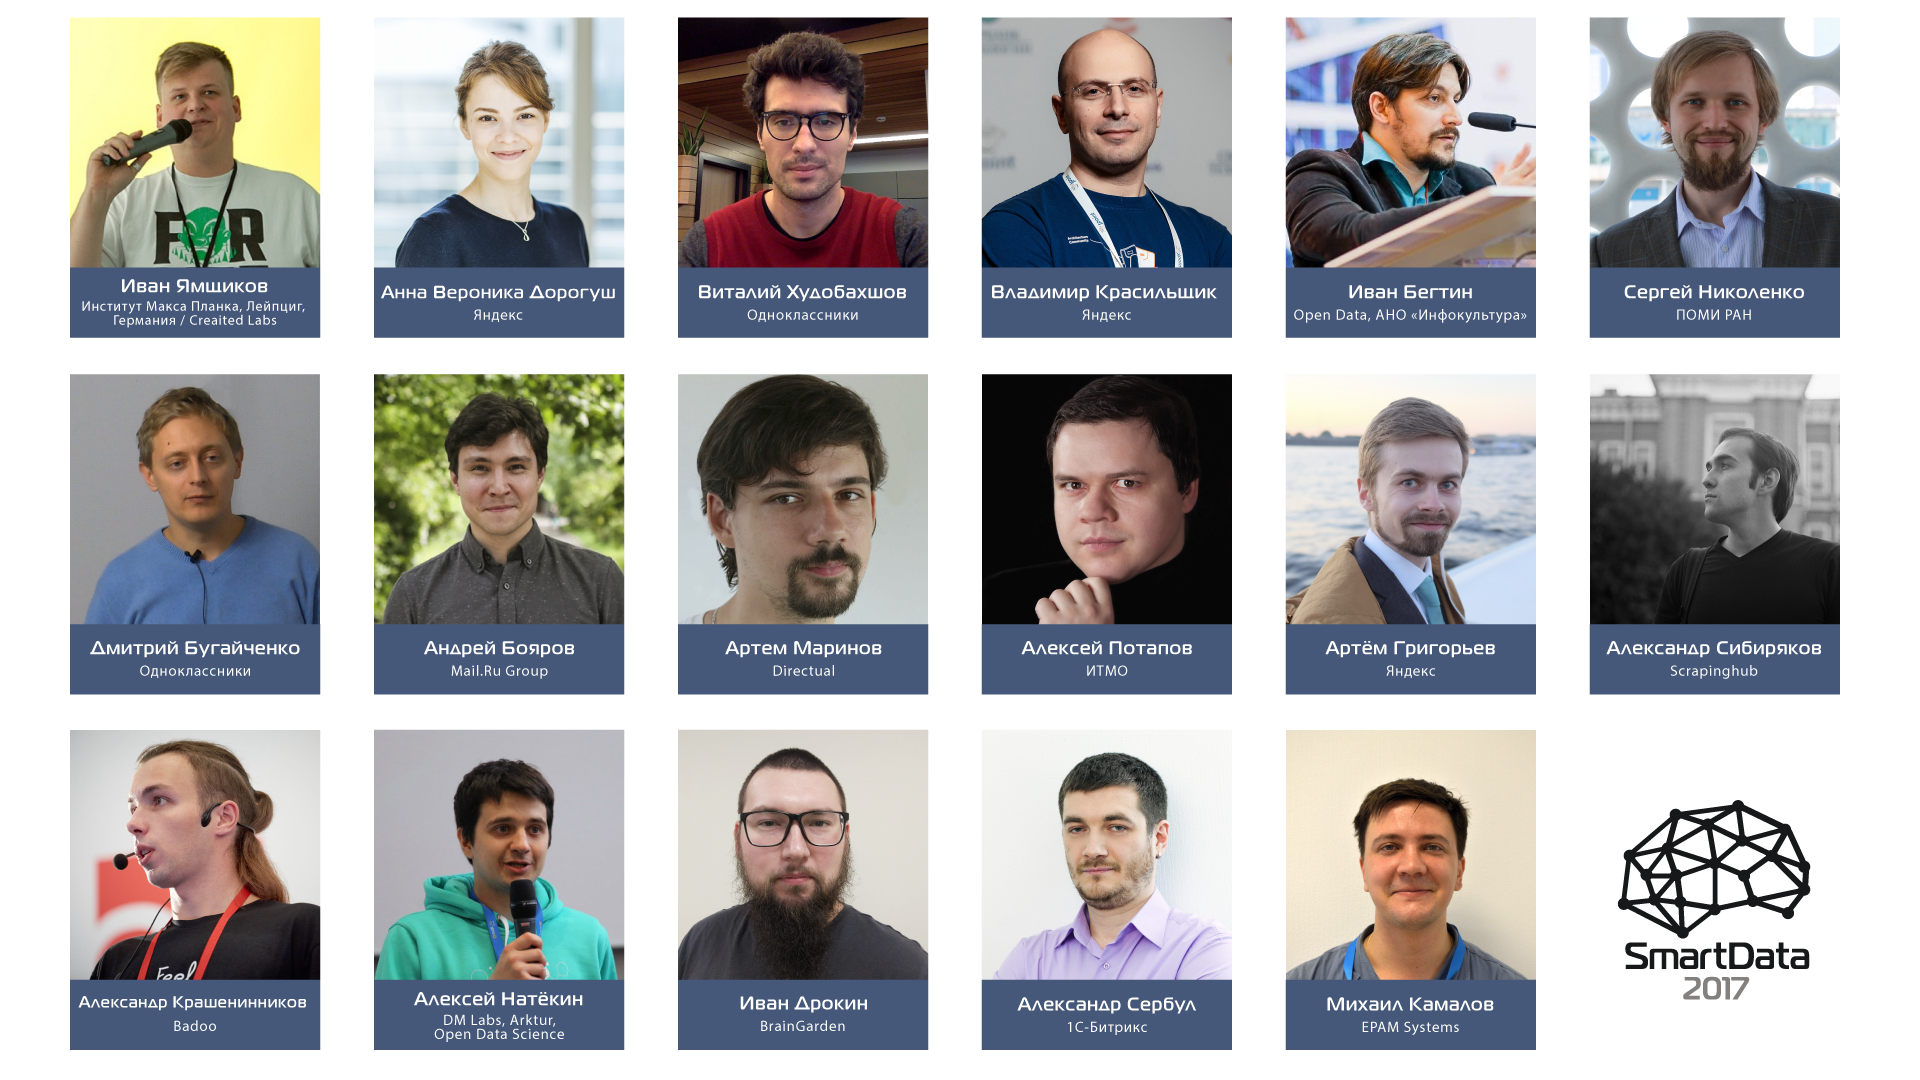
2017-10-06 в 11:07, admin, рубрики: api, artificial intelligence, big data, big data analytics, catboost, Conference, data mining, deep learning, machine learning, neural networks, neural networks and deep learning, neuroscience, smart data, Анализ и проектирование систем, Блог компании JUG.ru Group, машинное обучениеВ 2016/2017 годах мы обнаружили, что на каждой из наших конференций есть 1-3 доклада о Big Data, нейросетях, искусственном интеллекте или машинном обучении. Стало понятно, что под эту тему можно собрать хорошую конференцию, о чём я сегодня вам и расскажу.
Вкусно: мы решили собрать под одной крышей учёных, инженеров-практиков, архитекторов и сделать упор на технологии — казалось бы, обычное дело, но нет.
Сложно: копнув глубже, можно увидеть, что отдельными вопросами все занимаются не сообща, а врозь.
Учёные строят нейросети в теории, архитекторы делают распределённые системы для корпораций с целью обработки огромных потоков данных в реальном времени, без конечной цели унифицировать к ним доступ, инженеры-практики пишут под это всё софт для сугубо узких задач, которые потом нереально перенести на что-то другое. В общем, каждый копает свою грядку и не лезет к соседу… Так? Да нет же!
На деле: Все занимаются частью общего. Как сама Smart Data (а «умные данные» — это очень узкий перевод) по природе своей, так и те, кто с ней работает, по сути, делают распределённую сеть различных наработок, которые могут создавать порой неожиданные сочетания. Это и формирует фундамент Умных данных в своей красоте и практической значимости.
Итак, что это за кусочки паззла и кто их создает, можно будет посмотреть и даже обсудить с создателями на конференции SmartData 2017 Piter 21 октября 2017. Подробности под катом.
Дальше будет много букв, мы же за большие и умные данные, хотя исторически анонс подразумевает быстрый и ёмкий текст, краткий и точный, как выстрел снайпера в ясную летнюю ночь.
Читать полностью »

Распознавание дорожных знаков с помощью CNN: Spatial Transformer Networks
2017-10-06 в 7:53, admin, рубрики: big data, data mining, deep learning, Блог компании New Professions Lab, дорожные знаки, машинное обучение, обработка изображений, распознавание изображенийПривет! Продолжаем серию материалов от выпускника нашей программы Deep Learning, Кирилла Данилюка, об использовании сверточных нейронных сетей для распознавания образов — CNN (Convolutional Neural Networks).
В прошлом посте мы начали разговор о подготовке данных для обучения сверточной сети. Сейчас же настало время использовать полученные данные и попробовать построить на них нейросетевой классификатор дорожных знаков. Именно этим мы и займемся в этой статье, добавив дополнительно к сети-классификатору любопытный модуль — STN. Датасет мы используем тот же, что и раньше.
Spatial Transformer Network (STN) — один из примеров дифференцируемых LEGO-модулей, на основе которых можно строить и улучшать свою нейросеть. STN, применяя обучаемое аффинное преобразование с последующей интерполяцией, лишает изображения пространственной инвариантности. Грубо говоря, задача STN состоит в том, чтобы так повернуть или уменьшить-увеличить исходное изображение, чтобы основная сеть-классификатор смогла проще определить нужный объект. Блок STN может быть помещен в сверточную нейронную сеть (CNN), работая в ней по большей части самостоятельно, обучаясь на градиентах, приходящих от основной сети.
Весь исходный код проекта доступен на GitHub по ссылке. Оригинал этой статьи можно посмотреть на Medium.
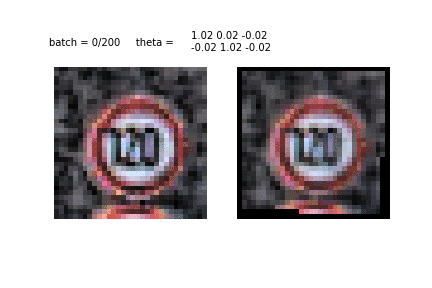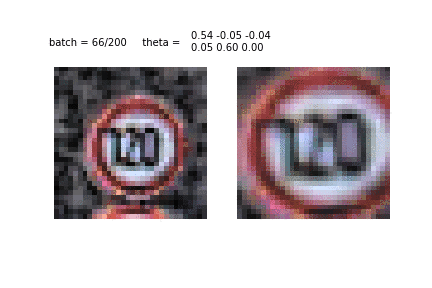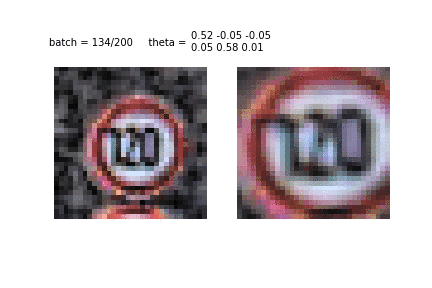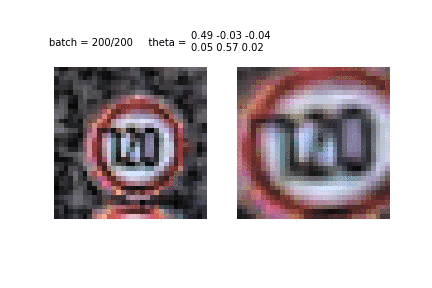
Чтобы иметь базовое представление о работе STN, взгляните на 2 примера ниже:

Слева: исходное изображение. Справа: то же изображение, преобразованное STN. Spatial transformers распознают наиболее важную часть изображения и затем масштабируют или вращают его, чтобы сфокусироваться на этой части.
Читать полностью »