Рубрика «data mining» - 41

На протяжении последних нескольких лет я управляю разработкой и мне регулярно приходится набирать новых сотрудников.

И хотя у меня нет профессионального образования в области управления персоналом, я, тем не менее, осмелюсь дать достаточно негативную оценку текущему состоянию дел в этом вопросе в IT-отрасли: на мой взгляд, собеседования полны субъективности и случайности, а среднее качество отбора получается весьма посредственным — работодатели жалуются на неадекватность запросов кандидатов, вакансии могут оставаться незакрытыми месяцами, а принятые в штат сотрудники часто не оправдывают ожиданий.
Повышение качества отбора персонала на основе данных - 1Предположу, что причиной является тот факт, что мало кто из технарей, проводящих собеседования, имеет образование в сфере управления персоналом (естественно), либо хотя бы что-то читали об этом. А рекрутеры, в свою очередь, слабо смыслят в анализе данных. В итоге, пара этих компетенций редко соединяется в одном человеке и нанимающие просто повторяют внешние признаки понравившихся им самим собеседований, не понимая, какой цели они служили исходно и какую информацию были задуманы извлечь. В итоге, с каждой такой копипастой, качество принятия решений падает.

Учитывая мою техническую специализацию, я попытался повысить качество отбора и попутно снизить затраты времени, требуемые для этого, разработав процесс, опирающийся на объективные данные, и внедрив его для найма разработчиков в свой отдел. В итоге, процесс продемонстрировал эффективность, широко распространился по компаниям, в которых я работал, и применяется сейчас для найма специалистов самого разного профиля.

Пару лет назад я уже рассказывал о нëм на HR Unconference. Но записи выступления нет, а знакомые, которые не могут найти себе людей в отдел, всë чаще интересуются деталями, так что я решил, наконец, подробно всë расписать, а заодно и опубликовать свой первый пост на Хабре, поделившись своими наработками с широким кругом читателей.Читать полностью »
Часть первая — Affinity Propagation
Часть вторая — DBSCAN
Часть третья — кластеризация временных рядов
Часть четвёртая — Self-Organizing Maps (SOM)
Часть пятая — Growing Neural Gas (GNG)

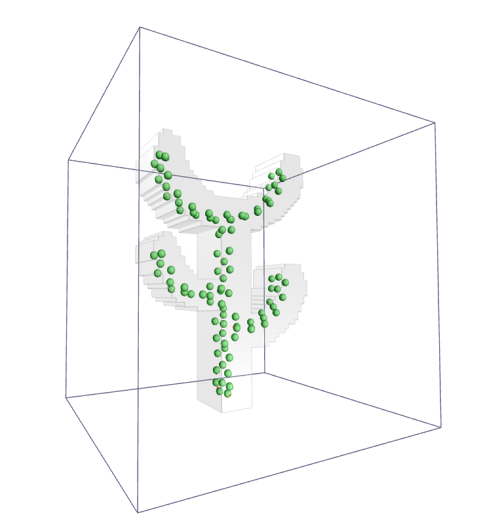
Доброго времени суток! Сегодня я бы хотел рассказать об одном интересном, но крайне малоизвестном алгоритме для выделения кластеров нетипичной формы — расширяющемся нейронном газе (Growing Neural Gas, GNG). Особенно мало информации об этом инструменте анализа данных в рунете: статья в википедии, рассказ на Хабре о сильно изменённой версии GNG и пара статей с одним лишь перечислением шагов алгоритма — вот, пожалуй, и всё. Весьма странно, ведь мало какие анализаторы способны работать с меняющимися во времени распределениями и нормально воспринимают кластеры экзотической формы — а это как раз сильные стороны GNG. Под катом я попробую объяснить этот алгоритм сначала человеческим языком на простом примере, а затем более строго, в подробностях. Прошу под кат, если заинтриговал.

Нестандартная кластеризация 5: Growing Neural Gas - 1

(На картинке: нейронный газ осторожно трогает кактус)
Читать полностью »

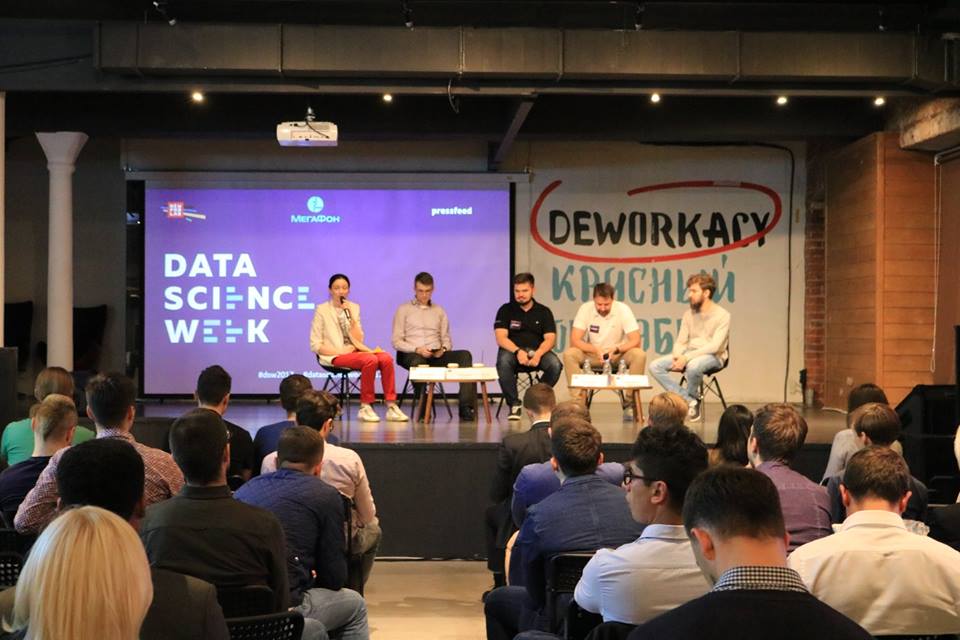
Привет! Публикуем заключительную часть обзора Data Science Week 2017, прошедшем в Москве 12-14 сентября. Сегодня расскажем о панельной дискуссии по теме “Подбор команд по работе с данными и оценка их эффективности”. Модератором выступила Ольга Филатова, вице-президент по персоналу и образовательным проектам Mail.ru Group, а участниками были Виктор Кантор (Яндекс), Андрей Уваров (МегаФон), Павел Клеменков (Rambler&Co) и Александр Ерофеев (Сбербанк).

“Главный вызов — это кадровый голод” — панельная дискуссия о подборе команд по работе с данными. Data Science Week 2017 - 1
Читать полностью »

image

Мы часто слышим такие словесные конструкции, как «машинное обучение», «нейронные сети». Эти выражения уже плотно вошли в общественное сознание и чаще всего ассоциируются с распознаванием образов и речи, с генерацией человекоподобного текста. На самом деле алгоритмы машинного обучения могут решать множество различных типов задач, в том числе помогать малому бизнесу, интернет-изданию, да чему угодно. В этой статье я расскажу как создать нейросеть, которая способна решить реальную бизнес-задачу по созданию скоринговой модели. Мы рассмотрим все этапы: от подготовки данных до создания модели и оценки ее качества.

Вопросы, которые разобраны в статье:
• Как собрать и подготовить данные для построения модели?
• Что такое нейронная сеть и как она устроена?
• Как написать свою нейронную сеть с нуля?
• Как правильно обучить нейронную сеть на имеющихся данных?
• Как интерпретировать модель и ее результаты?
• Как корректно оценить качество модели?
Читать полностью »

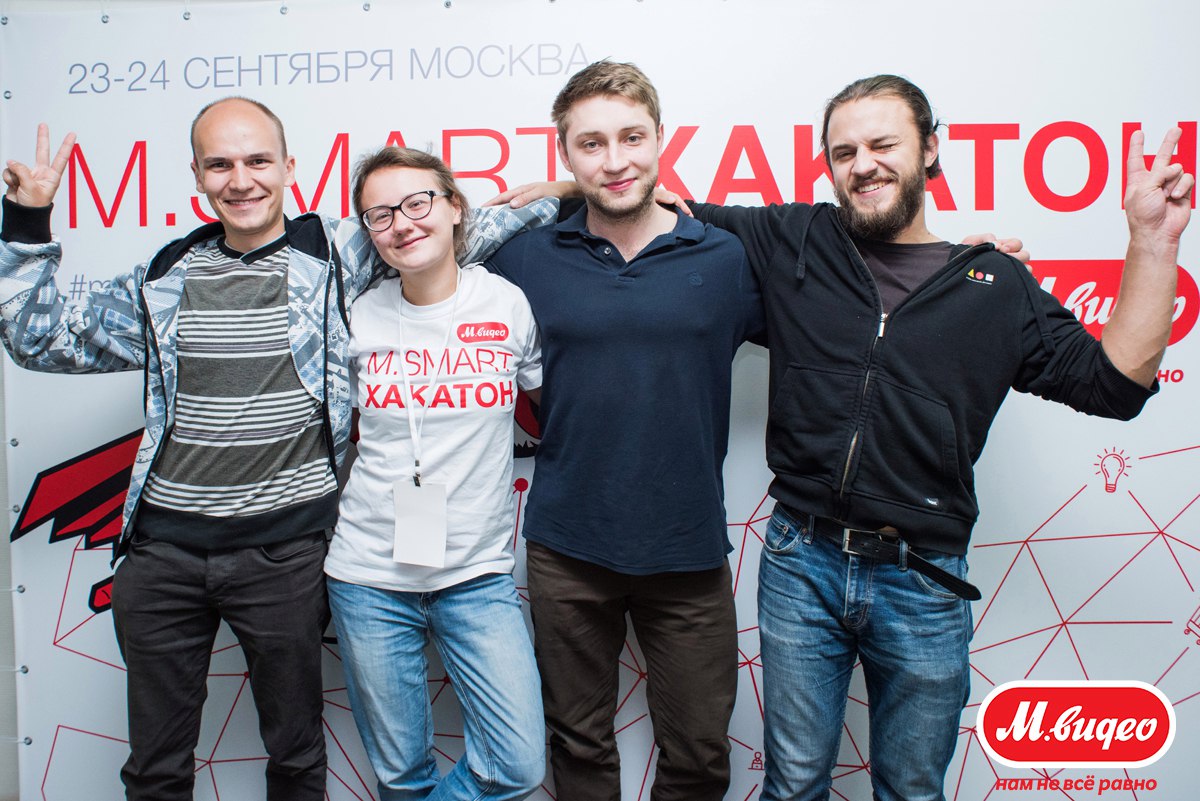
В последние выходные сентября наша команда приняла участие в хакатоне М.Видео по анализу данных. На выбор было предложено два задания: первое — генерировать описание продукта на основе отзывов о товарах, второе — выделять важнейшие характеристики товаров на основе справочника, данных о совместных просмотрах и добавлении в корзину. Мы решали оба задания. Под катом история, почему мы завалили этот хакатон и чему научились.

Как мы участвовали в хакатоне М.Видео - 1

Читать полностью »

Практика анализа данных в прикладной психологии - 1

1. Вступление

Показан процесс анализа информации в сфере прикладной психологии. Если быть более точным, то я поделюсь своим опытом поиска различий между двумя группами людей. Будет показан один из самых популярных сценариев решения подобной задачи, а также приведены примеры исходного кода на языках программирования R и Python. Важно понимать, что вся изложенная информация является моим личным субъективным мнением.

Читать полностью »

Привет! Data Engineering становится все более популярным, многие компании постепенно открывают соответствующие вакансии. В связи с этим мы взяли интервью у дата инженера и преподавателя на программах “Специалист по большим данным” и “Data Engineer” Николая Маркова о том, что должны уметь data scientist-ы и data engineer-ы, чего им чаще всего не хватает и как найти свое место в анализе данных.

“Без data engineer-а ценность модели аналитика стремится к нулю” — интервью с дата инженером Николаем Марковым - 1
Читать полностью »

Настоящая публикация не содержит ни кода, ни картинок, поскольку суть вопроса несколько шире, а на конкретные вопросы всегда можно ответить в комментариях.

За последние пару лет мне довелось применять R для решения весьма разнообразных задач в различных вертикалях. Естественно, что применение R заведомо подразумевает решение задач, связанных с той или иной математической обработкой цифровых данных, а разнообразность задач определялась, в первую очередь, самой предметной областью в которой эти прикладные задачи возникали. Частично отдельные задачи кратко упоминались в предыдущих публикациях. Разные предметные области, от земли (АПК) и заканчивая применением для прикладных задач с использованием летательных аппаратов, вплоть до космических.

Накопленная практика позволяет утверждать, что изначальный кредит доверия в R, сопутствующую экосистему и коммьюнити оказался полностью оправданным. Не возникло ни одного кейса, который нельзя было бы решить средствами R за разумный срок.

Независимое подтверждение этого тезиса можно получить путем наблюдения за экспоненциальным ростом успешного применения R в обычном бизнесе (не ИТ) на Западе. Например, практически половина докладов с конференции EARL 2017 (Enterprise Applications of the R Language), прошедшей в сентябре этого года, содержат кейсы по использованию R для решения бизнес-задач. В докладах есть примеры по анализу данных в недвижимости, автоматизация деятельности аудиторов, анализ транспортных систем, анализ системы канализации и многие другие отрасли...

Читать полностью »

Может быть отсылка к экзистенциальному кризису звучит слишком громко, но лично для меня проблема поиска и выбора (или выбора и поиска, это имеет значение) как в мире интернета так и в мире простых вещей по мучениям иногда приближается к нему. Выбор фильма на вечер, книги неизвестного автора, сосисок в магазине, нового утюга — дикое количество вариантов. Особенно когда не очень знаешь чего хочешь. Да и когда знаешь, но не можешь попробовать — тоже не праздник — мир разнообразен и все сразу не перепробуешь.

image


Рекомендательные системы сильно помогают в выборе, но не везде и не всегда так как хотелось бы. Часто не учитывается семантика содержания. Кроме того, во весь рост встает проблема "длинного хвоста", когда рекомендации сосредоточены только на самых популярных позициях, а интересные, но не очень популярные в массе вещи ими не охвачены.

Cвой эксперимент в этом направлении я решил начать с поиска интересных текстов взяв для этого довольно небольшое, но пишущее сообщество авторов, которые еще остались на блоговой платформе Живой Журнал. О том как сделать собственную рекомендательную систему а в результате получить еще и помощник в выборе вина на вечер — под катом.
Читать полностью »

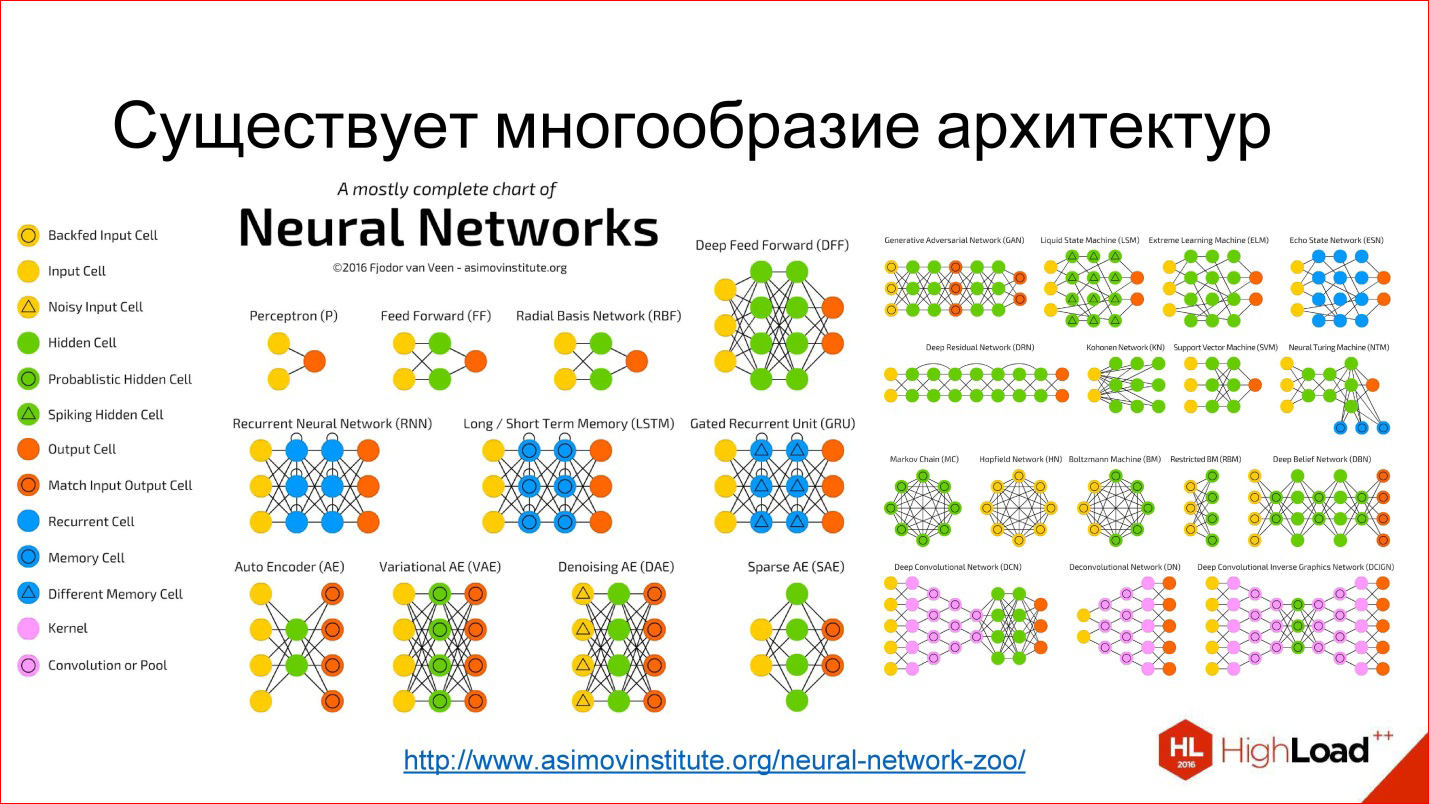
Введение в архитектуры нейронных сетей - 1

Григорий Сапунов (Intento)

Меня зовут Григорий Сапунов, я СТО компании Intento. Занимаюсь я нейросетями довольно давно и machine learning’ом, в частности, занимался построением нейросетевых распознавателей дорожных знаков и номеров. Участвую в проекте по нейросетевой стилизации изображений, помогаю многим компаниям.

Давайте перейдем сразу к делу. Моя цель — дать вам базовую терминологию и понимание, что к чему в этой области, из каких кирпичиков собираются нейросети, и как это использовать.

План доклада такой. Сначала небольшое введение про то, что такое нейрон, нейросеть, глубокая нейросеть, чтобы мы с вами общались на одном языке.

Дальше я расскажу про важные тренды, что происходит в этой области. Затем мы углубимся в архитектуру нейросетей, рассмотрим 3 основных их класса. Это будет самая содержательная часть.

После этого рассмотрим 2 сравнительно продвинутых темы и закончим небольшим обзором фреймворков и библиотек для работы с нейросетями.
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js