Рубрика «data mining» - 40

При изучении технологий Deep Learning я столкнулся с нехваткой относительно простых примеров, на которых можно относительно легко потренироваться и двигаться дальше.

В данном примере мы построим рекуррентную нейронную сеть, которая получив на вход текст романа Толстого «Анна Каренина», будет генерировать свой текст, чем-то напоминающий оригинал, предсказывая, какой должен быть следующий символ.

Структуру изложения я старался делать такой, чтобы можно было повторить все шаги новичку, даже не понимая в деталях, что именно происходит внутри этой сети. Профессионалы Deep Learning скорее всего не найдут тут ничего интересного, а тех, кто только изучает эти технологии, прошу под кат.
Читать полностью »
Hint

Перед прочтением этой статьи советую ознакомиться с предыдущей статьей о TensorFlowKit и поставить star репозиторию.

Я не люблю читать статьи, сразу иду на GitHub

GitHub: TensorFlowKit
GitHub: Example
GitHub: Другое
TensorFlowKit API
Посeтив репозиторий, добавьте его в «Stars» это поможет мне написать больше статей на эту тему.

image

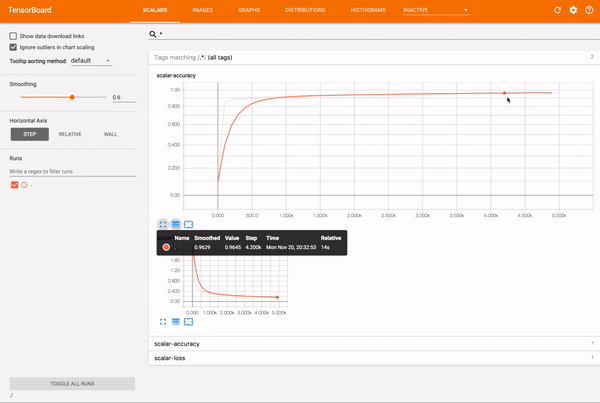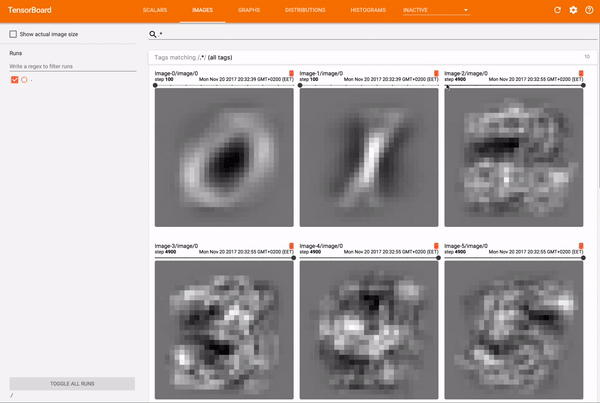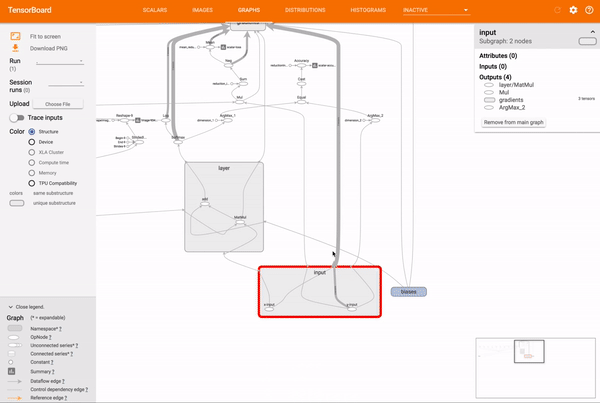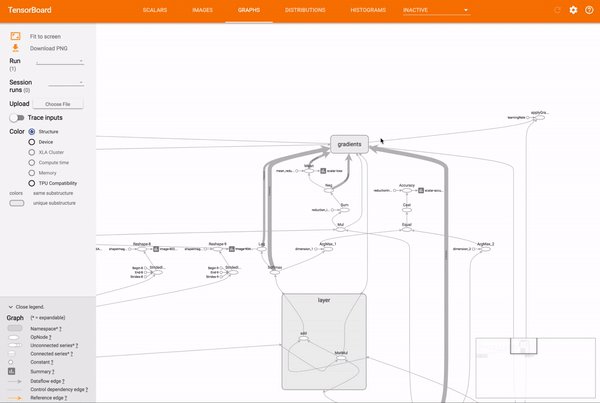
Начиная работать в сфере машинного обучения, мне было тяжело переходить от объектов и их поведений к векторам и пространствам. Сперва все это достаточно тяжело укладывалось в голове и далеко не все процессы казались прозрачными и понятными с первого взгляда. По этой причине все, что происходило внутри моих наработок, я пробовал визуализировать: строил 3D модели, графики, диаграммы, изображения и тд.

Говоря об эффективной разработке систем машинного обучения, всегда поднимается вопрос контроля скорости обучения, анализа процесса обучения, сбора различных метрик обучения и тд. Особая сложность заключается в том, что мы (люди) привыкли оперировать 2х и 3х мерными пространствами, описывая различные процессы вокруг нас. Процессы внутри нейронных сетей происходят в многомерных пространствах, что серьезно усложняет их понимание. Осознавая это, инженеры по всему миру стараются разработать различные подходы к визуализации или трансформации многомерных данных в более простые и понятные формы.

Существуют целые сообщества, решающие такого рода задачи, например Distill, Welch Labs, 3Blue1Brown.
Читать полностью »

Привет! Хочу поделиться своим опытом классификации пользователей социальной сети по их комментариям на два класса по складу ума: гуманитарный или технический. В данной статье не будут использоваться последние достижения глубокого обучения, но будет разобран завершенный проект по классификации текстов: от поиска подходящих данных до предсказаний. В конце будет представлено веб-приложение, в котором вы сможете проверить себя.

Классификация на гуманитариев и технарей по комментариям в VK - 1

Читать полностью »

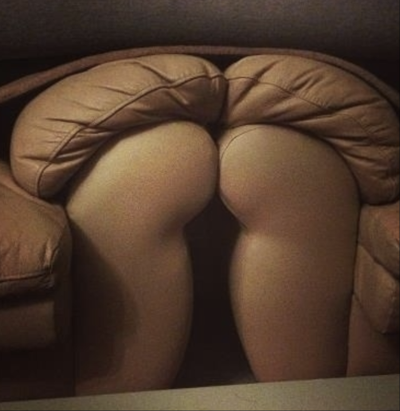
У социальной сети Одноклассники, как и у других интернет-ресурсов, где пользователи могут загружать любой контент, существует задача фильтровать изображения, нарушающие законы Российской Федерации и лицензионное соглашение самой площадки. Таким контентом в соцсети считается порнография в открытом доступе, а также сцены насилия, жестокости и прочие ужасные картинки.

Ежедневно в социальную сеть загружается более 20 миллионов картинок. Для того чтобы их проверить, наши инструменты на основе нейронных сетей автоматически фильтруют картинки определенных категорий. Однако часть контента мы пропускаем через ручную разметку, так как не всегда нейронная модель однозначно может определить, есть запрещенный контент на картинке или нет. Наш любимый пример пограничного контента — диван из разряда «показалось».

Таргетирование приложения «Модератор Одноклассников» - 1

Читать полностью »

image

В задачах машинного обучения качество моделей очень сильно зависит от данных.
Но сами данные в реальных задачах редко бывают идеальными. Как правило, самих данных не много, количество доступных для анализа параметров ограничено, в данных шумы и пропуски. Но решать задачу как-то нужно.

Я хочу поделиться практическим опытом успешного решения задач машинного обучения. И дать простой набор шагов, позволяющих выжать из данных максимум.
Читать полностью »

Является продолжением предыдущих публикаций. Не секрет, что при упоминании R в числе используемых инструментов вторым по популярности является вопрос о возможности его применения в «промышленной разработке». Пальму первенства в России неизменно держит вопрос «А что такое R?»

Попробуем разобраться в аспектах и возможности применения R в «промышленной» разработке.

Читать полностью »

Robots.txt указывает веб-краулерам мира, какие файлы можно или нельзя скачивать с сервера. Он как первый сторож в интернете — не блокирует запросы, а просит не делать их. Интересно, что файлы robots.txt проявляют предположения веб-мастеров, как автоматизированным процессам следует работать с сайтом. Хотя бот легко может их игнорировать, но они указывают идеализированное поведение, как следует действовать краулеру.

По существу, это довольно важные файлы. Так что я решил скачать файл robots.txt с каждого из 1 миллиона самых посещаемых сайтов на планете и посмотреть, какие шаблоны удастся обнаружить.

Я взял список 1 млн крупнейших сайтов от Alexa и написал маленькую программу для скачивания файла robots.txt с каждого домена. После скачивания всех данных я пропустил каждый файл через питоновский пакет urllib.robotparser и начал изучать результаты.

Анализ файлов robots.txt крупнейших сайтов - 1
Найдено в yangteacher.ru/robots.txt
Читать полностью »

Является продолжением предыдущих публикаций. Основное назначение публикаций — демонстрация возможностей R по решению различных "рутинных" задач по обработке данных, возникающих в бизнесе. Основной акцент ставится на создание законченного решения для конечного пользователя, а не на принципиальное решение частной задачи набором команд в консоли. Схематический прототип и продукт с конвейера имеют больше различий чем сходства.

По тонкой механике R есть огромное количество специализированных блогов, книг, а также github. Но обращаются к ним обычно только после того, как видят, что решение задачи средствами R возможно и весьма элегантно.

Читать полностью »

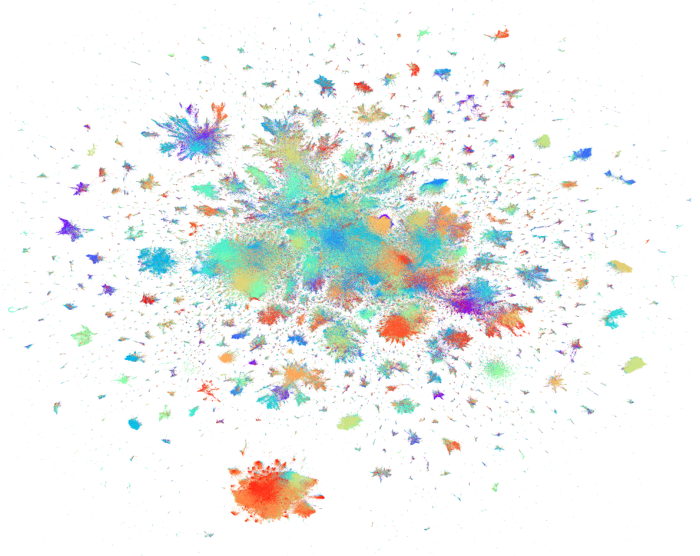
Наборами данных в миллионы экземпляров в задачах машинного обучения уже давным давно никого не удивишь. Однако мало кто задаётся вопросом, как качественно визуализировать эти титанические пласты информации. Когда размер датасета превышает миллион, становится довольно грустно использовать стандартный t-SNE; остаётся играться с даунсэмплированием или вовсе ограничиваться грубыми статистическими инструментами. Но на каждую задачу найдётся свой инструмент. В своей статье я бы хотел рассмотреть два алгоритма, которые преодолевают барьер квадратичной сложности: уже хорошо известный Barnes-Hut t-SNE и новый претендент на звание «золотого молотка infovis'a» LargeVis.

Barnes-Hut t-SNE и LargeVis: визуализация больших объёмов данных - 1

(Это не картина художника-абстракциониста, а визуализация LiveJournal-датасета с высоты птичьего полёта)
Читать полностью »

Меня часто спрашивают об основных отличиях DAX и MDX или в целом о различии табличной и многомерной модели.

С точки зрения выражения или языка запросов, одно из наиболее важных различий лежит во внутренней основе обоих подходов.

В кубе, для адресации ячейки в пространстве, у нас есть понятие кортежа. Ось в кортеже устанавливает координаты. Если у нас есть единственный кортеж, то результат — содержание соответствующей ячейки в кубе. Поскольку у атрибутов куба есть элемент All, который служит значением по умолчанию (в большинстве случаев), если атрибут не был включен в кортеж, то мы выполняем агрегацию также, как если бы он там был. Например, следующий кортеж возвращает (агрегированный) объем продаж за 2013 год

(Date.Calendar.[Calendar Year].&[2013], Measures.[Internet Sales Amount])

Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js