
Диалоговые системы давно и прочно вошли в нашу жизнь. В заглавии упомянута и на картинке представлена ELIZA — диалоговая система-психоаналитик (сейчас, ее назвали бы чат-бот), родом из 60-ых годов. Если вам интересно, как человек дошел до общения с ботами-психоаналитиками и что еще есть интересного в диалоговых системах, добро пожаловать под кат.
Рубрика «data mining» - 48
Что такое диалоговые системы, или Кое-что об Элизе
2017-06-05 в 11:26, admin, рубрики: convai, data mining, Блог компании Московский физико-технический институт (МФТИ), диалоговые системы, машинное обучение, ненормальное программирование, Системы обмена сообщениями, чат-бот, Чат-боты
О чем говорят женщины? (Text mining of beauty blogs)
2017-05-31 в 11:00, admin, рубрики: big data, data mining, анализ данных, Блог компании ГК ЛАНИТ, визуализация данных, датасеты, краулинг, ЛанитВ руках нашей команды из CleverDATA оказался уникальный материал – около 100 тыс. страниц англоязычных блогов, посвященных бьюти-сфере. Этот корпус к нам попал благодаря желанию одной косметической корпорации узнать законы, по которым «работает» блогосфера. Компания хотела эффективнее взаимодействовать с бьюти-блогерами – получать больший рекламный эффект, отдавая свои продукты в добрые руки лояльных авторов.

Источник
Читать полностью »
Анализ рынка недвижимости методом случайного леса
2017-05-27 в 20:35, admin, рубрики: crawling, data mining, machine learning, python, realty, spyder, машинное обучение, недвижимость и цены, метки: spyderРешалась задача анализа текущих предложений на минском рынке недвижимости с целью поиска недооцененных квартир. В качестве источника информации был выбран сайт риэлтерского агентства "Твоя столица".
Упущенные возможности BigData
2017-05-24 в 14:24, admin, рубрики: big data, BigData, data mining, Аализ данных, Анализ и проектирование систем, качество данных (Data Quality), Семантика, метки: Аализ данныхО том, что за BigData помноженной на искусственный интеллект стоит невероятное будущее написано уже чуть ли не больше, чем собрание сочинений братьев Стругацких и Жуля Верна вместе взятых. Все они, и не совсем без основательно, утверждают, что собранные огромные массивы данных, обработанные с помощью, например, Deep Learning смогут уже сегодня выявить всех мошенников, предотвратить сомнительные сделки и предсказать самые высокодоходные рынки. Сама же по себе финансовая отрасль станет полностью автоматизированной под управлением мудрого искусственного интеллекта.
Наверное, так и будет до некоторой степени. Уже сегодня степень автоматизации достигла такого уровня, который еще 10 лет назад казался фантастикой. Все так… Но, как известно, «мелочи» могут привнести множество сюрпризов. Одной из таких мелочей является тот факт, что львиная доля всех данных, которые можно и нужно было бы использовать в задачах борьбы с мошенничеством, прогнозированием рынков представляют собой текстовые данные. Количество ежедневно порождаемых письменных, видео и других данных составляет миллиарды строк, анализ которых с помощью операторов практически бесполезен. Кто-то может, поспорить, что все не так и большинство данных представляют собой обычные таблицы, которые хорошо обрабатываются статистическими методами. И, казалось бы, он будет прав. Банки из TOP-30 рапортуют о широком использовании BigData. Читать полностью »
Карта артистов, неуклюжий поиск связей в данных и как можно изобрести велосипед
2017-05-24 в 4:16, admin, рубрики: collaborative filtering, d3.js, data mining, data science, javascript, JS, артисты, визуализация данных, группы, музыкальные данные, открытые данные, метки: группы, музыкальные данныеНедавно смотрел серию видео популяризатора математики. Там он пытается рассказывать про математический анализ и линейную алгебру немного с позиции человека, который «как бы» изобрел бы ее с нуля. То есть пытается делать доступными простые и понятые визуализации относительно сложных концепций, как бы объясняя их с позиции человека, который как будто бы придумал это впервые. Относительно недавно читал статью на Хабре про unsupervised learning и увидел там раздел про Affinity Propagation. Как оказалось, мы использовали именно этот метод кластерного анализа чисто интуитивно, сами того не ведая.
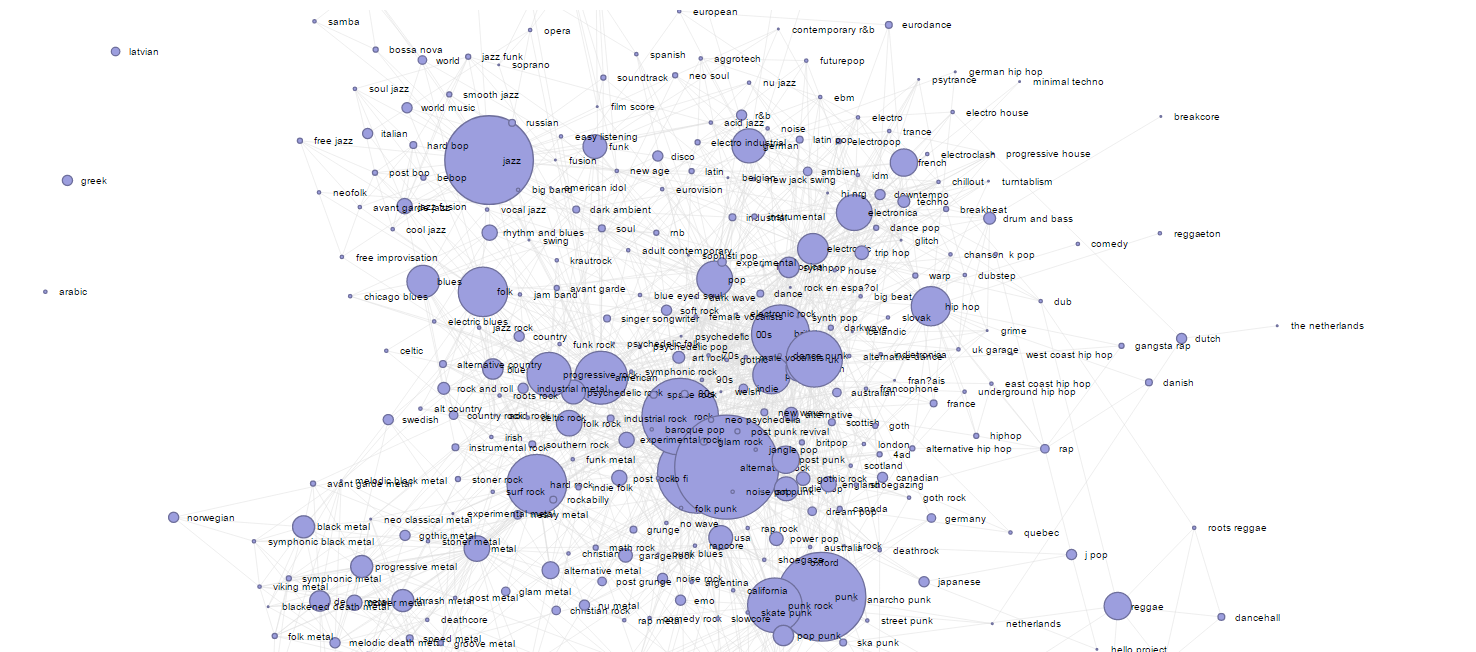
TLDR для данной статьи. Если хотите интерактивную визуализацию, проследуйте сюда.
В данной визуализации в виде графа показаны связи между музыкальными жанрами ~25,000 самых популярных артистов мира, причем размер кругляшка показывает популярность данного жанра, а размер ребра графа — силу связи.
Как стать специалистом по Data science: итоги открытого семинара в Университете ИТМО
2017-05-22 в 15:02, admin, рубрики: data mining, data science, Блог компании Университет ИТМО, Университет ИТМО16 мая в Университете ИТМО состоялся семинар, посвященный теме машинного обучения. Приглашенный лектор, заведующий кафедрой высокопроизводительных компьютерных технологий Уральского федерального университета Андрей Созыкин, рассказывал о профессии специалиста по Data science и направлениях развития этой сферы в ближайшем будущем.
В сегодняшнем материале — выдержки из интервью с лектором и рассказ о том, что нужно знать и уметь будущему специалисту по работе с данными.

Открытый курс машинного обучения. Тема 10. Градиентный бустинг. Часть 1
2017-05-18 в 10:49, admin, рубрики: boosting, data mining, Gradient Boosting, kaggle, loss function, machine learning, Алгоритмы, Блог компании Open Data Science, градиентный бустинг, гуси, математика, машинное обучение, мясорубка
Всем привет! Настало время пополнить наш с вами алгоритмический арсенал.
Сегодня мы основательно разберем один из наиболее популярных и применяемых на практике алгоритмов машинного обучения — градиентный бустинг. Наша задача — основательно разобраться в бустинге, поэтому статья разбита на 2 части: сегодня мы разберем основную теорию алгоритма, а через 2 недели — практику.
О том, откуда у бустинга растут корни и что на самом деле творится под капотом алгоритма — в нашем красочном путешествии в мир бустинга под катом. Рванули!
Нейрокурятник часть 2: про бота, который постит фотографии
2017-05-18 в 3:34, admin, рубрики: bash, data mining, open source, python, telegram api, машинное обучение, обработка изображений
Простейшее работающее решение для информирования о событиях в курятнике в режиме реального времени.
И еще немного болтовни о том, почему надо браться за задачи и изучение нового, даже если у вас недостаточно знаний.
Статьи про нейрокурятник
Заголовок спойлера
- Вступление про обучение себя нейросетям
- Железо, софт и конфиг для наблюдения за курами
- Бот, который постит события из жизни кур — без нейросети
- Разметка датасетов
- Параллельное участие в соревнованиях, визуализации внутренностей нейросетей, развитие архитектур моделей
- Работающая модель для распознавания кур в курятнике
CRISP-DM: проверенная методология для Data Scientist-ов
2017-05-17 в 10:47, admin, рубрики: CRISP, crisp-dm, data mining, data scientist, Алгоритмы, Блог компании ГК ЛАНИТ, машинное обучение, работа с даннымиПостановка задач машинного обучения математически очень проста. Любая задача классификации, регрессии или кластеризации – это по сути обычная оптимизационная задача с ограничениями. Несмотря на это, существующее многообразие алгоритмов и методов их решения делает профессию аналитика данных одной из наиболее творческих IT-профессий. Чтобы решение задачи не превратилось в бесконечный поиск «золотого» решения, а было прогнозируемым процессом, необходимо придерживаться довольно четкой последовательности действий. Эту последовательность действий описывают такие методологии, как CRISP-DM.
Методология анализа данных CRISP-DM упоминается во многих постах на Хабре, но я не смог найти ее подробных русскоязычных описаний и решил своей статьей восполнить этот пробел. В основе моего материала – оригинальное описание и адаптированное описание от IBM. Обзорную лекцию о преимуществах использования CRISP-DM можно посмотреть, например, здесь.
* Crisp (англ.) — хрустящий картофель, чипсы
Читать полностью »
Анализ взаимосвязи навыков с помощью графов в R
2017-05-17 в 9:04, admin, рубрики: clustering, data mining, data science, dataviz, graph, R, R-projectИнтересно, но такая область как профессиональное развитие остается немного в стороне от шума из-за data science. Стартапы в сфере HRtech только начинают наращивать обороты и увеличивать свою долю, замещая традиционный подход в сфере работы с профессионалами или, теми, кто хочет стать профессионалом.
Сфера HRtech очень разнообразна и включает в себя автоматизацию найма сотрудников, развитие и коучинг, автоматизацию внутренних HR процедур, отслеживание рыночных зарплат, трекинг кандидатов, сотрудников и многое другое. Данное исследование помогает с помощью методов анализа данных ответить на вопрос как взаимосвязаны навыки, какие есть специализации, какие навыки более популярны, а какие навыки следует изучить следующим.