Рубрика «data mining» - 87

В этой статье мы попытаемся рассказать о проблеме множественной классификации на примере решения задачи автоматической расстановки поисковых тегов для текстовых документов в нашем проекте www.favoraim.com. Хорошо знакомые с предметом читатели скорее всего не найдут для себя ничего нового, однако в процессе решения этой задачи мы перечитали много различной литературы где о проблеме множественной классификации говорилось очень мало, либо не говорилось вообще.

Итак, начнем с постановки задачи классификации. Пусть X — множество описаний объектов, Y — множество номеров (или наименований) классов. Существует неизвестная целевая зависимость — отображение y^*:X→Y, значения которой известны только на объектах конечной обучающей выборки X^m={(x_1,y_1 ),…,(x_m,y_m )}. Требуется построить алгоритм a:X→Y, способный классифицировать произвольный объект x∈X. Однако более распространенным является вероятностная постановка задачи. Пусть X — множество описаний объектов, Y — множество номеров (или наименований) классов. На множестве пар «объект, класс» X×Y определена вероятностная мера P. Имеется конечная обучающая выборка независимых наблюдений X^m={(x_1,y_1 ),…,(x_m,y_m )}, полученных согласно вероятностной мере P.
Читать полностью »

Два года назад многих удивила новость о том, что американская торговая сеть Target узнала о беременности девушки раньше, чем её отец. «Она ещё в школу ходит, а вы посылаете ей купоны на детскую одежду и памперсы?», — кричал тогда рассерженный отец. Ничего удивительного: простой дата-майнинг истории покупок с привязкой к дисконтной или банковской карте.

Оказывается, многие маркетинговые компании сейчас активно пытаются найти именно беременных женщин, потому что те находятся в преддверии большого количества предсказуемых покупок. Поэтому ритейлеры и производители детских товаров много платят за такую информацию. В эпоху таргетированной рекламы один только факт беременности примерно в 200 раз повышает стоимость профиля потребителя.
Читать полностью »

На хабре уже был рассмотрен муравьиный алгоритм, позволяющий используя простые правила решить задачу поиска оптимального маршрута. В данной статье рассмотрено применение этого алгоритма к задаче классификации.
Читать полностью »

Мы продолжаем рассказывать о разработанной нами нейросети и кластерном анализе для проекта favoraim.com. Чтобы наглядно представить, как развивается нейросеть во времени, мы попробовали интерпретировать изменения в ней в небольшое видео, которое показывает жизнь сети от ее «сотворения» до привлечения первого трафика – пользователей Хабра.

Взрыв в начале — это рождение нейросети, которая получила первую информацию при запуске. Затем система начинает обрастать нейронами – новыми смысловыми единицами и пользователями. Точки — это пользователи. Чем больше похожи их интересы, поведение, активность и введенные данные, тем ближе они расположены друг к другу. Серые линии – это пружины, которые моделируют систему, они отражают связи в нейросети.
Новый пользователь появляется в случайном положении с «натянутыми пружинами».Читать полностью »

В LA Times новость о землетрясении написал робот

Всего через три минуты после землетрясения в Калифорнии 17 марта газета LA Times опубликовала заметку на эту тему. Сообщение выглядит вполне обычным: указано точное время, сила землетрясения и его радиус. Единственный признак чего-то необычного — приписка в конце: «Пост создан алгоритмом, написанным автором». Другими словами, статью написал робот.
Читать полностью »

Предполагаемый размер базы транзакций Bitcoin

Мне стало интересно какого размера станет база транзакций Bitcoin на реальных объемах. Т.е. представим, что Bitcoin стал официальной валютой России.
Для примера я взяла такую статистику центрального банка России.
В целом, точные цифры неинтересны, нам важны порядки значений.
Допустим, 2013 год — 5 млрд. операций. Одну bitcoin-транзакцию сделаем минимальной — равной 1кБайт.

Итак, 5 000 000 000 * 1000 = рост базы 5ТБайт/год для одной страны.

Читать полностью »

Приветствую Вас, уважаемые читатели и писатели !
Так сложилось, что я меломан и программист – и мне однажды захотелось совместить это.
Попробую рассказать, что из этого вышло.
В данной статье будет описано, как я пытался создать алгоритм, который бы мог определять на каком инструменте сыграна мелодия.

Итак, поехали

Наши исходные данные:

  • 550 записей по 5 минут для 10 инструментов – по 55 записей на инструмент.
  • Музыкальные инструменты: пианино, виолончель, домбра, флейта, дудка, гитара, аккордеон, кларнет, альт, скрипка.
  • 9 признаков музыкального звукового сигнала.

Читать полностью »

Добрый день уважаемые читатели!

Наша компания проектирует и разрабатывает OLAP и BI решения. В процессе работы над одним проектом родилась идея создания сервиса, который помог бы розничным компаниям формировать индивидуальные предложения для своих клиентов.
Мы хотим рассказать здесь, как работает этот сервис и если получится получить Ваши советы и комментарии.

Пролог

Итак, существует розничная компания (интернет магазин, сеть турагентств, сеть обувных магазинов и т.д.). Рано или поздно такому бизнесу необходимо задуматься о базе своих клиентов, содержащую контактную информацию и историю покупок.
Располагая такой базой, компания может извлечь дополнительную прибыль различными способами. Один из них формирование индивидуальных предложений (рекомендаций) для клиентов.
Например, анализируя данные продаж одного из турагентств, был выявлен следующий факт: 12 % клиентов, посетивших остров Маврикий так же посещали город Тарифа в Испании. Возможно это случайный выбор клиентов этой компании, а возможно и нет, т.к. оба места являются очень популярными у кайтеров.

image

Читать полностью »

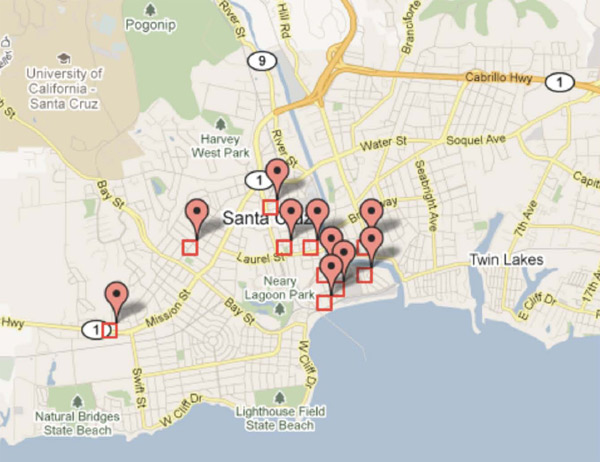
Американская полиция уже несколько лет экспериментирует с автоматической обработкой статистики о компьютерных преступлениях. Например, в 2011 году в городе Санта-Крус (Калифорния) начали использовать в экспериментальном режиме программу предсказания преступлений. Там на базе статистики преступлений за последние несколько лет вычисляется частотность каждого типа преступлений в разных районах города — и соответствующим образом составляются маршруты для полицейских патрулей с указанием «горячих точек».

Полиция Чикаго составила список из 400 предполагаемых будущих преступников

Полицейский отдел Чикаго вывел дата-майнинг на новый уровень — и объединил статистику с профилированием. Например, в прошлом году местная пресса писала о том, что полиция составила список наблюдения. В него внесены около 400 граждан, которые по профилю наиболее склонны совершить преступление в ближайшем будущем.
Читать полностью »

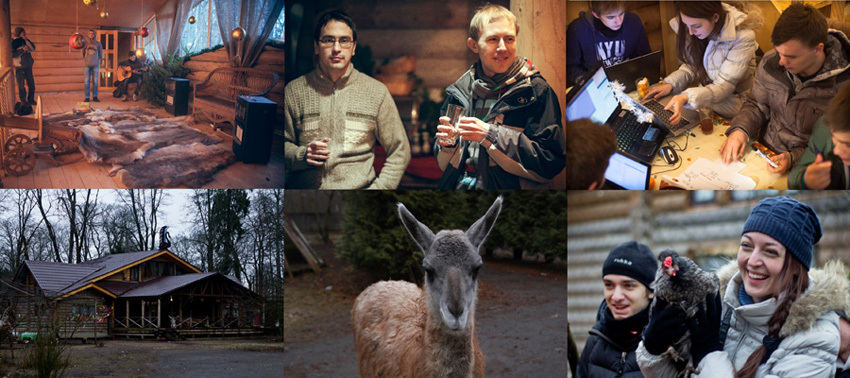
Как-то в самом начале нового года мы решили совместить приятное с полезным: дружно отдохнуть и поработать. И пригласили сотрудников, наших студентов и экспертов из компаний EMC, Rosalind, Yota, Game|Changers провести три дня зимних каникул в домике под Петербургом.

Встреча с друзьями-единомышленниками за городом хороша, чтобы поделиться идеями, написать статью или закончить работу, до которой никак не доходили руки. Для этого мы и организовали выезд на Data Mining Camp. Решили, что будет сауна, настольные игры, контактный зоопарк и – гвоздь программы – хакатон.

На хакатоне ребята при помощи экспертов работали над тремя исследованиями: модель иерархической кластеризации признаков, модель ухода слушателей онлайн-курсов, попробовали улучшить алгоритм Gradient Boosting Machines, а также поучаствовали в международном конкурсе на платформе Kaggle. О том как это было и как ребята продолжают работать над этими идеями под катом…

Data Mining Camp: как мы вдохновились на год вперед

Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js