
Современный мир системных администраторов обленил нас красивыми web-face-ами, что даже не охота ставить софт, где нет этого самого «гуя» (чувствую сейчас полетят камни от правоверных строчкеров), ну не через строку же постоянно туда лазить, правда? Все бы ничего, если софт поставил, настроил и забыл, а что делать, если туда надо постоянно лазить, править, ну и конечно же нет лога всех действий, не писать же каждый раз cp cfg cfg_back, со временем запутаешься и забьешь на это дело.
Рубрика «haproxy» - 3
Как случайно написать Web-GUI для Haproxy
2018-08-10 в 16:37, admin, рубрики: GUI, haproxy, python, web, системное администрирование
Автоматизация загрузки логов из Kibana в Redmine
2018-04-27 в 5:29, admin, рубрики: ad-hoc решение., CORS, filelist, haproxy, javascript, jquery, kibana, logstash, redmine, автоматизация, Блог компании ИНФОРИОН, КодоБред, логи, ненормальное программирование, никто не читает теги, хукТипичный юзкейс для Kibana — смотрим логи, видим ошибки, создаем тикеты по ним. Логов у нас довольно много, места для их хранения мало. Поэтому просто вставить ссылку на документ из Elasticsearch/Kibana недостаточно, особенно для низкоприоритетных задач: пока доберемся до нее, индекс с логом может быть уже удален. Соответственно, приходится документ сохранять в файл и прикреплять к тикету.
Если один раз это делать, то это еще куда ни шло, но создавать уже десять тикетов подряд будет тупо лень, поэтому я решил это «быстренько» (ха-ха) автоматизировать.
Под катом: статья для пятницы, экспериментальная фича javascript, пара грязных хаков, небольшая регулярка с галочками, reverse proxy, проигрыш безопасности удобству, костыли и очевидная картинка из xkcd.
Читать полностью »
Смена платежного сервиса с помощью A-B теста через HAProxy
2017-08-28 в 13:19, admin, рубрики: classifieds, haproxy, payments, python, биллинговые системы, Блог компании Avito, платежные системы, ПрограммированиеМы в Avito внимательно следим за развитием других классифайдов по всему миру. И конечно, нам интересны лучшие практики работы с такой непростой системой, как биллинг. Сегодня я публикую перевод поста моего коллеги по группе Naspers (Avito входит в её состав), М. Рафай Алема, инженера-программиста из Dubizzle. Это ведущий сайт объявлений в ОАЭ, входит в OLX Group — сеть крупнейших онлайн-рынков в 45 странах мира с более чем 1,9 млрд. посещений, 37 млрд. просмотров страниц и 54 млн. объявлений ежемесячно. Тема заинтересует всех, кто занимается созданием и развитием собственного платежного сервиса.
HAProxy как LoadBalanсer для RDP фермы. Надежное решение за 0$
2017-08-18 в 11:49, admin, рубрики: haproxy, load balancing, rdp, системное администрированиеHAProxy как LoadBalanсer для RDP фермы.
Совершенно случайно, в пассивном поиске альтернативы устаревшему 2X-LoadBalancer и тяжелому, непонятному Remote Connection Broker от MS наткнулся на HAProxy и его умению проксировать RDP трафик. В выдачах поисковиков практически не выдается haproxy в качестве прокси для RDP. Сейчас вдруг пачками стал выдавать. Вместе с тем, коммерческие продукты с таким же функционалом, такие как упоминались выше, стоят приличных денег.
В общем, мне показалось, что это может быть кому-то интересным. Поэтому я решил осветить это решение. Плюс, в конце продемонстрирую гибкость использования HAProxy, которой нет у именитых конкурентов.
Читать полностью »
Создаем самодостаточный Docker-кластер
2017-08-11 в 17:30, admin, рубрики: devops, docker, haproxy, Jenkins, prometheus, slack, Серверное администрирование, Сетевые технологии, системное администрированиеСамодостаточная система — это та, которая способна восстанавливаться и адаптироваться. Восстановление означает, что кластер почти всегда будет в том состоянии, в котором его запроектировали. Например, если копия сервиса выйдет из строя, то системе потребуется ее восстановить. Адаптация же связана с модификацией желаемого состояния, так чтобы система смогла справиться с изменившимися условиями. Простым примером будет увеличение трафика. В этом случае сервисам потребуется масштабироваться. Когда восстановление и адаптация автоматизировано, мы получаем самовосстанавливающуюся и самоадаптирующуюся систему. Такая система является самодостаточной и может действовать без вмешательства человека.
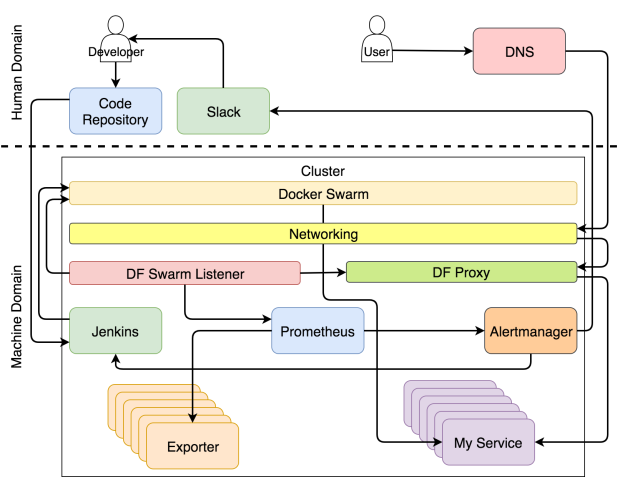
Как выглядит самодостаточная система? Какие ее основные части? Кто действующие лица? В этой статье мы обсудим только сервисы и проигнорируем тот факт, что железо также очень важно. Такими ограничениями мы составим картину высокого уровня, которая описывает (в основном) автономную систему с точки зрения сервисов. Мы опустим детали и взглянем на систему с высоты птичьего полёта.
Если вы хорошо разбираетесь в теме и хотите сразу всё понять, то система изображено на рисунке ниже.
Кластер PostgreSQL высокой надежности на базе Patroni, Haproxy, Keepalived
2017-02-21 в 12:55, admin, рубрики: Ansible, devops, haproxy, keepalived, linux, patroni, postgresql, Администрирование баз данных, системное администрированиеПривет!
Встала передо мной недавно задача: настроить максимально надежный кластер серверов PostgreSQL версии 9.6.
По задумке, хотелось получить кластер, который переживает выпадение любого сервера, или даже нескольких серверов, и умеет автоматически вводить в строй сервера после аварий.
Планируя кластер я проштудировал много статей, как из основной документации к PostgreSQL, так и различных howto, в том числе с Хабра, и пробовал настроить стандартный кластер с RepMgr, эксперементировал с pgpool.
В целом оно заработало, но у меня периодически всплывали проблемы с переключениями, требовалось ручное вмешательство для восстановления после аварий, и т.д.
В общем я решил поискать еще варианты.
В итоге где-то (уже не вспомню точно где) нашел ссылку на прекрасный проект Zalando Patroni, и все заверте…
Обнаружение сервисов в Stripe
2016-11-17 в 7:14, admin, рубрики: consul, devops, haproxy, stripe, Блог компании centos-admin.ru, Серверное администрирование, системное администрированиеКаждый год появляется столько новых технологий (таких как Kubernetes или Habitat), что легко забыть о тех инструментах, которые тихо и незаметно поддерживают наши системы в промышленной эксплуатации. Одним из таких инструментов, который мы используем в Stripe на протяжении нескольких лет, является Consul. Consul помогает в обнаружении сервисов (то есть помогает находить тысячи работающих у нас серверов с запущенными на них тысячами различных сервисов и сообщать, какие из них доступны для использования). Это эффективное и практичное архитектурное решение не было чем-то совсем новым и особенно заметным, но оно верой и правдой служит делу предоставления надежных сервисов нашим пользователям по всему миру.
В этой статье мы собираемся поговорить о следующем:
- Что такое обнаружение сервисов и Consul.
- Как мы управляли рисками, возникавшими при внедрении критически важного программного продукта.
- Вызовы, с которыми мы столкнулись, и наши ответы на эти вызовы.Читать полностью »
КЛАСТЕР высокой доступности на postgresql 9.6 + repmgr + pgbouncer + haproxy + keepalived + контроль через telegram
2016-11-01 в 5:33, admin, рубрики: cluster, failover, HA, haproxy, keepalived, pgbouncer, postgresq, replication, repmgr, Администрирование баз данных, Блог компании Этажи, Серверное администрирование, хранение данных, метки: postgresq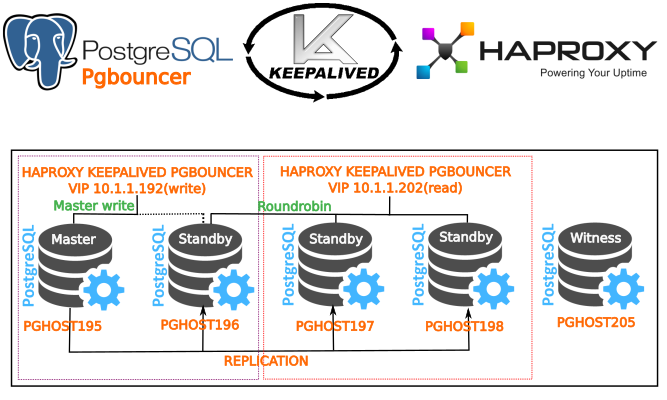
На сегодняшний день процедура реализации «failover» в Postgresql является одной из самых простых и интуитивно понятных. Для ее реализации необходимо определиться со сценариями файловера — это залог успешной работы кластера, протестировать его работу. В двух словах — настраивается репликация, чаще всего асинхронная, и в случае отказа текущего мастера, другая нода(standby) становится текущем «мастером», другие ноды standby начинают следовать за новым мастером.
На сегодняшний день repmgr поддерживает сценарий автоматического Failover — autofailover, что позволяет поддерживать кластер в рабочем состоянии после выхода из строя ноды-мастера без мгновенного вмешательства сотрудника, что немаловажно, так как не происходит большого падения UPTIME. Для уведомлений используем telegram.
Появилась необходимость в связи с развитием внутренних сервисов реализовать систему хранения БД на Postgresql + репликация + балансировка + failover(отказоустойчивость). Как всегда в интернете вроде бы что то и есть, но всё оно устаревшее или на практике не реализуемое в том виде, в котором оно представлено. Было решено представить данное решение, чтобы в будущем у специалистов, решивших реализовать подобную схему было представление как это делается, и чтобы новичкам было легко это реализовать следуя данной инструкции. Постарались описать все как можно подробней, вникнуть во все нюансы и особенности.
Читать полностью »
Барух Садогурский и Кирилл Толкачёв про DevOps на jug.msk.ru
2016-09-11 в 21:34, admin, рубрики: artifactory, devops, docker, haproxy, java, JUG, jug.msk.ru, marathon, mesos, Блог компании JUG.ru GroupЯ календарь переверну
И снова третье сентября
И вновь восьмое сентября
8 сентября 2016 года прошла встреча jug.msk.ru, собравшая, возможно, максимальное число участников. Гостями были Барух Садогурский и Кирилл Толкачёв, темой их доклада — DevOps. Что же ждало слушателей на встрече, можно прочитать далее.

Ограничение количества попыток ввода пароля в веб-форме авторизации при помощи Nginx или HAProxy на примере WordPress
2015-02-08 в 4:09, admin, рубрики: haproxy, nginx, wordpress, безопасность, безопасность веб-приложений, информационная безопасность, системное администрированиеРассмотрим на примере WordPress способ усиления безопасности при помощи ограничения количества HTTP-запросов к форме ввода пароля. Это позволит оградить опубликованный блог от брутфорса (поиска и взлома пароля путем перебора всех теоретически возможных вариантов из определенного набора символов или подбора по словарю распространенных паролей). Данный способ, в принципе, можно использовать и для защиты других веб-приложений.
Задача может быть реализована в Nginx с помощью модуля ngx_http_limit_req_module [1], выступающем в роли фронт-энда к Apache или веб-сервера FastCGI, или же с помощью HAProxy [2, 3], выступающем в роли балансировщика нагрузки перед веб-серверами.
В обоих случаях алгоритм работы следующий. При аутентификации браузер обращается по адресу, содержащему в себе подстроку "/wp-login.php". Необходимо отследить ее и ограничить количество запросов с одного IP не затрагивая обращения по всем остальным адресам. Параметры блокировки необходимо подобрать таким образом, чтобы не создавать неудобств обычным пользователями. Особенно внимательно следует настраивать блокировки в том случае, когда формой авторизации пользуется большое количество пользователей с одного IP-адреса.