Рубрика «PDF» - 7

Существует масса способов информационного сокрытия одних данных внутри других данных. Самое частое, что обычно вспоминают – это стеганографию в изображениях, аудио и видео информации.

Однако контейнеры этим не исчерпываются. Совместно с двумя разгильдяями очень талантливыми студентами (а именно с lancerx и с PavelBatusov) мы решили разработать простенький just4fun-проектик информационного сокрытия в электронных документах.

Ссылка на то, что получилось (не судите строго): pdf.stego.su
(примеры PDF можно взять здесь)

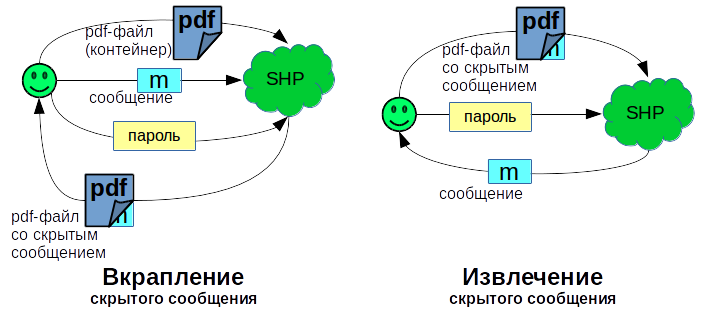
Интерфейс довольного пользователя представлен на кавайной картинке:
Информационное сокрытие в PDF документах - 1

Читать полностью »

[PF] Печать PDF под .NET, векторный подход, практика - 1

Как и обещал, продолжаю тему(раз, два) управляемой печати PDF из под .NET в векторном формате. О теоретических аспектах работы с PCL я рассказал в предыдущей статье, настало время разобрать программу для вывода на принтер PDF файла в векторе. Наше приложение будет полезно, например, когда нужно распечатать пачку многостраничных бланков или анкет на бумаге разных цветов и разной плотности. Если мы научимся управлять лотками принтера, избавим себя от ручного прокладывания страниц ;) В шаблоне будет указан номер лотка, из которого принтер заберет бумагу для текущей страницы. Причем шаблон будет применяться к документу циклически: если в документе 32 страницы, а в шаблоне 4, то шаблон повторится 8 раз для Simplex режима и 4 раза для Duplex.Читать полностью »

[PF] Векторная печать PDF на C# теория - 1

Продолжаю тему печати PDF документов из под .NET.

В принципе, распечатать документ не трудно, есть даже готовые решения. Сложности возникают, когда нужно управлять некоторыми параметрами печати. В своей практике я столкнулся с задачей по реализации минитипографии — когда при печати документов нужно указывать, из какого лотка брать очередной лист, т.е. печатать документы по шаблонам. Первым делом я попытался найти готовые решения, но не обнаружив ничего подходящего, стал придумывать свое. Читать полностью »

[PF] Печать PDF средствами .NET - 1

Под катом хочу рассказать про вывод на печать PDF фалов под .NET. С уклоном на печать из разных лотков принтера. Это бывает полезно, когда нужно распечатать документы, состоящие из разных типов бумаги разложенных по лоткам принтера.
Читать полностью »

Генерация PDF… Эта тема не нова, однако порой можно столкнуться с некоторыми тонкостями, в итоге став на тернистый путь велосипедостроения. Сегодня я расскажу, как разрабатывал один такой велосипед.

Мне понадобилось сделать генерацию отчетов в PDF. По ряду причин я решил сделать это на стороне клиента. Беглый поиск предоставил мне выбор между jsPDF и pdfmake. Остановился на первом. А теперь подробнее…

Читать полностью »

Значительная часть текстовых документов сегодня создаётся и редактируется в программе Microsoft Word. Наличие этой программы практически на каждом компьютере даёт возможность автоматизировать печать, обработку и экспорт текстовых документов в PDF, используя API Microsoft Word.

В этой статье я расскажу, как автоматизировать печать текстовых документов и конвертирование документов в формат PDF.
Читать полностью »

Компания ABBYY создала хорошую программную оболочку для работы со словарями, однако не меньшим её вкладом в цифровую лексикографию стал побочный продукт разработки ABBYY Lingvo — язык словарной разметки DSL. Он давно уже вышел за границы Lingvo, стал самостоятельным стандартом и форматом для других словарных оболочек, в том числе одной из самых известных в своём роде — GoldenDict.

Но сама по себе компания ABBYY не достигла бы таких успехов без помощи многочисленной армии энтузиастов-лексикографов, маниакально год за годом оцифровывавших бумажные словари и конвертировавших словари цифровые — от миниатюрных специальных до огромных общего назначения.

Одна из самых известных и плодотворных групп давно уже работает на сайте forum.ru-board.com. Со временем там накопилась как обширнейшая коллекция словарей, так и основательнейшая база знаний и инструментов в помощь их создателям и редакторам. Было написано множество скриптов и программ, набор которых отражает историю и изменения популярности языков программирования, более или менее приспособленных для обработки текста. Тут и Perl с Python, и языки пакетных файлов для оболочек, и макросы MS Word и Excel, и компилируемые программы на языках общего назначения.

Однако до последнего времени один из языков почти не был представлен в данной сфере. Хотелось бы восполнить этот пробел и отдать должное стремительному росту мощности, функциональности и популярности языка JavaScript. Думается, он может оказать большую помощь современным программистам-лексикографам, особенно на границе сетевой и локальной лексикографии. Читать полностью »

Вот и подоспела обещанная заключительная статья в цикле о легальном контенте в сети. Сегодня мы посмотрим, где можно с комфортом почитать лицензионные книги и периодику, и чтобы это было финансово выгоднее, чем идти в ближайший книжный за бумажными экземплярами.

Охота на лицензионный контент: капкан для книги - 1

Следует заметить, что ситуация с этим рынком куда сложнее и неоднозначнее, нежели с рынком лицензионных музыки и фильмов. С одной стороны, библиотек с нелицензионным контентом сейчас просто пруд пруди, обновляются они крайне интенсивно и, казалось бы, магазины «официальных» e-book'ов просто не выдерживают с ними конкуренции. К тому же это не кино и не музыка, у текста нет битрейта и иных аспектов качества, в этом плане магазинам крыть нечем, текст он и есть текст. А ещё нельзя забывать, что очень внушительный процент всех пользователей нелицензионного контента используют его потому, что это зачастую проще, удобнее, и быстрее. Правообладатели то взвинчивают цены, то делают процесс покупки неудобным, то ещё что. С другой стороны – после ужесточения антипиратского закона нелегальные ресурсы оказываются под значительным ударом, ибо книжные издательства последнее десятилетие несут убытки не меньше тех же музлейблов, и полны решимости бороться за место под солнцем. Причём делать это они будут явно куда жёстче – киноленты приносят деньги с проката, музыка – с живых выступлений, а вот литература монетизируется только и исключительно продажами копий книг. Кроме того, можно быть уверенным, что, если начнётся повальная блокировка пиратских библиотек, то в сети где бы то ни было просто перестанут появляться нелегальные новинки книжного рынка – кому даже из идейных побуждений будет охота сканировать бумажную книжку или ломать защиту купленной электронной, если всё равно до людей она не дойдет?
Читать полностью »

205 шпаргалок для разработчика - 1

Гуляя по просторам интернета, наткнулся на потрясающие шпаргалки для разработчика.

Все шпаргалки любезно предоставлены сайтом refcardz.dzone.com. Материалы представлены бесплатно, но доступны после простой регистрации. Для тех, кому лень и не хочется тратить время на регистрацию, я подготовил архив, который можно скачать с Яндекс.Диска.
Читать полностью »

Доброго времени суток!

Экспорт Избранного c Мегамозг в PDF - 1

Думаю многих из вас когда-либо посещала мысль о возможности получения статей из избранного в формате PDF для использования в оффлайне (например, в читалке).
Такая же мысль посетила и меня чуть больше года назад.
Представляю вам новую версию программы закачки статей с Хабра, Гиктаймс и Мегамозга в формате PDF.

Новый проект называется HabraParse.
Проект состоит из библиотечки, которая парсит сайты, и скрипта, использующего лишь часть возможностей этой библиотеки. Скрипт написан на python3, для его работы потребуются модули docopt, requests и weasyprint (все их легко можно установить командой pip install name).
На текущий момент в скрипте имеются следующие возможности:

  • скачать статью по её ID;
  • скачать список URL избранного для заданного пользователя;
  • скачать статьи из избранного в папку в формате PDF или HTML (пока реализация HTML не на высоте, поэтому по умолчанию используется формат PDF, но он работает значительно дольше).

Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js