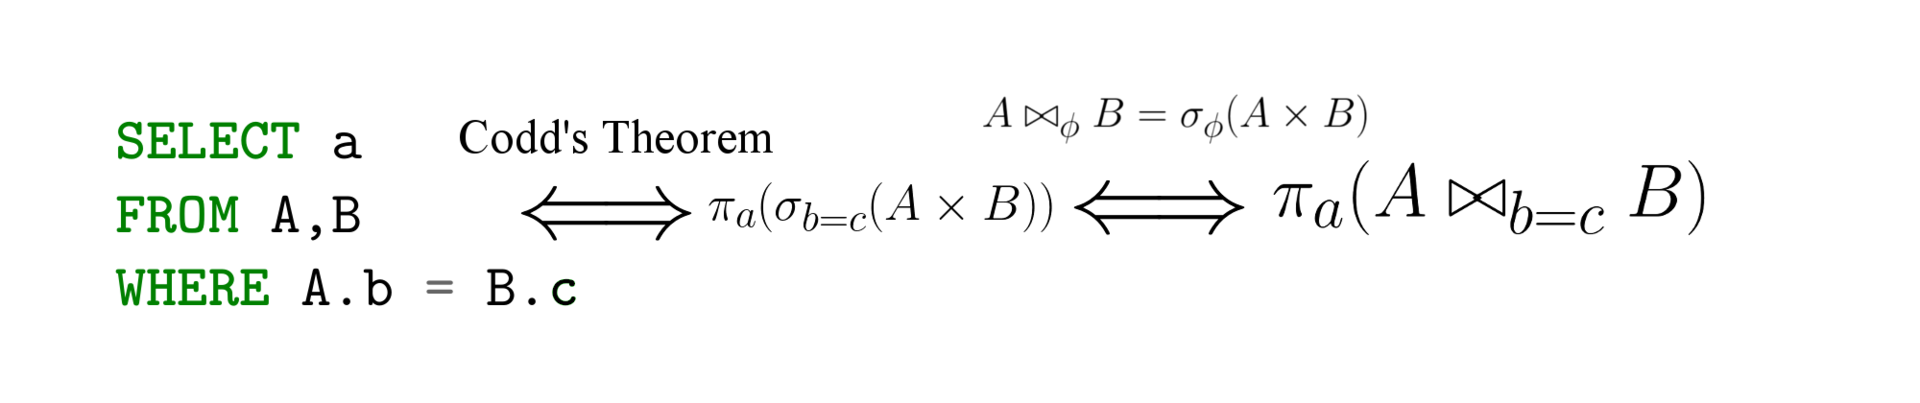Рубрика «sql» - 65

Друзья, мы с радостью продолжаем публикацию интересных материалов, посвященных самым разнообразным аспектам работы с PostgreSQL. Сегодняшний перевод открывает целую серию статей за авторством Hubert Lubaczewski, которые наверняка заинтересуют широкий круг читателей.
Объясняя необъяснимое - 1

Одна из первых вещей, которую слышит новоиспеченный администратор баз данных – «используй EXPLAIN». И при первой же попытке он сталкивается c непостижимым:

                                                        QUERY PLAN
---------------------------------------------------------------------------------------------------------------------------
 Sort  (cost=146.63..148.65 rows=808 width=138) (actual time=55.009..55.012 rows=71 loops=1)
   Sort Key: n.nspname, p.proname, (pg_get_function_arguments(p.oid))
   Sort Method: quicksort  Memory: 43kB
   ->  Hash Join  (cost=1.14..107.61 rows=808 width=138) (actual time=42.495..54.854 rows=71 loops=1)
         Hash Cond: (p.pronamespace = n.oid)
         ->  Seq Scan on pg_proc p  (cost=0.00..89.30 rows=808 width=78) (actual time=0.052..53.465 rows=2402 loops=1)
               Filter: pg_function_is_visible(oid)
         ->  Hash  (cost=1.09..1.09 rows=4 width=68) (actual time=0.011..0.011 rows=4 loops=1)
               Buckets: 1024  Batches: 1  Memory Usage: 1kB
               ->  Seq Scan on pg_namespace n  (cost=0.00..1.09 rows=4 width=68) (actual time=0.005..0.007 rows=4 loops=1)
                     Filter: ((nspname <> 'pg_catalog'::name) AND (nspname <> 'information_schema'::name))

Что бы это могло значить?
Читать полностью »

Мы рады поделиться с вами очередной статьей из серии статей о облачных сервисах Microsoft Azure. В этот раз Андрей Антюфеев — руководитель программ Microsoft из команды SQL Server и Azure SQL Database, продолжит свой рассказ о работе с инструментами оптимизации и мониторинга при работе с облачной БД Azure SQL Database. — Владимир Юнев

В этой заметке речь пойдёт о Query Performance Insight. Инструменте SQL Azure, который поможет вам идентифицировать наиболее ресурсоемкие запросы вашей базы данных,

Query Performance Insights анонсирован в начале октября и сегодня достиг отметки GA. Для того, чтобы понять, что это такое, давайте представим, что ваша база данных стала тормозить: как вы об этом узнаёте? Возможно, вас начали заваливать письмами клиенты, недельный отчёт стал выполняться час вместо привычных 3 минут, ваше приложение начало выкидывать исключения.

Начало пути – Новый портал Azure

Вы заходите на portal.azure.com и находите свою базу данных в списке ресурсов, разглядываете Monitoring chart:

Query Performance Insight: кто ест ресурсы вашей базы данных? - 1

Да, что-то случилось, DTU подскочил до 90%, что же дальше?

Чтобы заглянуть глубже и найти виновника, давайте загрузим Query Performance Insight.
Читать полностью »

Сайт реестра отечественного ПО заработал ещё в середине января, но сам реестр был пуст. 29 января в реестре появились первые записи.

reestr.minsvyaz.ru/reestr

В России заработал реестр отечественного ПО - 1

Определённый интерес представляет включение в реестр СУБД «Ред база данных». Дело в том, что это продукт, основанный на open source проекте Firebird. Но с блек-джеком и сертификатом ФСТЭК. При этом на сайте разработчика перечислен внушительный список федеральных министерств в качестве заказчиков.

Совсем недавно в интернете обсуждали волгоградский опыт обоснования закупки зарубежного ПО в виду отсутствия записей в реестре отечественного ПО.
Читать полностью »

Приручение строптивого - 1

Любите ли вы разрабатывать базы данных? Нет, не новомодные NoSQL, а старые добрые реляционные, где вы можете описывать отношения и хранимые процедуры для доступа к данным и логики. Может быть, вы разрабатываете базы данных для PostgreSQL? Если да, то отлично — этот пост определенно для вас.
Читать полностью »

Друзья, на прошедшей в прошлом году конференции PG Day'15 Russia один из наших докладчиков, Joseph Conway, представил интересный материал об использовании созданного и поддерживаемого им уже больше десяти лет расширения PL/R, которое позволяет использовать язык для статистического анализа R внутри всеми любимой базы данных. Хочу предложить вашему вниманию follow-up статью, созданную на основе материалов, представленных в докладе Joe. Задача данной публикации — обзорно познакомить вас с возможностями языка PL/R. Надеюсь, что вы найдете представленную здесь информацию полезной для себя.

image

Последние тенденции в области Big Data поощряют сближение аналитики и данных, в то время как PL/R ненавязчиво предоставляет такой сервис вот уже 12 лет! Если вдруг вы не в курсе, PL/R – это расширение для PostgreSQL, позволяющее использовать R, язык для математических расчетов, прямо из PostgreSQL для того, чтобы легко и просто получать развернутую аналитику. Расширение доступно и активно совершенствуется с 2003 года. Оно работает со всеми поддерживаемыми версиями PostgreSQL и со всеми свежими версиями R. Тысячи людей во всем мире уже оценили его удобство и эффективность. Давайте же разберемся, что такое PL/R, обсудим достоинства и недостатки такого подхода к анализу данных и рассмотрим несколько примеров для наглядности.
Читать полностью »

Как использовать БД SQL в студенческом Microsoft AZURE от Dreamspark - 1

Привет читатели!
Многие из вас слышали или читали что в Dreamspark для студентов специально добавили Microsoft Azure, чтобы у студентов появился бесплатный хостинг для их учебных проектов. Небольшой спойлер: бесплатно и без рекламы!Читать полностью »

AUTO_CLOSE и наказание калёным железом - 1Если бы SQL Server существовал во времена Инквизиции, то за включение некоторых опций на продакшен серверах нужно было бы наказывать калёным железом. Но если отбросить лирику, то далее на рассмотрим почему не нужно включать AUTO_CLOSE и к чему может привести использование этой опции.

Собственно, как и любая интересная истории из жизни, все начиналось с рутиной задачи.

На днях пришлось заглянуть в Error Log на тестовом сервере. На второй минуте ожидания, SSMS изрядно поплохело от обилия сообщений, которые хранил журнал, и я решил посмотреть сколько же весят логи с помощью xp_enumerrorlogs:

DECLARE @t TABLE (lod_id INT PRIMARY KEY, last_log SMALLDATETIME, size INT)
INSERT INTO @t
EXEC sys.xp_enumerrorlogs

SELECT lod_id, last_log, size_mb = size / 1048576.
FROM @t

lod_id   last_log              size_mb
-------- --------------------- ---------------
0        2016-01-05 08:46:00   567.05288505
1        2015-12-31 12:53:00   1370.39249420
2        2015-12-18 11:32:00   768.46394729
3        2015-12-02 13:54:00   220.20050621
4        2015-12-02 13:16:00   24.04152870
5        2015-11-16 13:37:00   80.07946205
6        2015-10-22 12:13:00   109.33527946

Читать полностью »

Используем Apache Spark как SQL Engine - 1

Привет! Мы, Wrike, ежедневно сталкиваемся с потоком данных от сотен тысяч пользователей. Все эти сведения необходимо сохранять, обрабатывать и извлекать из них ценность. Справиться с этим колоссальным объёмом данных нам помогает Apache Spark.

Мы не будем делать введение в Spark или описывать его положительные и отрицательные стороны. Об этом вы можете почитать здесь, здесь или в официальной документации. В данной статье мы делаем упор на библиотеку Spark SQL и её практическое применение для анализа больших данных.

Читать полностью »

Мы рады поделиться с вами очередной статьей из серии статей о облачных сервисах Microsoft Azure. В этот раз Андрей Антюфеев — руководитель программ Microsoft из команды SQL Server и Azure SQL Database, продолжит свой рассказ о работе с индексами в облачной БД Azure SQL Database. — Владимир Юнев

Всем привет, эта заметка будет полезна всем, кто пользуется Azure SQL Database.

Эффективное управление индексами в Azure SQL Database с помощью Index Advisor - 1

В прошлой раз, мы обозревали первую версию Index Advisor. C тех пор помощник успел дорасти до GA, повысив стабильность, и обзавестись новым возможностями:

  • возможность автоматически применять рекомендации помощника
  • новые рекомендации (Drop Index)
  • визуализация нагрузки после создания индекса
  • другие улучшения

Забудьте об управлении индексами

Процесс создания новых индексов происходит в несколько этапов:
Читать полностью »

Заметки о SQL и реляционной алгебре - 1

На Хабре и за его пределами часто обсуждают реляционную алгебру и SQL, но далеко не так часто акцентируют внимание на связи между этими формализмами. В данной статье мы отправимся к самым корням теории запросов: реляционному исчислению, реляционной алгебре и языку SQL. Мы разберем их на простых примерах, а также увидим, что бывает полезно переключаться между формализмами для анализа и написания запросов.

Зачем это может быть нужно сегодня? Не только специалистам по анализу данных и администраторам баз данных приходится работать с данными, фактически мало кому не приходится что-то извлекать из (полу-)структурированных данных или трансформировать уже имеющиеся. Для того, чтобы иметь хорошее представление почему языки запросов устроены определенным образом и осознанно их использовать нужно разобраться с ядром, лежащим в основе. Об этом мы сегодня и поговорим.

Большую часть статьи составляют примеры с вкраплениями теории. В конце разделов приведены ссылки на дополнительные материалы, а для заинтересовавшихся и небольшая подборка литературы и курсов в конце.

Содержание

Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js