Рубрика «big data» - 71

Что значит имя? Роза пахнет розой,
Хоть розой назови ее, хоть нет.

  • Шекспир "Ромео и Джульетта" (пер. Пастернака)

Ромео и Джульетта

Данная статья не может служить поводом для выражения нетолерантности или дискриминации по какому-либо признаку.

В этой статье я расскажу о том, что несмотря на то, каким бы странным это не казалось для образованного человека, вероятность быть одинокой/одиноким зависит от имени человека. То есть, по сути, мы поговорим про любовь и отношения.

Это примерно все равно, что сказать: вероятность быть сбитым машиной, если тебя зовут Сережа, выше, чем если бы тебя звали Костя! Звучит довольно дико, не правда ли? Ну, как минимум, ненаучно. Однако социальные сети сделали возможным сравнительно просто проверить приведенное выше утверждение.

Подробно мы рассмотрим только девушек, а про мужчин поговорим в самом конце. Более того, я не ставлю своей целью установить причину происходящего или даже выдвинуть какую-то сколько угодно серьезную гипотезу, а хочу лишь рассказать о своих наблюдениях и фактах, которые можно измерить.
Читать полностью »

image

1 сентября мы рады пригласить вас на очередную встречу сообщества Moscow Data Science, где вы сможете обменяться практическим опытом решения задач анализа данных и пообщаться с единомышленниками. Для одного дня программа очень насыщенная, будет две секции докладов, а среди выступающих два докладчика из ближнего зарубежья. Также гостей митапа ждёт экскурсия по офису Mail.Ru Group и розыгрыш сувениров. Присоединяйтесь! Программа встречи под катом.
Читать полностью »

Машинное обучение: от Ирисов до Телекома - 1

Мобильные операторы, предоставляя разнообразные сервисы, накапливают огромное количество статистических данных. Я представляю отдел, реализующий систему управления трафиком абонентов, которая в процессе эксплуатации у оператора генерирует сотни гигабайт статистической информации в сутки. Меня заинтересовал вопрос: как в этих Больших Данных (Big Data) выявить максимум полезной информации? Не зря ведь одна из V в определении Big Data — это дополнительный доход.

Я взялся за эту задачу, не являясь специалистом в исследовании данных. Сразу возникла масса вопросов: какие технические средства использовать для анализа? На каком уровне достаточно знать математику, статистику? Какие методы машинного обучения надо знать и насколько глубоко? А может лучше для начала освоить специализированный язык для исследования данных R или Python?

Как показал мой опыт, для начального уровня исследования данных нужно совсем не много. Но мне для быстрого погружения не хватало простого примера, на котором наглядно был бы показан полный алгоритм исследования данных. В этой статье на примере Ирисов Фишера мы пройдем весь путь начального обучения, а далее применим полученное понимание к реальным данным оператора связи. Читатели, уже знакомые с исследованием данных, могут сразу переходить к главе, посвященной Телекому.
Читать полностью »

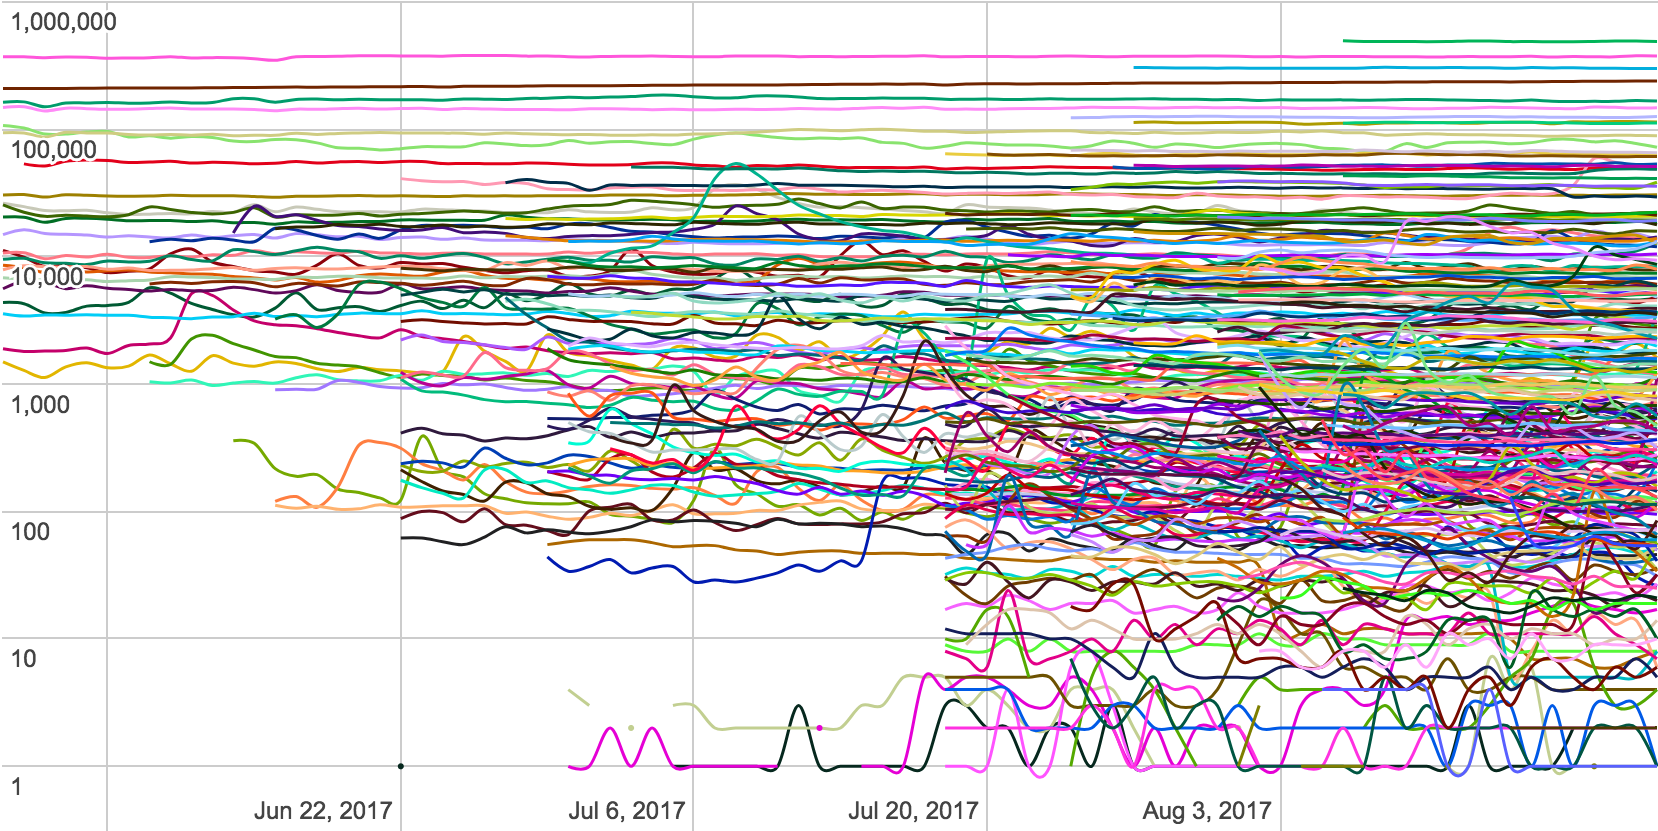
Измеряем динамику упоминания сущностей в информационном поле - 1

Сегодня мы покажем дашборд с визуализацией данных о динамике популярных сущностей, засетапим для пользователей хабра отдельный инстанс и дадим на нём возможность следить за собственными показателям, добавив регулярку.
Читать полностью »

Зачем разработчикам изучать Spark? Как освоить технологию в домашних условиях? Что умеет, а чего не умеет Spark и что ждет его в будущем? Об этом – в интервью с тренером по Java и Big Data в ЕРАМ Алексеем Зиновьевым.

Зачем изучать Spark? - 1

Читать полностью »

В январе этого года «ВКонтакте» обратилась в суд с просьбой запретить Национальному бюро кредитных историй (НБКИ) собирать данные пользователей для оценки их кредитоспособности и продажи информации банкам. 15 августа соцсеть и НБКИ заключили мировое соглашение. Об этом говорится в материалах московского Арбитражного суда. Так, организация, Читать полностью »

Если смотреть прессу, словосочетание «цифровая экономика» ожидается одним из популярных в ближайшие несколько лет.

Цифровая экономика и экосистема R - 1

Но чтобы от перейти от слов к делу и действительно совершить цифровой скачок необходимо пересмотреть подходы и используемые инструменты. В рамках настоящей публикации, являющейся продолжением предыдущих публикаций, планирую кратко проиллюстрировать, тезис о том, что применение в бизнесе R экосистемы прекрасно вписывается в задачу перехода к цифровой экономике.

Читать полностью »

image

Привет! Надеемся, этим летом не смотря на плохую погоду Вам удалось отдохнуть. Близится осень — самое время поучиться. С учетом предыдущих курсов — мы сильно обновили нашу программу — добавили множество практических занятий, больше говорим про практические кейсы. В этом посте хотелось бы подробно рассказать про все нововведения. Для тех, у кого мало времени:

  • Снизилась цена
  • 8 дополнительных практических семинаров
  • Дополнительные занятия про бизнес
  • Занятия по Deep Learning
  • Доступно удаленное обучение
  • Плюс 2 занятия в Вводном курсе

Читать полностью »

Как строить рекомендательные системы? Какие модели машинного обучения можно применять? Какие проблемы решают интерактивные рекоммендеры, а какие – нет? Какие инструменты могут быть полезны для e-commerce портала? Об этом – в докладе Big Data-инженера ЕРАМ Екатерины Сотенко «Обзор подходов построения интерактивных рекоммендеров», с которым она выступила на самарском ITsubbotnik этой весной. Ниже – видеозапись доклада, еще ниже – его краткое содержание.

Читать полностью »

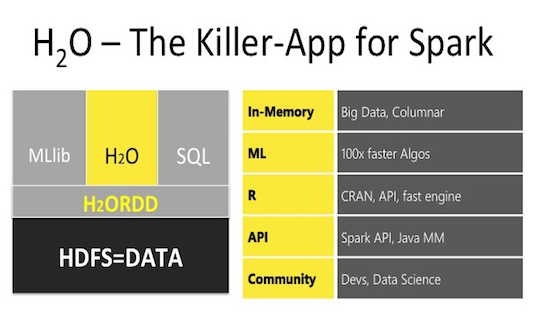
imageH2O – библиотека машинного обучения, предназначенная как для локальных вычислений, так и с использованием кластеров, создаваемых непосредственно средствами H2O или же работая на кластере Spark. Интеграция H2O в кластеры Spark, создаваемые в Azure HDInsight, была добавлена недавно и в этой публикации (являющейся дополнением моей прошлой статьи: R и Spark) рассмотрим построение моделей машинного обучения используя H2O на таком кластере и сравним (время, метрика) его с моделями предоставляемых sparklyr, действительно ли H2O киллер-приложение для Spark?

Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js