
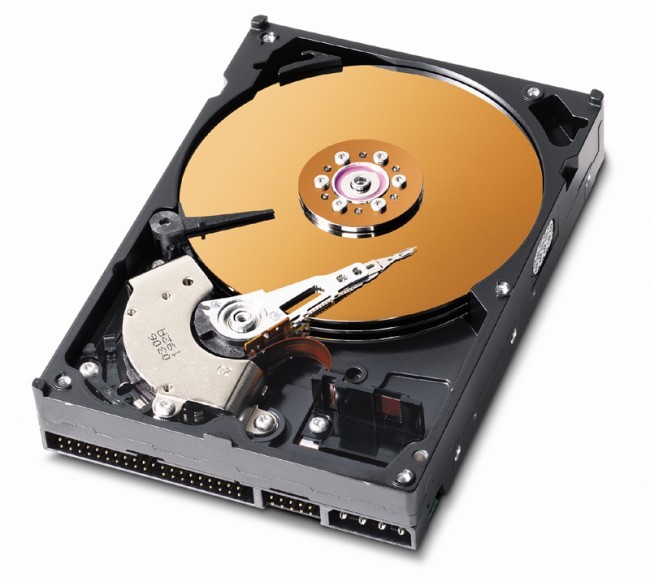
Срок службы компакт-дисков, SSD- и HDD-дисков не превышает 10-20 лет. При этом мировой объем данных растет на 40% каждый год, что стимулирует спрос на накопители, однако долговечность носителей оставляет желать лучшего. Большая часть HDD перестают работать в течение нескольких лет: как правило, это связано с поломкой движущихся частей. Компакт-диски хранятся десятилетиями, но повышение температуры, влажности или механические повреждения делают доступ к информации затруднительным: поверхность диска отслаивается и легко царапается. SSD, рекламируемые сегодня как «неубиваемый» носитель, живут всего несколько лет, и обладают фиксированным количеством циклов перезаписи: циркулирующий внутри электрический заряд рано или поздно угасает даже в отсутствие активного доступа к содержимому. При этом ценность утраченной информации может быть очень высокой: например, это могут быть большие объемы технической документации или исторические архивы, восстановить которые будет невозможно.
www.ohmygeek.net
Рубрика «big data» - 88
«Вечная флешка»: как создать надежный носитель, который сохранит данные на тысячи лет
2016-11-22 в 16:10, admin, рубрики: big data, IT-стандарты, Блог компании Фонд перспективных исследований, носители информации, хранение данных, метки: носители информацииЕще примеры использования R для решения практических бизнес-задач
2016-11-22 в 14:24, admin, рубрики: big data, data mining, data science, RС момента прошлой публикации пришлось примеряться к ряду различных задач, связанных тем или иным образом с обработкой данных. Задачи совершенно разные, но во всех случаях инструменты R позволили элегантно и эффективно их решить. Ниже, собственно, кейсы (картинок нет). Читать полностью »
Конкурс проектов в сфере рекламных технологий Go to AdTech
2016-11-20 в 11:35, admin, рубрики: big data, brand safety, geofencing, go to adtech, gotech, viewability, Блог компании GoTech.vc, конференции, Монетизация IT-систем, Монетизация веб-сервисов, Монетизация мобильных приложений, нативная реклама, новые медиа, реклама, реклама в ITФонд the Untitled ventures объявил конкурсный отбор проектов в сфере рекламных технологий и новых медиа – Go to AdTech. Победитель получит инвестиционное предложение на $ 100 000. Оператор конкурса – фонд GoTech.
Заявки на участие принимаются до 6 декабря. 12 отобранных проектов будут приглашены на финал в формате road show 16 декабря, где выступят перед руководителями ведущих рекламных агентств и медиа-площадок, а также профильными инвесторами. Все финалисты получат прямой контакт с потенциальными заказчиками, экспертную и PR-поддержку на рекламном рынке. Победитель конкурса получит инвестиционное предложение на $ 100 000 от фонда the Untitled ventures.Читать полностью »
Программа по Deep Learning
2016-11-18 в 12:58, admin, рубрики: artifical intelligence, big data, data mining, deep learning, Блог компании New Professions Lab, глубокое обучение, искусственный интеллект, машинное обучение Из уважения к тем из вас, кто на дух не переносит здесь рекламу, сразу сообщим — да, это рекламный пост. Можно проскроллить дальше. Тем, кто считает, что реклама не всегда вредна и порой помогает принимать нам важные решения, добро пожаловать под кат.
Читать полностью »
Искусственный интеллект, вызовы и риски – глазами инженера
2016-11-17 в 10:26, admin, рубрики: big data, BigData, Алгоритмы, Блог компании 1С-Битрикс, машинное обучение, нейронные сети, разработкаДобрый день, коллеги. Сегодня хочется трезво посмотреть глазами инженера на так популярные сейчас искусственный интеллект и Deep learning, упорядочить, выстроить факты и выработать выигрышную стратегию – как с этим … взлететь, пролететь и не упасть кому-нибудь на голову? Потому-что, когда дело от лабораторных моделей на python/matplotlib/numpy или lua доходит до высоконагруженного production в клиентском сервисе, когда ошибка в исходных данных сводит на нет все усилия – становится не то, что весело, а даже начинается нумерологический средневековый экстаз и инженеры начинают сутки напролет танцевать, в надежде излечиться от новомодной чумы )
Танцующие инженеры, тщетно надеющиеся исцелиться
Читать полностью »
Mail.ru Group вышел на рынок оценки эффективности офлайн-рекламы вслед за «Яндексом»
2016-11-15 в 11:27, admin, рубрики: big data, mail.ru group, аналитика, кейсы, яндекс, метки: big data, mail.ru group, аналитика, кейсы, яндексХолдинг Mail.Ru Group совместно с «НПО Аналитика» (российский разработчик системы анализа потребительского поведения на основе данных от устройств, подключенных к Wi-Fi) создали систему анализа Big Data для оценки эффективности рекламы офлайн-магазинов, говорится в сообщении холдинга. Система позволит рекламодателям лучше узнать свою офлайн-аудиторию и изучить ее реакцию на рекламные кампании.
В частности, Читать полностью »
Приглашаем на Moscow Data Science Meetup 25 ноября
2016-11-14 в 13:55, admin, рубрики: big data, data mining, data science, Блог компании Mail.Ru Group, машинное обучение
25 ноября в московском офисе Mail.Ru Group пройдет традиционная встреча сообщества Moscow Data Science. Участники поделятся профессиональным опытом решения практических задач анализа данных и пообщаются в неформальной обстановке. Встреча будет посвящена глубокому обучению. Присоединяйтесь!
Читать полностью »
Класс удаленного прокси — это не (очень) больно
2016-11-14 в 13:24, admin, рубрики: big data, MapReduce, nosql, remote proxy, Блог компании InterSystems, метки: remote proxy
(Динамическая диспетчеризация спешит на помощь)
После нескольких статей про MapReduce нам показалось необходимым еще раз отойти в сторону и поговорить про инфраструктуру, которая поможет облегчить построение решения MapReduce. Мы, по-прежнему, говорим про InterSystems Caché, и, по-прежнему, пытаемся построить MapReduce систему на базе имеющихся в системе подручных материалов.
На определенном этапе написания системы, типа MapReduce, встает задача удобного вызова удаленных методов и процедур (например, посылка управляющих сообщений с контроллера на сторону управляемых узлов). В среде Caché есть несколько простых, но не очень удобных методов достичь этой цели, тогда как хочется бы получить именно удобный.
Наталья Касперская отрегулирует Big Data пользователей
2016-11-09 в 7:45, admin, рубрики: big data, александр жаров, Госвеб, законотворчество, Игорь Ашманов, Игорь Щеголев, Наталья Касперская, Роскомнадзор, Текучка, метки: big data, Александр Жаров, Госвеб, законотворчество, Игорь Ашманов, Игорь Щеголев, Наталья Касперская, Роскомнадзор, ТекучкаВозглавляемая Игорем Щеголевым рабочая группа по вопросам развития интернета при администрации президента начала работу над новым законопроектом, регулирующим работу с «большими пользовательскими данными» (РБК, «Ведомости»). Один из членов группы Игорь Ашманов уточняет, что к концу года будет готов проект дорожной карты по законодательному регулированию «больших пользовательских данных». Направление курирует Наталья Касперская.
Рекомендации на основе изображений товаров
2016-11-09 в 7:01, admin, рубрики: big data, cnn, data mining, data science, machine learning, python, Алгоритмы, машинное обучение, распознавание изображений, рекомендательные системы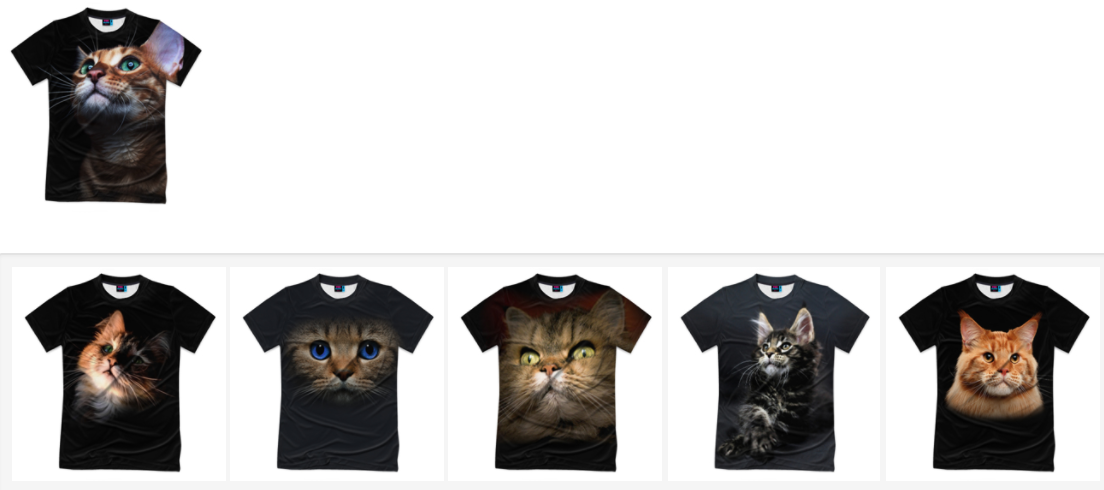
В данной статье я хотел бы рассмотреть на практике вариант построения простейшей рекомендательной системы основанной на схожести изображений товаров. Этот материал предназначен для тех, кто хотел бы попробовать применить Deep Learning, а именно свёрточные нейронные сети, в простом, интересном и практически применимом проекте, но не знает с чего начать.
Читать полностью »