Рубрика «big data» - 87

image

Сегодня мы расскажем об одной из ключевых фишек нашей DLP-системы — уровне доверия. Это показатель, который присваивается каждому человеку в компании и отражает вероятность того, что данный сотрудник окажется нарушителем.

Сейчас в DLP-решениях на первый план выходит аналитика. Пару лет назад все российские вендоры стали понемногу пытаться «разворачивать» DLP-системы от борьбы с утечками в сторону выявления и предотвращения других нелегитимных действий сотрудников — мошенничества, откатов, сговоров и т.п. Однако каждый человек генерирует такое количество информации в день, что отслеживать действия каждого невозможно даже в средних компаниях, не говоря о крупном бизнесе. Поэтому способность системы сделать качественную аналитику в автоматическом режиме и очертить круг лиц «под подозрением» была бы очевидным преимуществом. Так возникла идея создания уровня доверия, основной целью которого была прозрачность ситуации с внутренними угрозами в компании.
Читать полностью »

Yandex Data Factory разработала сервис «Экстракт» для поиска и мониторинга информации для бизнеса, пишет «Коммерсант» со ссылкой на «Яндекс». Сервис рассчитан на аналитиков, исследователей и консалтеров. Сервис уже тестируется в закрытом режиме в Центробанке.

«Организациям часто нужно найти всю доступную информацию в определенной области. Например, Читать полностью »

Гендиректор InfoWatch Наталья Касперская, возглавляющая подгруппу «Интернет + Общество» рабочей группы помощника президента РФ Игоря Щеголева рассказала ТАСС, что у России появятся предложения по регулированию «больших данных» россиян. Касперская привела в качестве примера «больших пользовательских данных» поисковые запросы, отметки о местонахожденииЧитать полностью »

[Питер, анонс] Встреча JUG.ru с Андреем Ершовым: «Как мы делали телефонную платформу с использованием GridGain» - 1

В четверг, 1 декабря, в 20:00 в офисе компании SEMrush состоится встреча JUG.ru с Андреем Ершовым, экспертом по распределенным системам. Андрей расскажет, как они в DINO Systems (Ring Central) сделали телефонную платформу с использованием GridGain. Для понимания большей части доклада знание GridGain или In-Memory Data Grid в целом не является обязательным.
Читать полностью »

image
На днях произошло, в какой-то степени, знаменательное событие и одна из крупнейших компаний России заявила о том что теперь публикует открытые данные на своем сайте. Этой компанией является Сбербанк и соответствующий раздел на их сайте. Открытие раздела удостоилось пресс-релиза на их сайте и о нем как о важном событии написали десятки финансовых и не финансовых СМИ.

Действительно ли Сбербанк совершил нечто невероятное? Рядовое ли это явление и является ли то что сделал Сбербанк сейчас открытыми данными? Вот о чем далее пойдет речь.

В качестве вступления

Прежде чем продолжить о Сбербанке, давайте вернемся к термину открытые данные.

Читать полностью »

FlyElephant празднует первый год работы в публичном доступе и анонсирует сотрудничество с HPC-HUB - 1

В ноябре FlyElephant празднует первый год работы в публичном доступе. FlyElephant — это платформа для дата сайнтистов, инженеров и ученых, которая ускоряет бизнес с помощью автоматизации Data Science и Engineering Simulation.
Читать полностью »

На эксклюзивных условиях представляем для вас полный вариант статьи из журнала Хакер, посвященной разработке на R. Под катом вы узнаете, как выжать максимум скорости при работе с табличными данными в языке R.

data.table: выжимаем максимум скорости при работе с данными в языке R - 1Читать полностью »

Пусть Жираф был не прав,
Но виновен не Жираф,
А тот, кто крикнул из ветвей:
«Жираф большой — ему видней!» (с)

Потребовалось оперативно разобраться с технологией Apache Spark заточенную для использования Big Data. В процессе выяснения активно использовал habrahabr, так что попробую вернуть информационный должок, поделившись приобретенным опытом.

А именно: установкой системы с нуля, настройкой и собственно программированием кода решающего задачу обработки данных для создания модели, вычисляющей вероятность банкротства клиента банка по набору таких признаков как сумма кредита, ставка и т.д.

Больших данных вроде как должно быть много, но почему-то не просто найти то злачное место, где их все щупают. Сначала попробовал вариант с ambari, но на моей Window7 валились ошибки настроек сетевого моста. В итоге прокатил вариант с преднастроенной виртуальной машиной от Cloudera (CDH). Просто устанавливаем VirtualBox, запускаем скачанный файл, указываем основные параметры (память, место) и через 5 минут достопочтенный джин Apache Hadoop жаждет ваших указаний.

Несколько слов, почему именно Spark. Насколько я понимаю, ключевые отличия от изначальной MapReduce в том, что данные удерживаются в памяти, вместо сброса на диск, что дает ускорение во много раз. Но, пожалуй, более важны реализации целого ряда статистических функций и удобным интерфейсом для загрузки/обработки данных.

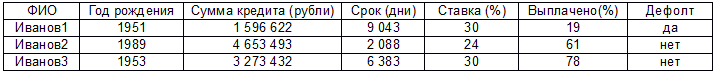
Дальше собственно код для решения следующей задачи. Есть реально большие данные (ибо рука очень устает скролить эти 2000 строк) в формате:
Маленький код для больших данных или Apache Spark за 3 дня - 1

Есть предположение, что дефолт как-то связан с остальными параметрами (кроме первого, к уважаемым Ивановым1…N претензий нет) и нужно построить модель линейной регрессии. Прежде чем начать, стоит оговориться, что это мой первый код на Java, сам я работаю аналитиком и вообще это мой первый запуск Eclipse, настройка Maven и т.д. Так что не стоит ждать изысканных чудес, ниже решение задачи в лоб тем способом, который почему-то заработал. Поехали:
Читать полностью »

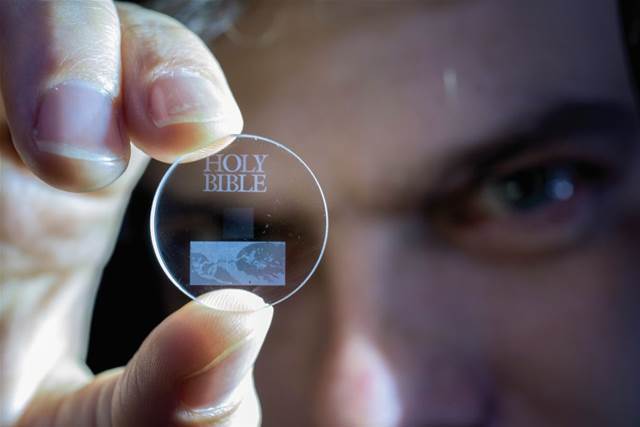
На этой неделе на Хабре уже вышла статья о вечной флешке. Мы хотели бы продолжить обсуждение, предоставив сборный материал из нескольких зарубежных источников, рассказывающих о бессмертном флеш-накопителе. Как известно, некоторое время назад ученые создали накопители нового поколения — наноструктурированные стекла, срок действия которых может составлять миллиарды лет. DVD-диски могут хранить рабочую информацию или семейные фотографии от 20 до 200 лет, но исследователи из Университета Саутгемптона считают, что хранить информацию на одном накопителе можно и дольше — до 13,8 млрд. лет. Примерно столько могут хранить информацию наноструктуры 5D из плавленого кварца — по сути, до конца самого человечества.

Информация на пороге бессмертия - 1 Читать полностью »

Во вторник, 29 ноября 2016 года DI Telegraph и Data-Centric Alliance проведут митап Art of Science.

Встреча любителей больших данных и искусства - 1

Art of Science – мероприятие, посвященное анализу данных в искусстве. Наука и искусство – что их связывает? Возможно ли взаимодействие этих двух разных миров? Можно ли с помощью big data, нейронных сетей и методов машинного обучения создавать что-то полезное и прекрасное? Как наука о данных может помочь в решении задач современного искусства? Об этом и многом другом расскажут наши спикеры, представители мира технологического «искусства».
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js