Рубрика «big data» - 86

Визуализация данных стала неотъемлемой частью жизни практически каждого веб-разработчика. Если построение графиков, диаграмм, карт и дашбордов до сих пор никогда не были вашей головной болью, просто немного подождите: наверняка и вы скоро вступите в наш «клуб».

Данная статья дает общее, но вовлеченное представление о восьми самых интересных, на мой взгляд, JavaScript-библиотеках для построения интерактивных геовизуализаций. В целом, таких решений сейчас много, и выбрать оптимальное под тот или иной конкретный проект – задача порой непростая как минимум по времени. Этой публикацией я попытаюсь хотя бы немного упростить жизнь тем, кто только начинает разбираться в данной теме. Кстати, это слегка модифицированный перевод моей недавней статьи на Onextrapixel (оригинал на английском).
Заглавная картинка: визуализация данных с помощью интерактивных картЧитать полностью »

Сравнение производительности аналитической СУБД Exasol и Oracle In-Memory Option - 1 Свою предыдущую статью я посвятил тому, как и на сколько можно ускорить аналитические (типовые для OLAP/BI систем) запросы в СУБД Oracle за счёт подключения опции In-Memory. В продолжение этой темы я хочу описать несколько альтернативных СУБД для аналитики и сравнить их производительность. И начать я решил с in-memory RDBMS Exasol.
Для тестов, результаты которых я публикую, выбран TPC-H Benchmark и при желании читатели могут повторить мои тесты.
Читать полностью »

Хабр, привет. Сегодня мы подготовили еще 12 примеров того, как технологии больших данных приносят компаниям деньги.
Читать полностью »

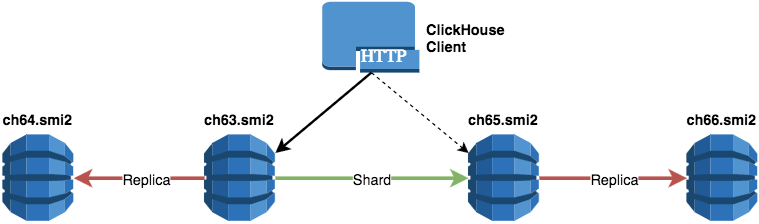
В предыдущей статье мы поделились своим опытом внедрения и использования СУБД ClickHouse в компании СМИ2. В текущей статье мы затронем вопросы масштабирования, которые возникают с увеличением объема анализируемых данных и ростом нагрузки, когда данные уже не могут храниться и обрабатываться в рамках одного физического сервера. Также мы расскажем о разработанном нами инструменте для миграции DDL-запросов в ClickHouse-кластер.

Два шарда по две реплики

Читать полностью »

Обзор (и видеозаписи) лучших докладов Java-конференции JPoint 2016: BigData, кишки JVM и паззлеры - 1

В апреле в Москве прошла JPoint 2016 – крупнейшая Java-конференция в России. Напомню, что на конференции было 50 докладов, которые шли в 4 треках в течение двух дней. В сентябре мы открыли доступ к видео для наших читателей, однако руки всё никак не доходили до публикации топ-10 докладов на Хабре.

Чтобы определить, какие спикеры понравились участникам конференции, мы собираем фидбеки, на основании которых получаем весьма достоверную взвешенную оценку для каждого из докладов.

Конечно, какие-то доклады оказываются лучше, какие хуже. Но в этом посте речь пойдет о 10 жемчужинах, лучших докладах, оценка каждого из которых оказалах выше 4.6 по пятибалльной шкале. Ссылка на остальные доклады по катом, так что вам будет чем заняться до Нового Года:)
Читать полностью »

Даже слон не выдержит столько данных

Постановка задачи

В одном из прошлых проектов мне была поставлена задача написания системы для хранения миллиардов записей. Доступ к данным должен осуществляться по ключу: одному ключу в общем случае соответствует множество (на практике, вплоть до десятков миллионов) записей, которые могут добавляться, но не модифицироваться или удаляться.

К такому количеству записей существующие SQL/NoSQL системы хранения оказались плохо приспособлены, поэтому клиент предложил с нуля разработать специализированное решение.

Читать полностью »

Хабр, привет.

Как вы знаете, для обучения глубоких нейронных сетей оптимально использовать машины с GPU. Наши образовательные программы всегда имеют практический уклон, поэтому для нас было обязательно, чтобы во время обучения у каждого участника была своя виртуальная машина с GPU, на которой он мог решать задачи во время занятий, а также лабораторную работу в течение недели. О том, как мы выбирали инфраструктурного партнера для реализации наших планов и подготавливали среду для наших участников, и пойдет речь в нашем посте.
Читать полностью »

Вебинар: Введение в Data Science - 1

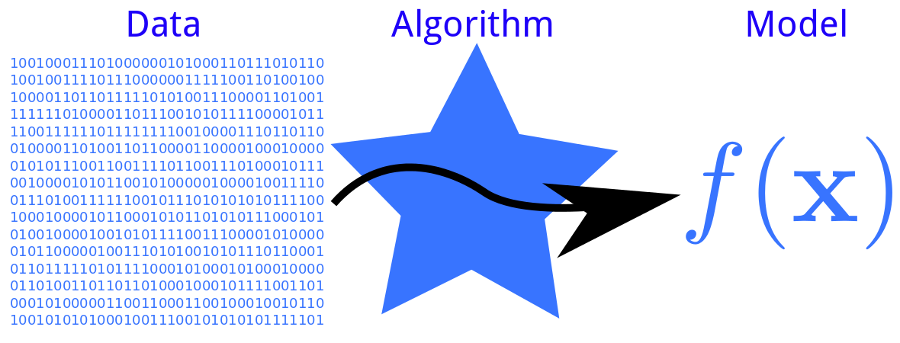
Команда FlyElephant приглашает всех 21 декабря в 18.00 (EET) на вебинар «Введение в Data Science». В его рамках мы рассмотрим на примерах, что такое Data Science, Data Mining, Machine Learning и Deep Learning, кто такой data scientist и какими инструментами он пользуется для сбора, хранения, обработки и визуализации данных. Поговорим о платформе FlyElephant и чем она может быть полезна для работы data scientist’а.

Зарегистрироваться на вебинар можно Читать полностью »

Нелинейная регрессия в Apache Spark. Разрабатываем своими руками - 1

При решении задач обработки сигналов часто применяют метод аппроксимации сырых данных моделью регрессии. Исходя из структуры, модели можно разделить на три типа – линейные, сводящиеся к линейным и нелинейные. В модуле машинного обучения «Spark ML» Apache Spark функционал для первых двух типов представлен классами LinearRegression и GeneralizedLinearRegression соответственно. Обучение нелинейных моделей в стандартной библиотеке не представлено и требует самостоятельной разработки.
Читать полностью »

Опрос Data Science Tools - 1

Хочу пригласить всех дата сайентистов принять участие в небольшом опросе об инструментахЧитать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js