
«Вспоминаю, как в 7-м классе ничего не понимал, когда мы начинали разбирать тригонометрию. С учителем мы не смогли найти общий язык, поэтому к 8–9-му классу я был уверен, что никогда не буду заниматься математикой, а уж тем более сидеть по несколько часов в день, утыкаясь в учебники Беклемишева или Кожевникова и параллельно просматривая лекции Физтеха…»
Рубрика «data science» - 7
Как полюбить математику и подружиться с ней на всю жизнь, если ты уже не школьник
2025-04-02 в 11:15, admin, рубрики: data science, аналитическая геометрия, линейная алгебра, матан, матанализ, математика, математика взрослому, математика для гуманитариев, математика на пальцах, математический анализПрименение роя агентов в криптовалютном телеграм боте
2025-03-30 в 15:18, admin, рубрики: Binance, data science, javascript, python, TypeScript, блокчейн, искуственный интеллект, Криптовалюты, машинное обучение, трейдингИсходный код, разобранный в статье, опубликован в этом репозитории
OpenAI развивает технологию роя агентов искусственного интеллекта, активная LLM модель переключается исходя из контекста поставленной задачи. Например, когда холодный контакт написал в личку телеграм, общение идёт приветливо и многословно, как только речь идет непосредственно о покупке товара, другая модель говорит минимально по делу
Все ли волки страшные: AUF или как приручить uplift?
2025-03-28 в 9:41, admin, рубрики: data science, machine learning, open source, python, uplift, uplift modeling, uplift modelling, библиотека, визуализации, метрикиВсем привет! Меня зовут Мельников Виктор, я работаю Junior Data Scientist в хабе Розничного Бизнеса Департамента Продвинутой Аналитики в Альфа-Банке. В этой статье я расскажу про AUF — Open Source библиотеку Альфа-Банка.
Её главная задача — автоматическое решение задач uplift-моделирования.
Позволяет ускорять разработку в десятки раз и убирает рутину, избавляя от привычного fit-predict. Приятным бонусом идёт полный отчёт по качеству модели, понятный как DS, так и бизнесу.
ДисклеймерЧитать полностью »
За гранью A-B: Синтетический контроль
2025-03-28 в 7:19, admin, рубрики: ab-тестирование, causal Inference, data analytics, data science, time series, аналитика данных, оценка эффекта, прогнозирование, продуктовая аналитикаПривет! Я Настя — лид A/B Платформы в Wildberries. На протяжении всего карьерного пути меня интересует тема оценки эффектов. Для этого существуют различные инструменты, в числе которых как A/B‑тестирование, так и альтернативные способы, например, различные вариации Causal Inference.
В этой статье я хочу поделиться примером проведения двух квази‑экспериментов в Wildberries с использованием Синтетического контроля (Synthetic Control).
Почему не А/B-тестирование?
Задача про n-ое число Фибоначчи
2025-03-18 в 7:15, admin, рубрики: data science, fibonacci, integer, ml, sequencesСуть моего труда заключается в том, чтобы определить функцию для нахождения n-ого числа Фибоначчи с линейной сложностью поиска. Вот какие методы я попробовал:
Возможно получится по простым данным постоить полином большой степени, используя метод неопределённых коэффициентов и использовать его для подсчёта последующих значений последовательности.
Читать полностью »Logit Lens & ViT model: туториал
2025-03-16 в 15:46, admin, рубрики: data analysis, data science, explainable ai, TransformersПривет!
В этом туториале разобран метод для анализа внутренних представлений "логит-линза" (Logit Lens).
В результате практики по туториалу, вы:
-
Изучите подход и концепцию Logit Lens;
-
Реализуете Logit Lens для Visual Transformer;
-
Познакомитесь с анализом результатов применения логит-линзы.
Приступим! Как всегда, весь код будет на гитхаб — step by step.
Logit Lens: о методе
Метод Logit Lens был предложен на Lessworng в 2020 году на примере модели GPT-2.
Неизвестный библейский алгоритм кластеризации
2025-03-11 в 21:00, admin, рубрики: data analysis, data science, кластеризация, философия
Времена когда горящий куст мог принести озарение давно прошли. Примитивный опыт уже не может стать источником открытий. А всё потому, что он обобщён и впитан в культуру человечества. И чтобы подключиться к мудрости предков нужно опереться на философию. В Читать полностью »
HaGRIDv2-1M: 1 миллион изображений для распознавания статичных и динамических жестов
2025-03-07 в 10:36, admin, рубрики: computer vision, data mining, data science, datasets, deep learning, detection, device control, gesture recognition, human-computer-interaction, neural networks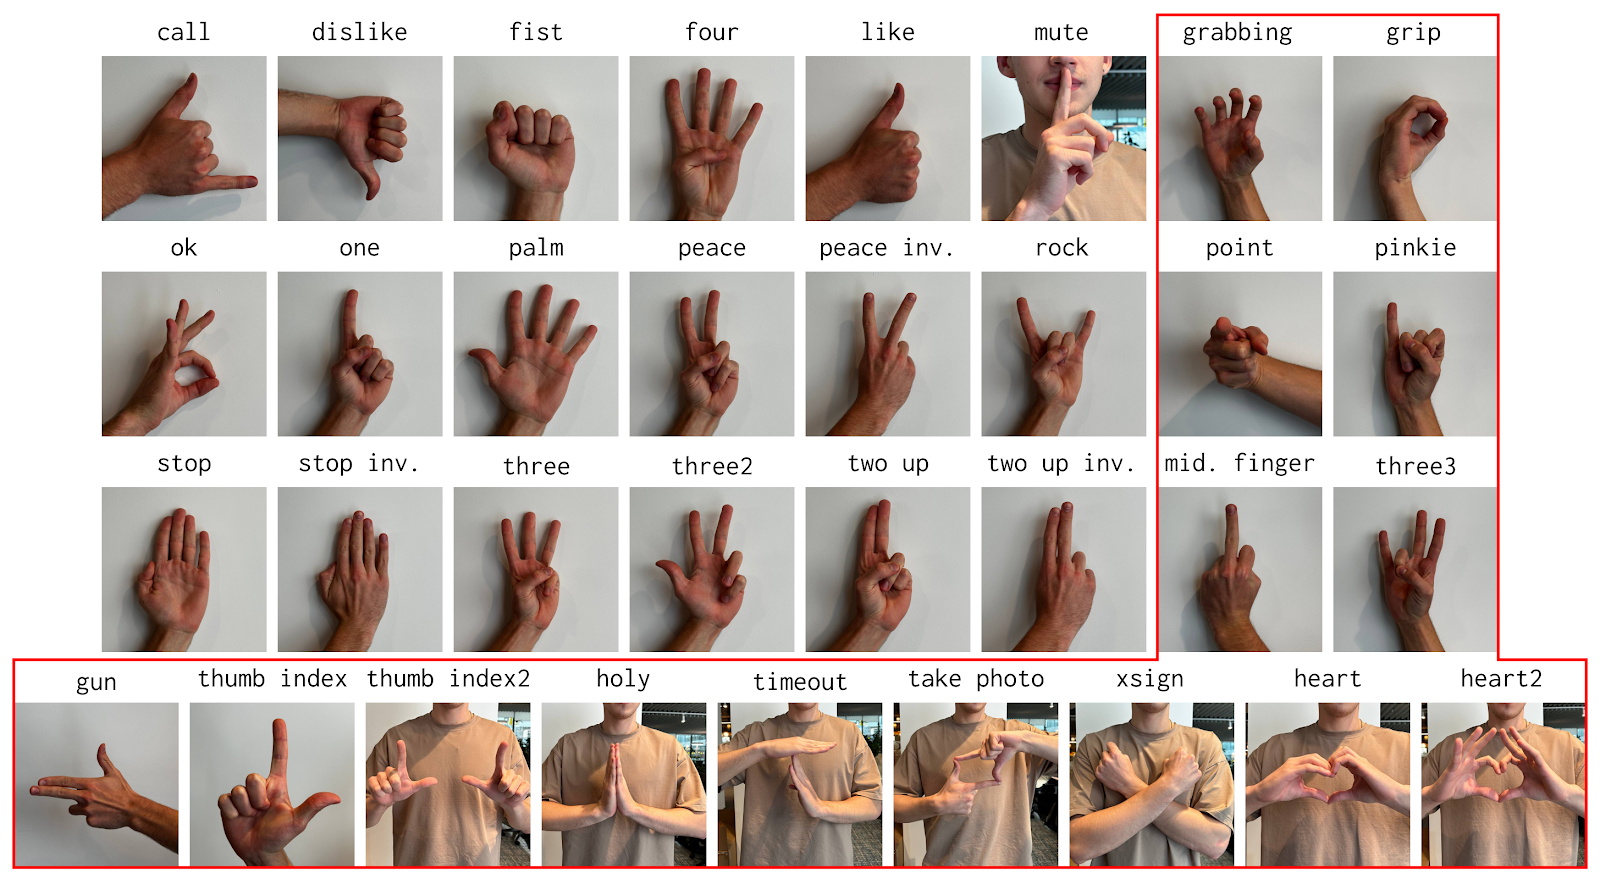
В этой статье мы представляем HaGRIDv2-1M — обновлённую и значительно расширенную версию HaGRID, самого полногоЧитать полностью »
Positional Bias: Что это такое и как с ним жить? Учимся правильно предсказывать CTR
2025-03-03 в 11:16, admin, рубрики: bias, CTR, data science, ml, recommendation systems, search engine, system designПривет! Сегодня поговорим про такого зверя, как positional bias. Если вы работаете с поисковыми системами или рекомендательными сервисами, то наверняка сталкивались с этой проблемой. Разберёмся на примере задачи по ml system design — предсказание вероятности клика по товару (известной как CTR — Click-Through Rate) в поисковой выдаче.
Описание задачи.
Вы владелец товарной платформы. На платформе продавцы могут продвигать товары за фиксированную ставку. Ставка взимается только в том случае, если был совершен клик по товару. У вас есть определенное количество свободных слотов для продвижения товаров. Читать полностью »
Куда расти Data Scientist и какие навыки для этого нужны
2025-02-24 в 12:00, admin, рубрики: big data, data science, карьера ИТ-специалиста, Учебный процесс в ITПривет! Меня зовут Никита Зелинский, я Chief Data Scientist МТС, руководитель центра компетенций Data Science и ML-платформ МТС Big Data. На конференциях я часто слышу один и тот же вопрос от начинающих дата-сайентистов: как развиваться в своей сфере и прийти к успеху? Тут сразу напрашивается одно сравнение — рост в профессии напоминает тренировки в качалке. Чтобы добиться результата, нужен четкий план: что конкретно и когда прокачивать. Вот и в работе важно понимать, какие навыки развивать и как составить стратегию роста — от стажера до ведущего специалиста или Chief Data Scientist.