Рубрика «big data» - 55

Всем привет! В этой статье мы продолжаем наш рассказ про ключевые анонсы конференции Build. Прошлый выпуск мы посвятили железячным анонсам (от облака до девкитов для разработчиков) и инструментам разработки. Сегодня мы расскажем про облако и ботов.

50 анонсов Build 2018. Часть 2. Azure & Bots - 1

В этом выпуске:

  • Обзор архитектуры Azure от Марка Руссиновича
  • Ключевые анонсы про Microsoft Azure
  • Обновления в инструментах для диалоговых интерфейсов
  • Alexa и Кортана: дружба-жвачка

Читать полностью »

Инженеров и компьютерных лингвистов – к «Диалогу» - 1С 30 мая по 2 июня в Российском государственном гуманитарном университете (РГГУ) пройдет 24-ая международная научная конференция по компьютерной лингвистике «Диалог». Мы уже рассказывали о том, что такое «Диалог» и почему ABBYY его основной организатор. В этом посте мы анонсируем основные темы конференции, ключевых спикеров и их доклады, публикуем информацию о соревнованиях по разрешению лексической многозначности на русском языке Dialogue Evaluation и другие подробности о конференции. Читать полностью »

Предисловие

Изучать что-то новое всегда интересно, это захватывает тебя полностью, по крайней мере у меня так. Вот и в этот раз, увлёкшись изучением программирования на языке Python, задался вопросом, где его можно применить, кроме как при создании фотосепаратора (статья про него будет чуть позже) и программы учета продаж, и натолкнулся на статью про большие данные (Big Data). Изучив материалы по Big Data, понял, что направление это весьма перспективно и стоит потратить время на его изучение.

Читать полностью »

Если менеджеру попытаться разобраться в этой области и получить конкретные бизнес-ответы, то, скорее всего, страшно заболит голова и екнет сердце от ощущения ежеминутно упускаемой выгоды.

"AlphaGo обыграл чемпиона по Go" впервые за всю историю человечества, скоро наши улицы заполонят беспилотные автомобили, распознавание лиц и голоса теперь в порядке вещей, а в квартиру к нам завтра постучатся AI-секс-куклы с грудью наивысшего размера с шампанским под мышкой и настраиваемым уровнем интенсивности и продолжительности оргазма.

Все оно так, но что делать-то прямо сейчас. Как на этом заработать в краткосрочной перспективе? Как заложить прочный фундамент на будущее?

Постараюсь дать исчерпывающие ответы на все мучающие вас вопросы, «вскрыть» подводные камни и, главное — здраво оценить риски в AI и научиться ими правильно управлять. Ведь то, что не понимаем, то и не “танцуем”.

Читать полностью »

Доброго времени суток, уважаемыее! В данной публикации речь пойдет о модели прогноза спроса на товары в сетевых магазинах и ее реализации на C++.

Постановка задачи

Допустим, у нас имеется сеть магазинов, в каждый из которых завозят товары. Товары (для модели прогноза) попадают в каждый магазин произвольным образом. За некий период времени мы имеем статистику — сколько в каждом магазине продано тех или иных товаров. Требуется спрогнозировать продажи товаров за период времени, аналогичный выбранному, для всех магазинов по всем товарам, которые в них не завозились.

Примечания и допущения постановки задачи

  • Товары, завезенные в магазины, не заканчивались за период сбора статистики.
  • Если в магазин завезли новые для него товары (при том, что старые товары остались), продажи не перераспределяться между старыми и новыми товарами. Статистика по старым товарам останется прежней, просто кто-то дополнительно покупает новые товары. Прогнозирование при невыполнении этого условия потребует дополнительных данных о том, как насыщается спрос при увеличении количества товаров.
  • Период, за который собирали статистику, и период, для которого нужно сделать прогноз, идентичны по спросу.

Читать полностью »

image

Привет. В этот раз снова о Data Science. Думаю, многим знакома методология CRISP-DM, о которой говорят на большинстве курсов, но вот про первый пункт (business understanding) информации достаточно мало, в зря, ведь он очень важный.

Поэтому в этой статье мы поговорим о взаимодействии с бизнесом и о том, какие обычно бывают проблемы и сложности в этом вопросе. Давайте разберем все на примере.Читать полностью »

Грузим терабайты бочками или SparkStreaming vs Spring+YARN+Java - 1

В рамках проекта интеграции GridGain и хранилища на базе Hadoop (HDFS + HBASE) мы столкнулись с задачей получения и обработки существенного объема данных, примерно до 80 Тб в день. Это необходимо для построения витрин и для восстановления удаленных в GridGain данных после их выгрузки в наше долговременное хранилище. В общем виде, можно сказать, что мы передаём данные между двумя распределёнными системами обработки данных при помощи распределённой системы передачи данных. Соответственно, мы хотим рассказать о тех проблемах, с которыми столкнулась наша команда при реализации данной задачи и как они были решены.

Так как инструментом интеграции является кафка (весьма подробно об этом инструменте описано в статье Михаила Голованова), естественным и легким решением тут выглядит использование SparkStreaming. Легким, потому что не нужно особо беспокоиться о падениях, переподключениях, коммитах и т.д. Spark известен, как быстрая альтернатива классическому MapReduce, благодаря многочисленным оптимизациям. Нужно лишь настроиться на топик, обработать батч и сохранить в файл, что и было реализовано. Однако в ходе разработки и тестирования была замечена нестабильность работы модуля приема данных. Для того чтобы исключить влияние потенциальных ошибок в коде, был произведен следующий эксперимент. Был выпилен весь функционал обработки сообщений и оставлено только прямое сохранение сразу в avro:
Читать полностью »

Пила Чурова своими руками, или как провести честные выборы - 1

На данном ресурсе с завидной регулярностью появляются статьи о выборах в России. Если тезисно передавать их суть, то получается что-то вроде:

  • Выборы в России фальсифицированы, и это аксиома, совершенно неоспоримый факт.
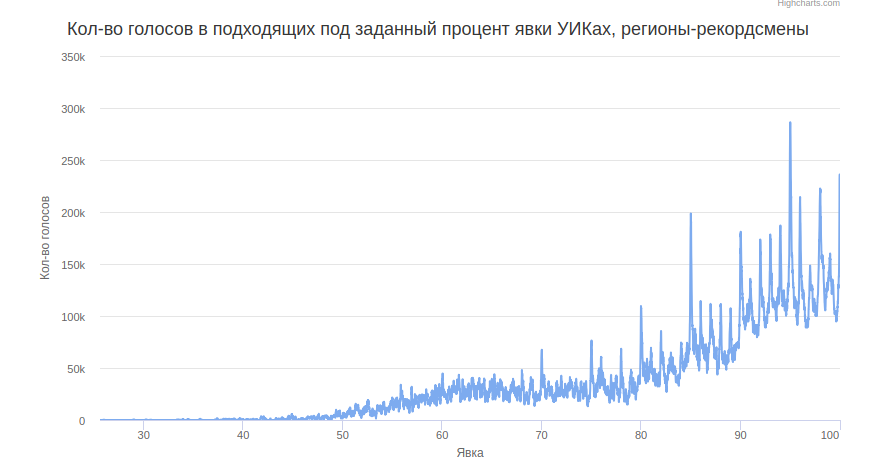
  • Признаки фальсификации — характерные «пики» на графиках около «круглых» чисел процентов явки либо голосов. Или некруглых, вроде «Пика Володина» на 62,2%.
  • А ещё признаки фальсификации — это отсутствие «колокола» на графиках, характерного для нормального распределения.

Примечательно, что любые попытки указать авторам статей на, откровенно говоря, спорность отдельных гипотез вызывают яростное минусование, слив кармы и выдавливание из дискуссии.

Поэтому, для проверки этих утверждений мы проведём свои, максимально честные выборы!
Читать полностью »

Графики с необычными пиками мы теперь видим после каждых федеральных выборов. Впервые в массы они вышли после выборов в 2011 году, когда люди и увидели фальсификации, и ознакомились в целом с анализом данных по выборам и с проблемой целочисленного деления в частности.

У распределений даже стали появляться свои имена. Это и «борода Чурова» для выборов 2011, и «пик Володина» для знаменитых 62.2% в Саратове. Поскольку до сих пор даже на хабре появляются статьи, не знакомые с решением проблемы целочисленного деления и не согласные "добавлять мусор" небольшой случайной добавки в данные, давайте посмотрим на результаты совсем иначе. Мы зайдём к построению графиков с противоположной стороны, где проблемы целочисленного деления вообще нет. И тоже увидим пики на целых значениях.

Нахождение числа комиссий, «рисовавших» целые значения явки на президентских выборах РФ 2018 года - 1

Читать полностью »

Летом 2017 года Китай обнародовал план стать мировым лидером в области ИИ, бросив вызов Соединенным Штатам, господствовавшим в этой технологии. В этом Китай не был одинок, президент Франции Эммануэль Макрон в интервью Wired Magazine заявил, что страна потратит почти 2 миллиарда долларов на исследования и разработки в области ИИ.
В рамках плана Китая по доминированию и созданию правил в сфере ИИ Министерство промышленности и информационных технологий Китая выпустило 28-страничный документ «Трехлетний план действий по развитию нового поколения индустрии искусственного интеллекта (2018-2020 годы)». В трехлетнем плане излагается агрессивный план Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js