Рубрика «big data» - 54

Отчет написан в декабре 2017.

It's not who has the best algorithm that wins. It's who has the most data. Побеждает не тот, у кого лучше алгоритм, а тот, у кого больше данных. Эндрю Нг, преподаватель курса по машинному обучению на Coursera.

If you scale up both the size of the model and the amount of data you train it with, you can learn finer distinctions or more complex features. …These models can typically take a lot more context. Jeff Dean, an engineer helping lead the research at Google. Если увеличить размер модели и дать ей больше данных для обучения, она начнет различать более тонкие и сложные особенности. …Эти модели обычно воспринимают более широкий контекст. Джеф Дин, инженер, помогающий в управлении исследованиями в Google.

Я тестировала Google Translate на одних и тех же текстах в марте и декабре 2011, январе 2016 и декабре 2017 года. Брала одни и те же отрывки на английском, русском, немецком, французском, украинском и польском языках и переводила каждый на остальные пять языков из выборки. Кроме того, в декабре 2017 дополнительно взяла новые тексты и протестировала во всех направлениях перевода. Результаты cross-verification в целом совпали с тенденциями в первоначальной выборке. В итоге получился срез работы переводчика Google за 2011 — 2017 годы, и на основе этих материалов можно сделать выводы об эволюции сервиса и прокомментировать маркетинговые заявления компании (цитаты планируется опубликовать отдельно).Читать полностью »
В мае 2018 года коллектив британских ученых провел тематическое исследование и выяснил, что траты на data scientist’ов (или экспертов по аналитическим данным) в Великобритании значительно увеличились. Мы решили разобраться в ситуации и дать краткий обзор.

Великобритания потратила £6 млн на data scientist’ов - 1Читать полностью »

Сколько сайтов вы используете ежедневно? Пару социальных сетей, поисковик, несколько любимых издательств, около 5 рабочих сервисов. Пожалуй, вряд ли наберется более 20 сайтов.

Как мы просканировали весь интернет и что мы узнали - 1

А задумывались ли вы сколько сайтов в интернете и что с ними происходит?
Читать полностью »

Как определить объем ваших логов? - 1

Добрый день!

Сегодня мы рассмотрим распространённый вопрос, с которым сталкиваются все, кто обрабатывает логи или собирается это делать и сейчас приценивается к различным решениям по обработке и хранению. Какой же объем логов в день/неделю/месяц мы будем получать из различных систем и какие ресурсы по хранению мы должны задействовать?
Однозначно точно сказать довольно сложно, но мы попробуем помочь вам примерно разобраться с предполагаемыми объемами, основываясь на нашем опыте.
Читать полностью »

Как создать свой датасет с Киркоровым и Фейсом на Яндекс Толоке - 1
Нейронными сетями уже никого не удивишь. Практически каждый человек знает, что такое машинное обучение, линейная регрессия, random forest. Каждый год тысячи людей проходят курсы по машинному обучению на ODS и Coursera. Любой школьник за пару недель теперь может освоить keras и клепать нейроночки. Но в нейронных сетях, как и во всем машинном обучении, помимо создания хорошего алгоритма, необходимы данные, на которых алгоритм будет обучаться.

Читать полностью »

Oh, My Code: Машинное обучение и аналитика в «Одноклассниках» - 1

В чём разница между Machine Learning и анализом данных, кто сидит в «Одноклассниках» и как начать свой путь в машинном обучении — об этом мы беседуем в двенадцатом выпуске ток-шоу для программистов.

Видео на канале Технострим

Ведущий программы — технический директор медиапроектов Павел Щербинин, гость — инженер-аналитик «Одноклассников» Дмитрий Бугайченко.
Читать полностью »

Как машины анализируют большие данные: введение в алгоритмы кластеризации - 1

Перевод How Machines Make Sense of Big Data: an Introduction to Clustering Algorithms.

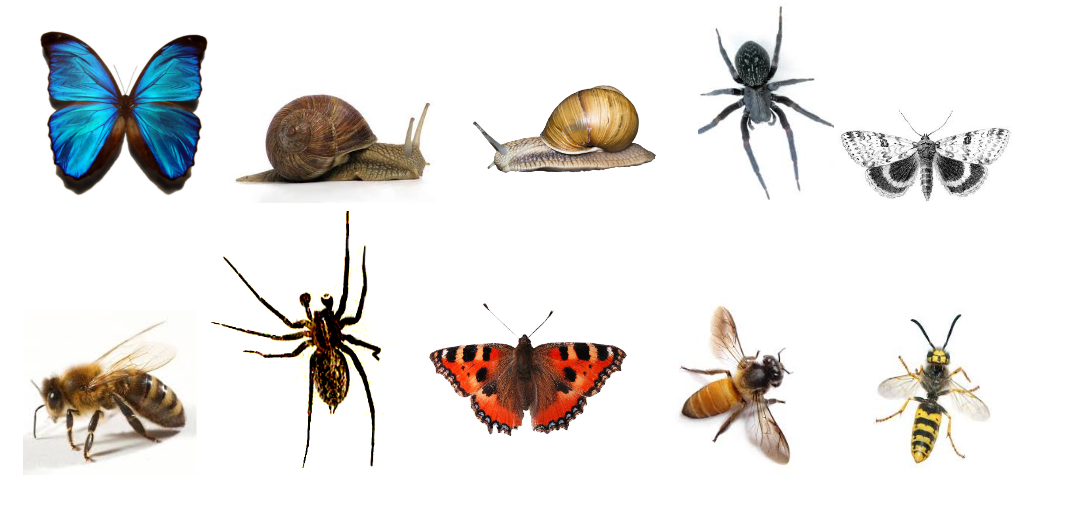
Взгляните на картинку ниже. Это коллекция насекомых (улитки не насекомые, но не будем придираться) разных форм и размеров. А теперь разделите их на несколько групп по степени похожести. Никакого подвоха. Начните с группирования пауков.

Как машины анализируют большие данные: введение в алгоритмы кластеризации - 2
Читать полностью »

В мире энтерпрайза наступило пресыщение фронтовыми системами, шинами данных и прочими классическими системами, которые внедряли все кому не лень последние 10-15 лет. Но есть один сегмент, который до недавнего времени был в статусе «все хотят, но никто не знает, что это». И это Big Data. Красиво звучит, продвигается топовыми западными компаниями – как не стать лакомым кусочком?

Распределенное хранилище данных в концепции Data Lake: с чего начать - 1

Но пока большинство только смотрит и приценивается, некоторые компании начали активно внедрять решения на базе этого технологического стека в свой IT ландшафт. Важную роль в этом сыграло появление коммерческих дистрибутивов Apache Hadoop, разработчики которых обеспечивают своим клиентам техническую поддержку. Ощутив необходимость в подобном решении, один из наших клиентов принял решение об организации распределенного хранилища данных в концепции Data Lake на базе Apache Hadoop.
Читать полностью »

Привет! Мы, наконец, дождались еще одной части серии материалов от выпускника наших программ “Специалист по большим данным” и “Deep Learning”, Кирилла Данилюка, об использовании популярных на сегодняшний день нейронных сетей Mask R-CNN как части системы для классификации изображений, а именно оценки качества приготовленного блюда по набору данных с сенсоров.

Рассмотрев в предыдущей статье игрушечный набор данных, состоящий из изображений дорожных знаков, теперь мы можем перейти к решению задачи, с которой я столкнулся в реальной жизни: «Возможно ли реализовать Deep Learning алгоритм, который мог бы отличить блюда высокого качества от плохих блюд по одной фотографии?». Вкратце, бизнес хотел вот это:

ConvNets. Создание прототипа проекта с помощью Mask R-CNN - 1

Что представляет бизнес, когда думает о машинном обучении:
Читать полностью »

image

Дисклеймер

Целью написания этой статьи было сделать краткий обзор принципов построения Интеллектуальных Систем Поддержки Принятия Решений (ИСППР), роли машинного обучения, теории игр, классического моделирования и примеров их использования в СППР. Целью статьи не является забуриться вглубь тяжелой теории автоматов, самообучаемых машин, равно как и инструментов BI.

Введение

Существет несколько определений ИСППР, которые, в общем-то, крутятся вокруг одного и того же функционала. В общем виде, ИСППР — это такая система, которая ассистирует ЛПР (Лицам, Принимающим Решения) в принятии этих самых решений, используя инструментарии дата майнинга, моделирования и визуализации, обладает дружелюбным (G)UI, устойчива по качеству, интерактивна и гибка по настройкам.

Зачем нужны СППР:

  1. Сложность в принятии решений
  2. Необходимость в точной оценке различных альтернатив
  3. Необходимость предсказательного функционала
  4. Необходимость мультипотокового входа (для принятия решения нужны выводы на основе данных, экспертные оценки, известные ограничения и т.п.)

Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js