Рубрика «big data» - 53

image

«Simplicity is prerequisite for reliability» by Edsger Dijkstra

Пролог

Графы — столь наглядная и проста для понимания структура данных, еще со времен Леонарда Эйлера заставляла ломать умы человечества над разнородными задачами, вроде того как можно пройти по всем семи мостам Кёнигсберга, не проходя ни по одному из них дважды или как разъездному посреднику, найти самый выгодный маршрут.
Читать полностью »
Машинное зрение – очень актуальная тема в наши дни. Для решения задачи по распознаванию магазинных ценников с использованием нейронных сетей мы выбрали фреймворк TensorFlow.

В статье пойдет речь именно о том, как с его помощью локализовать и идентифицировать несколько объектов на одном магазинном ценнике, а также распознать его содержимое. Похожая задача распознавания ценников IKEA уже решалась на Хабре с применением классических инструментов обработки изображений, доступных в библиотеке OpenCV.

Отдельно хотелось бы отметить, что решение может работать как на платформе SAP HANA в связке с Tensorflow Serving, так и на SAP Cloud Platform.

Задача распознавания цены товара актуальна и для покупателей, которые хотят «шарить» цены друг с другом и выбирать магазин для покупок, и для ритейлеров — они хотят узнавать про цены конкурентов в режиме реального времени.

Хватит лирики – гоу в технику!
Читать полностью »

«Это не радует. Мы и так соревнуемся с Kobalt, AWAL и Caroline — только Spotify не хватало», — прокомментировал директор одного из независимых лейблов планы Spotify на прямое лицензирование музыки. Ранее Spotify пообещал платить значительные суммы за прямую передачу прав на записи, напомнил Mooscle. Независимые артисты (и лейблы), при некоторых условиях, Читать полностью »

image

Что мешает успешно совместить математику и бизнес?

Этот текст — первая из серии статей о том, как корректно встроить инструменты big data с выгодой для бизнеса.

Маленький спойлер: все получится, если помнить о самом бизнесе.

Еще 5 лет назад крупные компании хотели внедрить у себя новомодную “бигдату”. Но настоящих экспериментаторов было мало. Исключениями стали те, кто точно обладал массой данных: телеком, банковский сектор, интернет-компании. А в 2018 году за экспертизой в больших данных бизнесы приходят сами, причем из самых неожиданных отраслей: металлургия, страхование, авиаиндустрия.Читать полностью »

Новый чемпионат ML Boot Camp VI. Прогноз отклика аудитории на интернет-опрос - 1

Сегодня, 25 июня, стартует ML Boot Camp VI с задачей «Прогноз отклика аудитории на интернет-опрос» (если вы вдруг впервые слышите, что такое ML Boot Camp, заходите под спойлер).
Читать полностью »

Привет! Меня зовут Сергей, я работаю главным инженером в Сбертехе. В ИТ-сфере я примерно 10 лет, из которых 6 занимаюсь базами данных, ETL-процессами, DWH и всем, что связано с данными. В этом материале я расскажу о Vertica — аналитической и по-настоящему колоночной СУБД, которая эффективно сжимает, хранит, быстро отдает данные и отлично подходит в качестве big data решения.

А нам все «вертикально» — СУБД Vertica - 1
Читать полностью »

По материалам моего доклада на конференции «Цифровая трансформация» в Москве 16 апреля 2018 г

Мне интересно, как работает блокчейн. Не только какие там алгоритмы, криптография, платформы и криптовалюты. Для меня блокчейн — не только технология, но и новый вид жизни, новая вселенная. Если вы в этом сомневаетесь, посмотрите на этот граф распродажи токенов Aragon:

Анализ блокчейн, или почему сломался миксер? - 1

Все эти адреса, смарт-контракты, токены постоянно взаимодействуют друг с другом, и за ними стоят действия людей, организаций и роботов. Без этого взаимодействия блокчейн и криптовалюты не имели бы никакого смысла и ценности.

Как работают бизнесы в блокчейн, что там делают люди и роботы — эти вопросы заставили меня заняться исследованием блокчейна.

Читать полностью »

На датафесте 2 в Минске Владимир Игловиков, инженер по машинному зрению в Lyft, совершенно замечательно объяснил, что лучший способ научиться Data Science — это участвовать в соревнованиях, запускать чужие решения, комбинировать их, добиваться результата и показывать свою работу. Собственно в рамках этой парадигмы я и решил посмотреть внимательнее на соревнование по оценке кредитного риска от Home Credit и объяснить (начинающим дата саентистам и прежде всего самому себе), как правильно анализировать подобные датасеты и строить под них модели.

Соревнование Kaggle Home Credit Default Risk — анализ данных и простые предсказательные модели - 1
Читать полностью »

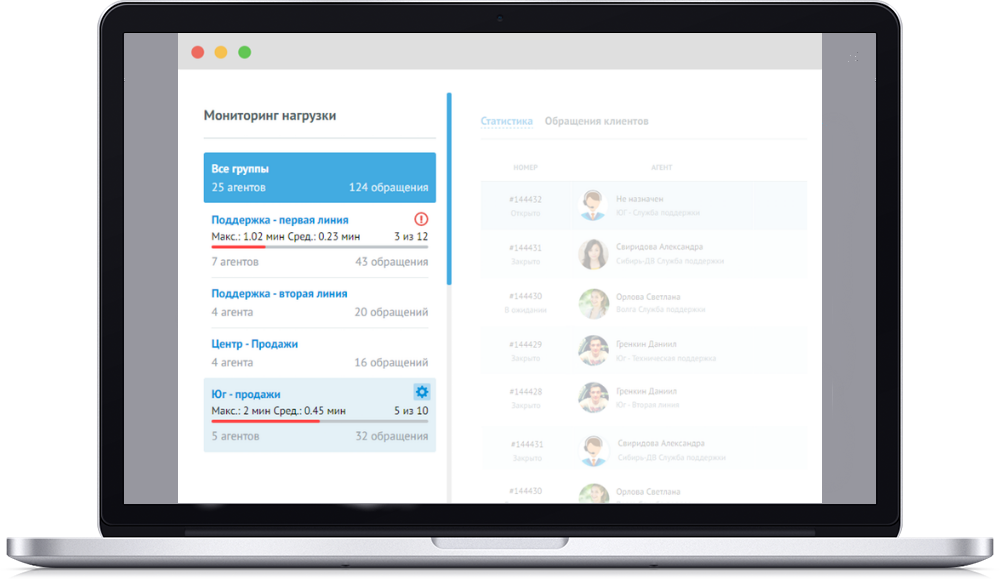
Мы в «Ростелекоме» давно задумывались о том, чтобы переводить голосовой клиентский сервис в digital-каналы текстового общения. Для небольших компаний задача выглядит несложно, но когда речь идет о службе из сотен, а в перспективе даже тысяч операторов поддержки, есть над чем задуматься. В этом посте мы расскажем, какое решение для этого нашли, что оно вообще собой представляет и позволяет делать. Спойлер: много чего.

Как мы переводим 36 млн клиентов на цифровой сервис техподдержки - 1
Читать полностью »

После прочтения статьи "Нейронный машинный перевод Google" вспомнился курсирующий последнее время в интернет очередной epic-fail машинного перевода от Google. Кому сильно не терпится сразу мотаем в низ статьи.

Ну а для начала немного теории:

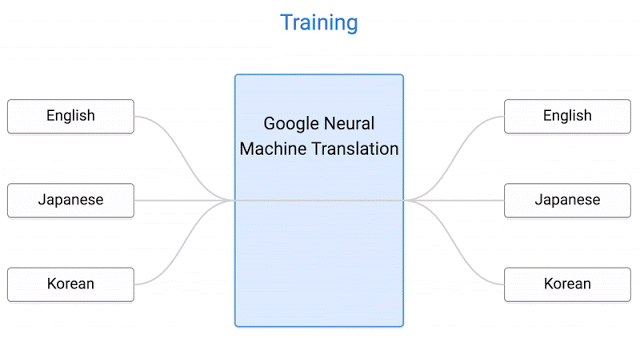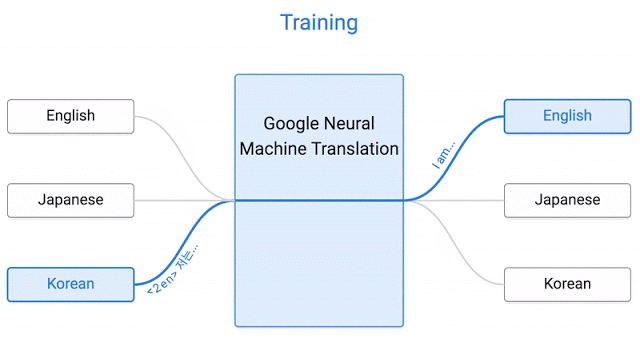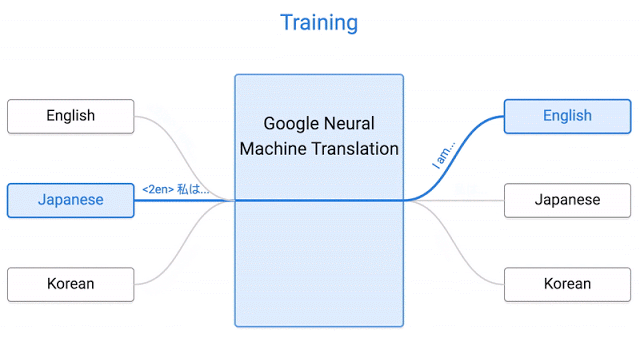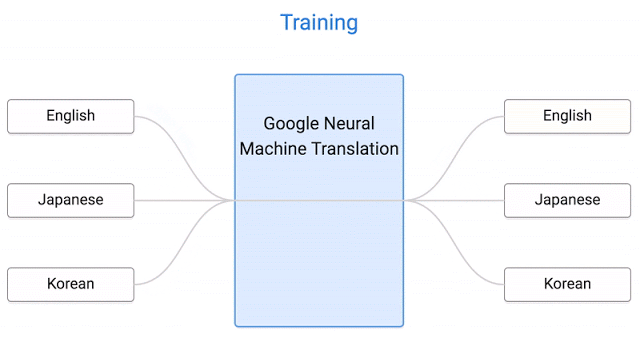
GNMT есть система нейронного машинного перевода (NMT) компании Google, которая использует нейросеть (ANN) для повышения точности и скорости перевода, и в частности для создания лучших, более естественных вариантов перевода текста в Google Translate.

В случае GNMT речь идет о так называемом методе перевода на основе примеров (EBMT), т.е. ANN, лежащая в основе метода, обучается на миллионах примеров перевода, причем в отличии от других систем этот метод позволяет выполнять так называемый zero-shot перевод, т. е. переводить с одного языка на другой, не имея явные примеры для этой пары конкретных языков в процессе обучения (в обучающей выборке).

Image 1. Zero-Shot Translation
Рис. 1. Zero-Shot Translation
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js