Банк — это по определению «кредитно-денежная организация», и от того, насколько успешно эта организация выдает и возвращает кредиты, зависит ее будущее. Чтобы успешно работать с кредитами, нужно понимать финансовое положение заемщиков, в чем помогают факторы кредитного риска (ФКР). Кредитные аналитики выявляют их в огромных массивах банковской информации, обрабатывают эти факторы и прогнозируют дальнейшие изменения. Обычно для этого используется описательная и диагностическая аналитика, но мы решили подключить к работе инструменты машинного обучения. О том, что получилось, читайте в посте.
Рубрика «big data» - 52
Машинное обучение против кредитных рисков, или «давай, Джини, давай»
2018-07-23 в 9:44, admin, рубрики: big data, Hadoop, Блог компании ВТБ, машинное обучение, финтех
Личный опыт: Data Engineering на Upwork
2018-07-20 в 22:33, admin, рубрики: big data, data engineering, data science, Upwork, карьера, Карьера в IT-индустрии, машинное обучение, фрилансЯ много лет работал Data Engineer'ом и Data Scientist'ом, решал сложные бизнес-кейсы, строил большие системы, выводил это все в продакшен. В начале 2017го я бросил пить, курить и работать в офисе и ушел фрилансить, экспериментировать с альтернативными формами занятости. Довольно много времени я провел на Upwork. Судя по многочисленным комментариям, уважаемая аудитория не до конца представляет себе, что это такое. Вещаю.
Upwork это крупнейшая в мире биржа фриланса. Дата сатанисты и дата инженеры мало кому в этом мире нужны (по сравнению с переводчиками, веб-мастерами и переписывателями текстов), так что задач для нас относительно мало, так что они тяготеют к крупнейшей бирже в мире. Других фриланс-бирж с постоянным потоком задач для дата саентистов в мире нет — ни Guru, ни Toptal, ни отечественный fl.ru спросом похвастаться не могут. Что важно — для специалистов более массовых специальностей опыт фриланса может сильно отличаться.Читать полностью »
4 года Data Science в Schibsted Media Group
2018-07-18 в 8:28, admin, рубрики: big data, data mining, data science, data scientist, okr, аналитика, карьера, машинное обучение, менеджер продуктов, причинно-следственные связи, причинность, прогнозирование, сложность, управление данными, управление командой, управление персоналом, Управление продуктом
В 2014-м году я присоединился к небольшой команде в Schibsted Media Group в качестве 6-го специалиста по Data Science в этой компании. С тех пор я поработал над многими начинаниями в области Data Science в организации, в которой теперь таких уже 40 с лишним человек. В этом посте я расскажу о некоторых вещах, о которых узнал за последние четыре года, сперва как специалист, а затем как менеджер Data Science.
Этот пост следует примеру Robert Chang и его отличной статьи «Doing Data Science in Twitter», которую я нашел очень ценной, когда впервые прочитал ее в 2015-м году. Цель моего собственного вклада ― поведать настолько же полезные мысли специалистам и менеджерам Data Science по всему миру.
Я поделил пост на две части:
- Часть I: Data Science в реальной жизни
- Часть II: Управление командой Data Science
Капсульные нейронные сети
2018-07-15 в 7:23, admin, рубрики: big data, алгоритм динамической маршрутизации, Алгоритмы, искусственный интеллект, Капсульные сети, математика, машинное обучение, нейронные сетиВ 2017 году Джеффри Хинтон (один из основоположников подхода обратного распространения ошибки) опубликовал статью, в которой описал капсульные нейронные сети и предложил алгоритм динамической маршрутизации между капсулами для обучения предложенной архитектуры.
У классических свёрточных нейронных сетей есть недостатки. Внутреннее представление данных сверточной нейронной сети не учитывает пространственные иерархии между простыми и сложными объектами. Так, если на изображении в случайном порядке изображены глаза, нос и губы для свёрточной нейронной сети это явный признак наличия лица. А поворот объекта ухудшает качество распознавания, тогда, как человеческий мозг легко решает эту задачу.
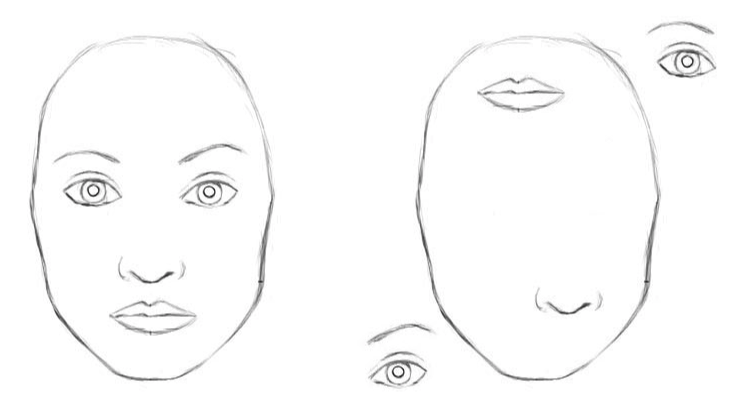
Для свёрточной нейронной сети 2 изображения схожи [2]
Читать полностью »
Интеграция Spark Streaming и Kafka
2018-07-13 в 13:39, admin, рубрики: big data, java, spark streaming, Блог компании Издательский дом «Питер», высокая производительность, интеграция, потоковая обработка данныхЗдравствуйте, коллеги! Напоминаем, что не так давно у нас вышла книга о Spark, а прямо сейчас проходит последнюю корректуру книга о Kafka.

Надеемся, эти книги окажутся достаточно успешными для продолжения темы — например, для перевода и издания литературы по Spark Streaming. Перевод об интеграции этой технологии с Kafka мы и хотели вам сегодня предложить
Читать полностью »
Splunk How-to, или Как и где научиться Splunk
2018-07-13 в 12:35, admin, рубрики: big data, splunk, Блог компании TS Solution, информационная безопасность, обучение, системное администрирование
В этой статье мы хотим поделиться с вами полезными материалами и ресурсами, с помощью которых можно научиться работать в Splunk. Понятно, что самый лучший опыт — это участие в проектах и набивание собственных шишек на практике, но все таки теория тоже важна. В этой статье мы расскажем как и где лучше изучать Splunk.
Читать полностью »
С точностью до сотых: топ-10 докладов SmartData 2017
2018-07-13 в 11:59, admin, рубрики: big data, data mining, SmartData, Блог компании JUG.ru Group, доклады, конференция
Зрители конференции SmartData — люди, которые любят работать с данными. Надо полагать, что и оценки докладам после прошлогодней конференции они выставляли очень вдумчиво.
А теперь по этим оценкам мы составили топ-10 видеозаписей. И заодно, чтобы порадовать любителей данных, указали по каждому из десяти докладов все сопутствующие числа: место в топе, точный зрительский рейтинг, количество зрителей.
Вообще говоря, зачастую у соседних позиций в топе рейтинги различаются незначительно. Так что, пожалуй, не стоит придавать много значения «кто идёт за кем» — важнее, что все эти доклады получили высокие оценки. Но с другой стороны, как же это не придавать много внимания числам, когда это так увлекательно!
Читать полностью »
RabbitMQ против Kafka: два разных подхода к обмену сообщениями
2018-07-10 в 8:17, admin, рубрики: Apache, big data, RabbitMQ, Блог компании ITSumma, высокая производительность, очередь сообщений, Системы обмена сообщениямиВ прошлых двух статьях мы рассказывали об IIoT — индустриальном интернете вещей — строили архитектуру, чтобы принимать данные от сенсоров, паяли сами сенсоры. Краеугольным камнем архитектур IIoT да и вообще любых архитектур работающих с BigData является потоковая обработка данных. В ее основе лежит концепция передачи сообщений и очередей. Стандартом работы с рассылкой сообщений сейчас стала Apache Kafka. Однако, для того, чтобы разобраться в ее преимуществах (и понять ее недостатки) было бы хорошо разобраться в основах работы систем очередей в целом, механизмах их работы, шаблонах использования и основной функциональности.
Мы нашли отличную серию статей, которая сравнивает функциональность Apache Kafka и другого (незаслуженно игнорируемого) гиганта среди систем очередей — RabbitMQ. Эту серию статей мы перевели, снабдили своими комментариями и дополнили. Хотя серия и написана в декабре 2017 года, мир систем обмена сообщениями (и особенно Apache Kafka) меняется так быстро, что уже к лету 2018-го года некоторые вещи изменились.
Чек-лист по анализу логов событий безопасности
2018-07-06 в 7:33, admin, рубрики: big data, linux, Log Management, security, windows, Блог компании TS Solution, информационная безопасность, Серверное администрирование
Сегодня тема мониторинга IT – инфраструктуры и анализа логов набирает все большую и большую популярность. В первую очередь все задумываются о мониторинге событий безопасности, о чем и будет идти речь в данной статье. Несмотря на то, что на эту тему сказано и написано уже довольно много, вопросов возникает еще больше. И поэтому мы решили сделать перевод статьи «Сritical Log Review Checklist for Security Incidents», написанную Anton Chuvakin и Lenny Zeltser, которая будет полезна как для тех, кто только начинает работать с мониторингом событий безопасности, так и для тех, кто имеет с этим дело довольно давно, чтобы еще раз проверить себя, не упускаете ли вы некоторые возможности.
Читать полностью »
Откуда взялись нейросети и что происходит сейчас
2018-07-06 в 6:54, admin, рубрики: AI, api, AR, AR и VR, azure, big data, jedium, lms, microsoft, ml, VR, Блог компании Microsoft, искусственный интеллект, машинное обучение, нейронные сети, нейросети, облакоВ последние несколько лет тема искусственного интеллекта активно обсуждается, так как один из подходов к ее изучению активно набирает обороты среди крупных корпораций. Этот подход – нейросети. Еще недавно, около года назад, это слово можно было услышать отовсюду. Сегодня рассмотрим историю изучения искусственного интеллекта человечеством (оказывается, ему уже около 2000 лет) и сегодняшние реалии.