Рубрика «big data» - 75

Recent Advances in Algorithms

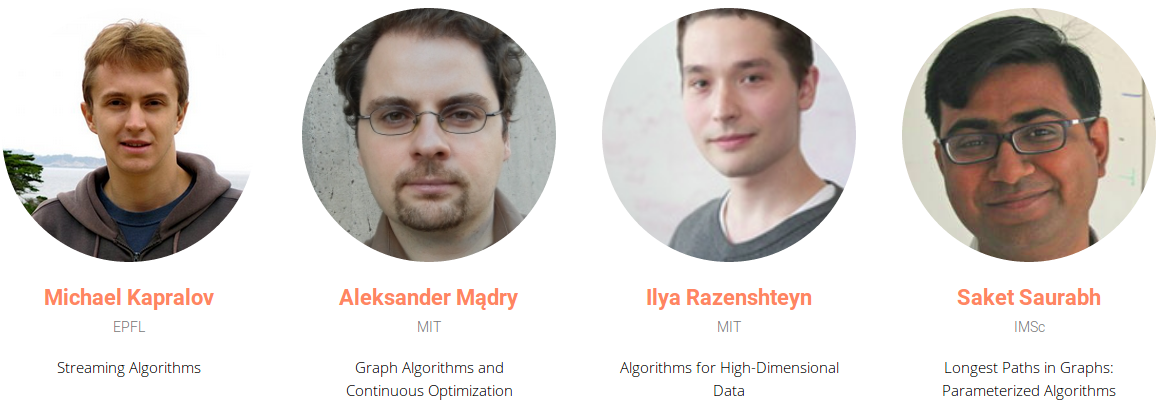
В конце мая в Петербурге в ПОМИ РАН прошла международная студенческая школа «Recent Advances in Algorithms». Идея школы заключалась в том, чтобы ведущие учёные рассказали о последних достижениях в области алгоритмов. В результате у нас получился следующий список курсов.

Список лекторов
Читать полностью »

Отчет с Moscow Data Science Meetup 31 мая - 1

31 мая Moscow Data Science Meetup собрал в нашем офисе более 200 участников. На встрече мы поговорили о градиентном бустинге, бейзлайне на ConvAI.io и разобрали кейс, получивший 7-е место из 419 команд на конкурсе Dstl Satellite Imagery Feature Detection. Предлагаем вашему вниманию видеозаписи и презентации трёх докладов, представленных на встрече.

Читать полностью »

image

24 июня мы собираем специалистов по Data Science в нашем офисе, чтобы обменяться опытом в создании рекомендательных сервисов. На встрече мы подведём итоги проходившего на площадке Dataring.ru конкурса Avito на построение рекомендательной системы для объявлений: наградим победителей и попросим их подробнее рассказать о своих решениях. Кроме того, в программе интересные доклады от представителей Яндекс.Дзена, OZON.ru и, конечно же, Avito. Подробности под катом!
Читать полностью »

Привет коллеги.
Да, не прошло и три года с первой статьи, но проектная пучина отпустила только сейчас. Хочу с вами поделиться своими соображениями и проблемами касательно Spark streaming в связке с Kafka. Возможно среди вас есть люди с успешным опытом, поэтому буду рад пообщаться в комментариях.
Читать полностью »

AgeHack — первый онлайн-хакатон по продлению жизни на платформе MLBootCamp - 1

Сегодня, 15 июня, стартует чемпионат на платформе ML Boot Camp, посвященный проблемам здравоохранения и долголетия человечества. Чемпионат организован нами совместно с Insilico Medicine в сотрудничестве с Республиканским центром электронного здравоохранения при Министерстве здравоохранения Республики Казахстан. О том, почему это не очень обычный для нас конкурс — под катом.

Читать полностью »

Dropout — метод решения проблемы переобучения в нейронных сетях - 1

Переобучение (overfitting) — одна из проблем глубоких нейронных сетей (Deep Neural Networks, DNN), состоящая в следующем: модель хорошо объясняет только примеры из обучающей выборки, адаптируясь к обучающим примерам, вместо того чтобы учиться классифицировать примеры, не участвовавшие в обучении (теряя способность к обобщению). За последние годы было предложено множество решений проблемы переобучения, но одно из них превзошло все остальные, благодаря своей простоте и прекрасным практическим результатам; это решение — Dropout (в русскоязычных источниках — “метод прореживания”, “метод исключения” или просто “дропаут”).
Читать полностью »

Хабр, нам тут пришла одна идея… В настоящий момент у нас возникло некое межсезонье между разными образовательными программами. Мы подумали, зачем нашей инфраструктуре зря простаивать, когда есть люди, которые могли бы на этой инфраструктуре что-то классное сделать.

Мы решили сделать небольшой вклад в развитие deep learning в России и выделить 3 виртуальных сервера с GPU тем, кто что-то делает в этой области. 2 виртуалки мы решили отдать нашим выпускникам, а 1 виртуалку дать в пользование кому-то «со стороны».

image

Читать полностью »

Всем привет!

Я снова буду рассказывать о геоинформационных технологиях.
Этой статьей я начинаю серию о технологиях на стыке миров классических ГИС и все еще модного направления BigData. Я расскажу о ключевых особенностях применения распределенных вычислений к работе с геоданными, а также сделаю краткий обзор существующих инструментов.

Сегодня нас окружает огромное количество неструктурированных данных, которые до недавнего времени было немыслимо обработать. Примером таких данных могут служить, например, данные метеодатчиков, используемые для точного прогноза погоды. Более структурированные, но не менее массивные датасеты – это, например, спутниковые снимки (алгоритмам обработки снимков c помощью машинного обучения даже посвящен ряд статей у сообщества OpenDataScience). Набор снимков высокого разрешения, допустим, на всю Россию занимает несколько петабайт данных. Или история правок OpenStreetMap — это терабайт xml. Или данные лазерного сканирования. Наконец, данные с огромного количество датчиков, которыми обвешано множество техники – от дронов до тракторов (да, я про IoT). Более того, в цифровую эпоху мы сами создаем данные, многие из которых содержат в себе информацию о местоположении. Мобильная связь, приложения на смартфонах, кредитные карты – все это создает наш цифровой портрет в пространстве. Множества этих портретов создают поистине монструозные наборы неструктурированных данных.

ГИС и распределенные вычисления - 1
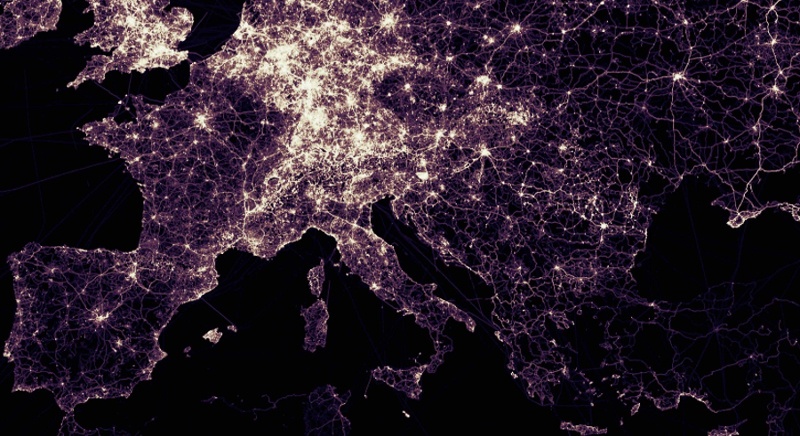
На рисунке — визуализация треков OpenStreetMap с помощью GeoWave

Где стык ГИС и распределенных вычислений? Что такое «большие геоданные»? Какие инструменты помогут нам? Читать полностью »

или Перерастает ли количество в качество

Статья по мотивам выступления на конференции РИФ+КИБ 2017.

Neural Machine Translation: почему только сейчас?

Про нейронные сети говорят уже давно, и, казалось бы, что одна из классических задач искусственного интеллекта – машинный перевод – просто напрашивается на то, чтобы решаться на базе этой технологии.

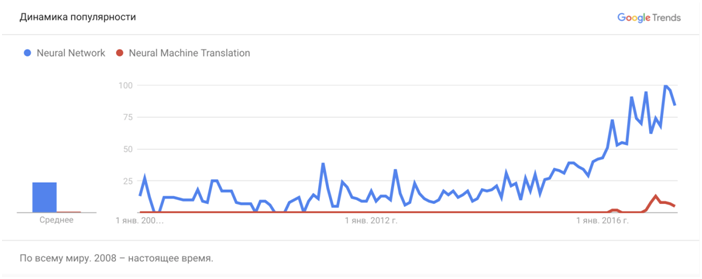
Тем не менее, вот динамика популярности в поиске запросов про нейронные сети вообще и про нейронный машинный перевод в частности:
image

Прекрасно видно, что на радарах вплоть до недавнего времени нет ничего про нейронный машинный перевод – и вот в конце 2016 года свои новые технологии и системы машинного перевода, построенные на базе нейронных сетей, продемонстрировали сразу несколько компаний, среди которых Google, Microsoft и SYSTRAN. Они появились почти одновременно, с разницей в несколько недель или даже дней. Почему так?

Для того, чтобы ответить на этот вопрос, необходимо понять, что такое машинный перевод на базе нейронных сетей и в чем его ключевое отличие от классических статистических систем или аналитических систем, которые используются сегодня для машинного перевода.

Читать полностью »

В предыдущей статье — часть 1, обзорная — я рассказал о том, зачем нужны распределенные структуры данных (далее — РСД) и разобрал несколько вариантов, предлагаемых распределенным кешем Apache Ignite.

Сегодня же я хочу рассказать о подробностях реализации конкретных РСД, а также провести небольшой ликбез по распределенным кешам.

Итак:

Распределенные структуры данных (часть 2, как это сделано) - 1

Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js