Рубрика «data mining» - 52

Сообщество Open Data Science приветствует участников курса!

В рамках курса мы уже познакомились с несколькими ключевыми алгоритмами машинного обучения. Однако перед тем как переходить к более навороченным алгоритмам и подходам, хочется сделать шаг в сторону и поговорить о подготовке данных для обучения модели. Известный принцип garbage in – garbage out на 100% применим к любой задаче машинного обучения; любой опытный аналитик может вспомнить примеры из практики, когда простая модель, обученная на качественно подготовленных данных, показала себя лучше хитроумного ансамбля, построенного на недостаточно чистых данных.
Открытый курс машинного обучения. Тема 6. Построение и отбор признаков - 1

Читать полностью »

Привет! За последние годы новые подходы в обучении нейронных сетей позволили существенно расширить сферы практического применения машинного обучения. А появление большого количества хороших высокоуровневых библиотек дало возможность проверить свои навыки специалистам разного уровня подготовки.

Имея некоторый опыт в машинном обучении, я до текущего момента не имел дело конкретно с нейронными сетями. На волне их стремительной популярности было принято решение заполнить данный пробел и заодно попробовать написать об этом статью.

Я поставил себе две цели. Первая, придумать задачу, достаточно сложную чтобы при её решении столкнуться с проблемами, возникающими в реальной жизни. И вторая, решить эту задачу с использование одной из современных библиотек, разобравшись с особенностями работы с ними.

В качестве библиотеки был выбран TensorFlow. А за задачей и её решением прошу под кат…
Читать полностью »

Модели Word2Vec

Как было упомянуто в первой части публикации, модели получаются из classes — представления результата текста word2vec виде ассоциативно-семантических классов путем сглаживания распределений.
Идея сглаживания в следующем.
Читать полностью »

Не прошло и полгода, как мы завершаем цикл статей об адаптивном обучении на Stepik! А, нет, прошло… Но я рада наконец представить вашему вниманию заключительную статью о том, зачем вообще нужно адаптивное обучение, как оно реализовано на Stepik и причём тут шахматы.

Рекомендательные системы в онлайн-образовании. Адаптивное обучение - 1

Читать полностью »

Глубинное обучение по особенностям заголовка и содержимого статьи для преодоления кликбейта - 1
Облако слов для кликбейта

TL;DR: Я добился точности распознавания кликбейта 99,2% на тестовых данных по особенностям заголовка и контента. Код доступен в репозитории GitHub.

Когда-то в прошлом я написал статью о выявлении кликбейта. Та статья получила хорошие отклики, а также много критики. Некоторые сказали, что нужно учитывать содержимое сайта, другие просили больше примеров из разных источников, а некоторые предложили попробовать методы глубинного обучения.

В этой статье я постараюсь решить эти вопросы и вывести выявление кликбейта на новый уровень.
Читать полностью »

Предсказываем будущее с помощью библиотеки Facebook Prophet - 1

Прогнозирование временных рядов — это достаточно популярная аналитическая задача. Прогнозы используются, например, для понимания, сколько серверов понадобится online-сервису через год, каков будет спрос на каждый товар в гипермаркете, или для постановки целей и оценки работы команды (для этого можно построить baseline прогноз и сравнить фактическое значение с прогнозируемым).

Существует большое количество различных подходов для прогнозирования временных рядов, такие как ARIMA, ARCH, регрессионные модели, нейронные сети и т.д.

Сегодня же мы познакомимся с библиотекой для прогнозирования временных рядов Facebook Prophet (в переводе с английского, "пророк", выпущена в open-source 23-го февраля 2017 года), а также попробуем в жизненной задаче – прогнозировании числа постов на Хабрехабре.

Читать полностью »

Существует огромное количество алгоритмов кластеризации. Основная идея большинства из них – объединить одинаковые последовательности в один класс или кластер на основе сходства. Как правило, выбор алгоритма определяется поставленной задачей. Что касается текстовых данных, то здесь сравниваемыми составляющими служат последовательности слов и их атрибутов (например, вес слова в тексте, тип именованной сущности, тональность и пр.). Таким образом, тексты изначально преобразуются в вектора, с которыми производят разного типа манипуляции. При этом, как правило, возникает ряд проблем, связанных с: выбором первичных кластеров, зависимостью качества кластеризации от длины текста, определением общего количества кластеров и т.п. Но наиболее сложной проблемой является отсутствие связи между близкими по смыслу текстами, в которых используется разная лексика. В таких случаях объединение должно происходить не только на основе сходства, а еще и на основе семантической смежности или ассоциативности.
Кластеризация текстовых документов по семантическим признакам (часть первая: описание алгоритма) - 1
Читать полностью »

Введение

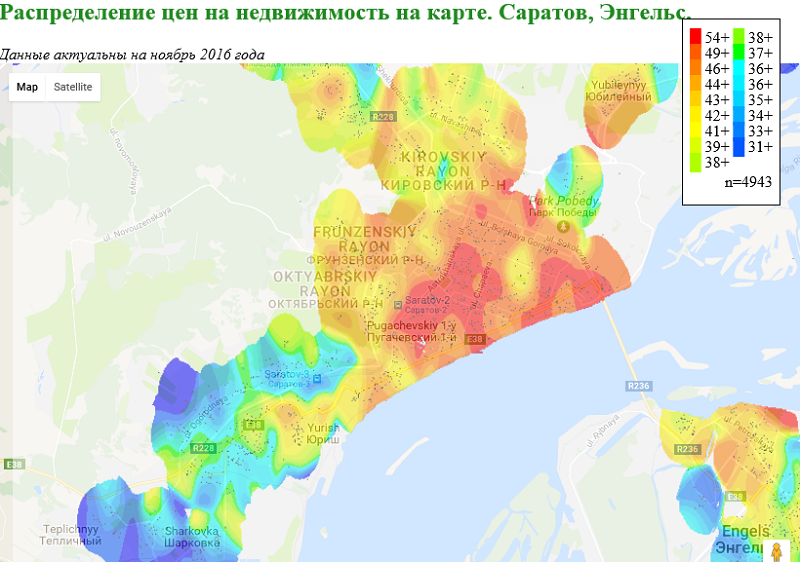
Начну с конца. Это скриншот с некой web-карты, визуализирующей среднюю стоимость недвижимости на вторичном рынке Саратова и Энгельса:

Статистика по стоимости недвижимости — визуализация на карте - 1

Цвета на карте можно соотнести с цветами на «легенде», цвет на «легенде» соответствует средней стоимости квадратного метра общей площади в тысячах рублей.

Точка на карте соответствует одному предложению по продаже (на вторичном рынке) квартиры с Авито. Всего таких точек, как видно на «легенде», для построения графика использовалось 4943.
Карта в интерактивном виде доступна на GitHub.

А теперь немного предыстории..

Давным-давно…
Читать полностью »

Multidimensional Space Trading Strategies
Рис. 1. Оптимизация многомерного пространства алгоритмов торговых стратегий.

Оптимизация торговых стратегий

В процессе алгоритмической торговли постоянно возникает необходимость настройки параметров алгоритмов торговых стратегий. Сочетания всех возможных параметров превращается в большое многомерное пространство вариантов стратегий. Чтобы получить самые прибыльные и стабильные стратегии нужно исследовать это пространство и подобрать оптимальные параметры для торговли.
Читать полностью »

Всем доброго времени, друзья.

Введение

Когда мы думаем о биоинформатике, мы обычно представляем себе какие-нибудь сложные последовательности ДНК, фолдинг белка или, на худой конец, моделирование диффузии вируса.

В данной же статье речь пойдёт несколько о другой теме, куда более близкой, можно сказать, машинному зрению и анализу документов, или даже прикладной автоматизации, чем высокой науке. Но на самом деле, тема важна и актуальна, хотя бы уже потому, что существует в очень интересной экологической нише.

КДПВ:

Common Bird Census, или биоинформатика в орнитологии. Проект в хорошие руки - 1

Кого заинтересовал — прошу под кат.
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js