Рубрика «data mining» - 51

Всем привет!

Открытый курс машинного обучения. Тема 8. Обучение на гигабайтах с Vowpal Wabbit - 1

Вот мы постепенно и дошли до продвинутых методов машинного обучения, сегодня обсудим, как вообще подступиться к обучению модели, если данных гигабайты и десятки гигабайт. Обсудим приемы, позволяющие это делать: стохастический градиентный спуск (SGD) и хэширование признаков, посмотрим на примеры применения библиотеки Vowpal Wabbit. Домашнее задание будет как на реализацию SGD-алгоритмов, так и на обучение классификатора вопросов на StackOverflow по выборке в 10 Гб.

Поехали!
Читать полностью »

Обычно модели машинного обучения строят в jupyter-ноутбуках, код которых выглядит, мягко говоря, не очень — длинные простыни из лапши выражений и вызовов "на коленке" написанных функций. Понятно, что такой код почти невозможно поддерживать, поэтому каждый проект переписывается чуть ли не с нуля. А о внедрении этого кода в production даже подумать страшно.

Поэтому сегодня представляем на ваш строгий суд превью библиотеки по работе с датасетами и data science моделями. С ее помощью ваш код может выглядеть так:

my_dataset.
    load('/some/path').
    normalize().
    resize(shape=(256, 256, 256)).
    random_rotate(angle=(-30, 30))
    random_crop(shape=(64, 64, 64))

for i in range(MAX_ITER):
    batch = my_dataset.next_batch(BATCH_SIZE, shuffle=True)
    # обучаем модель, подавая ей батчи с данными    

В этой статье вы узнаете об основных классах и методах, которые помогут сделать ваш код простым, понятным и удобным.

Читать полностью »

Недавно мы писали приложение на Shiny, где нужно было использовать очень большой блок данных (dataframe). Это непосредственно влияло на время запуска приложения, поэтому пришлось рассмотреть ряд способов чтения данных из файлов в R (в нашем случае это были csv-файлы, предоставленные заказчиком) и определить лучший.

Цель этой заметки — сравнить:

  1. read.csv из utils — стандартный способ чтения csv-файлов в R
  2. read_csv из readr, который в RStudio заменил предыдущий метод
  3. load и readRDS из base, и
  4. read_feather из feather и fread из data.table.

Читать полностью »

Прошло достаточно времени с упоминания в предыдущей публикации об использовании RStudio Connect в боевых условиях для того, чтобы поделиться результатами. Краткое резюме — «дайте два!». И подумайте про оптимизацию отдела «аналитиков». Ниже приведены подробности.

В качестве дополнительного чтения рекомендую взглянуть детальную публикацию «Data at GDS (Government Digital Service). Reproducible Analytical Pipeline» в блоге аналитической службы гос.органов UK по аналогичной теме.

Читать полностью »

Привет всем! Приглашаем изучить седьмую тему нашего открытого курса машинного обучения!

Открытый курс машинного обучения. Тема 7. Обучение без учителя: PCA и кластеризация - 1 Данное занятие мы посвятим методам обучения без учителя (unsupervised learning), в частности методу главных компонент (PCA — principal component analysis) и кластеризации. Вы узнаете, зачем снижать размерность в данных, как это делать и какие есть способы группирования схожих наблюдений в данных.Читать полностью »

Привет! Предлагаем вам перевод поста “Getting Started with Deep Learning” от Мэтью Рубашкина из Silicon Valley Data Science о преимуществах и недостатках существующих Deep Learning технологий и о том, какой фреймворк выбрать, учитывая специфику задачи и способности команды.

image

Читать полностью »

О линейной регрессии: байесовский подход к курсу рубля - 1
Не секрет, что курс рубля напрямую зависит от стоимости нефти (и от кое-чего еще). Этот факт позволяет строить довольно интересные модели. В своей статье о линейной регрессии я коснулся некоторых вопросов, посвященных диагностике модели, а за кадром остался такой вопрос: есть ли более эффективная, но не слишком сложная альтернатива линейной регрессии? Традиционно используемый метод наименьших квадратов прост и понятен, но есть и другие подходы (не такие понятные).

Читать полностью »

Школа данных: Москва, Питер… онлайн - 1
Привет,

Можно ли с помощью данных управлять миром? Ну, ответ, очевиден. Вопрос в том, как…

Все уже слышали об успехе компании CambridgeAnalytica в предвыборной гонке Трампа и небезызвестного Brexit.

Статья собрала большое количество поклонников. В ней рассказаны потрясающие результаты, которых позволяет добиться современная аналитика. Однако, эти результаты достижимы только при соблюдении определенных нюансов, о которых умолчали авторы статьи и о которых мы хотели бы рассказать. Эти нюансы могут превратить данную задачу из легко решаемой в невозможную или наоборот.
Читать полностью »

В этом посте речь пойдет о том, как я восстанавливал демографические данные для регионов Дании, где после реформы территориального устройства 2007 года официальной гармонизации данных не проводилось. Это лишь небольшая часть гармонизации евростатовских данных, которую я выполнил в рамках своего phd проекта. Пост сперва опубликован в моем англоязычном блоге и в блоге Demotrends. Думаю, что он может быть интересен далеко не только демографам.

Что такое NUTS?

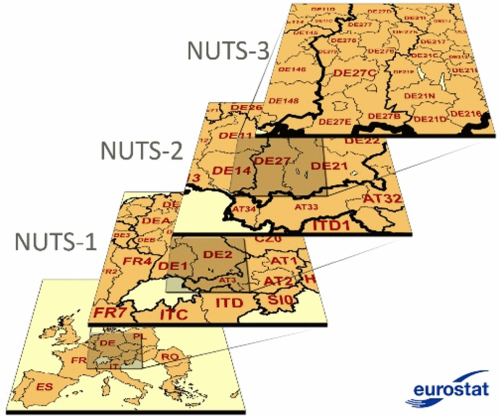
NUTS расшифровывается как Nomenclature of Territorial Units For Statistics. Это стандартизированная система административно-территориального деления, принятая странами Евросоюза. История вопроса уходит в 1970-е, когда родилась идея сделать регионы различных стран Европы сопоставимыми. В более или менее законченном и широко употребимом виде система появилась лишь на рубеже веков. Существуют три основных уровня NUTS (см. рис. 1), и наиболее распространенным в региональном анализе оказывается NUTS-2.

fig1
Рисунок 1. Иллюстрация принципа выделения регионов NUTS различного иерархического уровня

Читать полностью »

На сегодняшний день технологии Big Data нашли свое применение практически в любых отраслях: ритейл, банкинг, здравоохранение, и, в свою очередь, сфера производства не стала исключением. Оптимизация производственной цепочки, выявление дефектов и контроль качества продукции, улучшение удобства использования продукта на основе поведения потребителей – неполный список результатов, которых можно достичь в производственной сфере благодаря Big Data. Рассмотрим несколько кейсов зарубежных и отечественных компаний, внедривших технологии больших данных в свою деятельность.
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js