Рубрика «data science» - 40

Прошло достаточно времени с упоминания в предыдущей публикации об использовании RStudio Connect в боевых условиях для того, чтобы поделиться результатами. Краткое резюме — «дайте два!». И подумайте про оптимизацию отдела «аналитиков». Ниже приведены подробности.

В качестве дополнительного чтения рекомендую взглянуть детальную публикацию «Data at GDS (Government Digital Service). Reproducible Analytical Pipeline» в блоге аналитической службы гос.органов UK по аналогичной теме.
Читать полностью »

Добрый день! В этой статье я хотел бы вкратце рассказать о решении которое принесло мне первое место на конкурсе по машинному обучению ML Boot Camp III от mail.ru.
Читать полностью »

image

На прошлой неделе прошла встреча кейс-клуба Data Science, на которой специалисты Avito рассказали о том, какие бизнес-задачи сервиса решаются с помощью машинного обучения. В частности поговорили про рекомендации, контекстную рекламу и модерацию. Под катом больше подробностей о встрече и видеозаписи докладов.

Читать полностью »

Привет!

Библиотеки для глубокого обучения Theano-Lasagne - 1

Параллельно с публикациями статей открытого курса по машинному обучению мы решили запустить ещё одну серию — о работе с популярными фреймворками для нейронных сетей и глубокого обучения.
Я открою этот цикл статьёй о Theano — библиотеке, которая используется для разработки систем машинного обучения как сама по себе, так и в качестве вычислительного бекэнда для более высокоуровневых библиотек, например, Lasagne, Keras или Blocks.

Theano разрабатывается с 2007 года главным образом группой MILA из Университета Монреаля и названа в честь древнегреческой женщины-философа и математика Феано (предположительно изображена на картинке). Основными принципами являются: интеграция с numpy, прозрачное использование различных вычислительных устройств (главным образом GPU), динамическая генерация оптимизированного С-кода.

Читать полностью »

Видео, доклады и краткий отчет для тех, кто не приехал и не успел посмотреть прямую трансляцию.

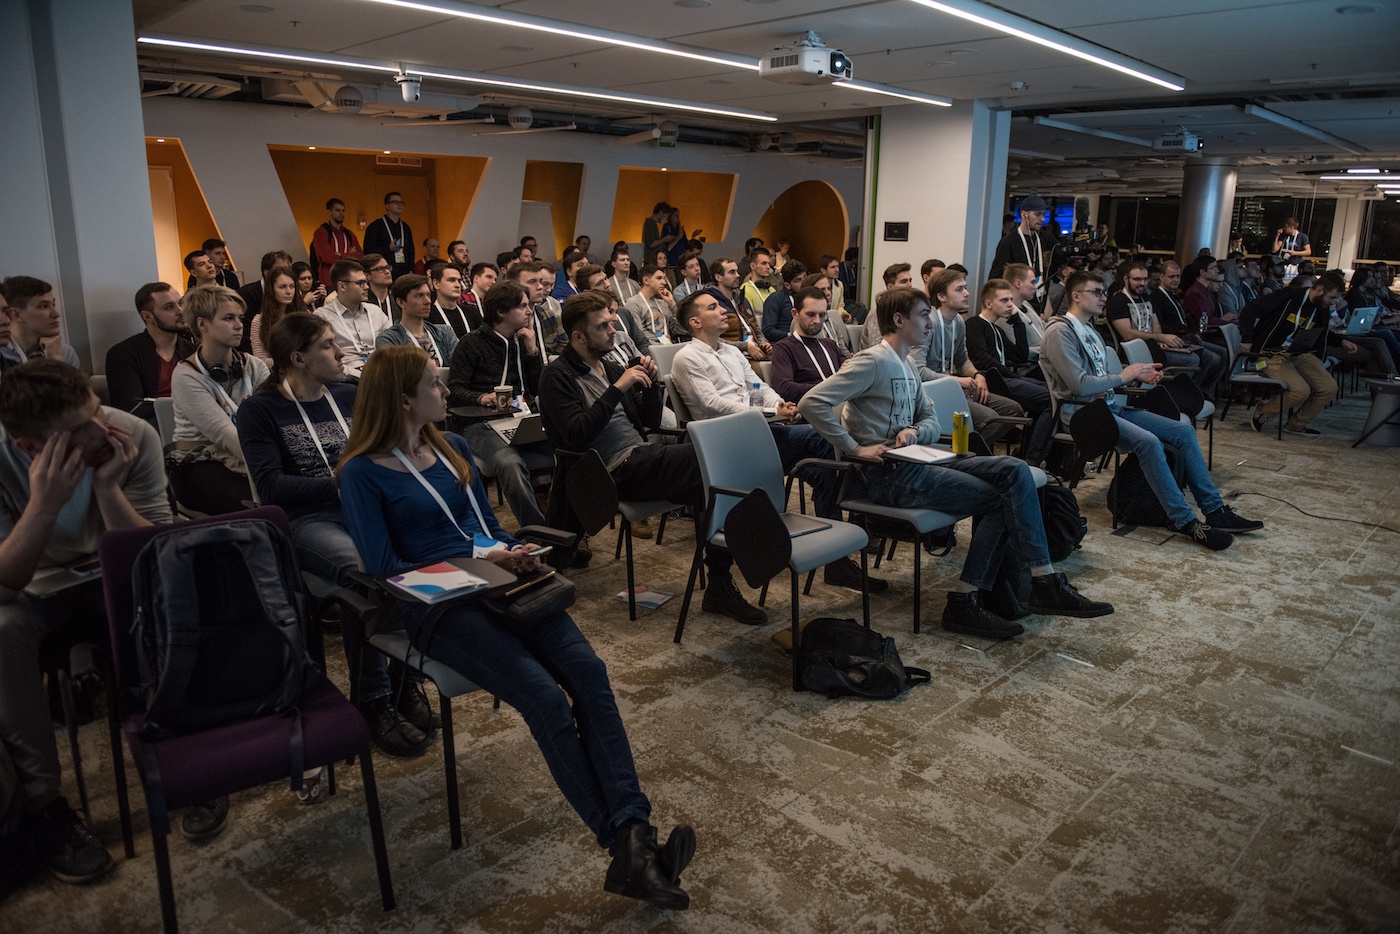
В офисе Superjob состоялся Data Science Meetup. Послушать доклады пришли около ста аналитиков и разработчиков, включая специалистов из Renault, Тинькофф банк, Эльдорадо, SAP, Вымпелком, Delloite, ВТБ и тд. Около 500 человек смотрели прямую трансляцию.

image
Читать полностью »

Цель статьи — познакомить широкую аудиторию с соревнованиями по анализу данных на Kaggle. Я расскажу о своем подходе к участию на примере Outbrain click prediction соревнования, в котором я принимал участие и занял 4ое место из 979 команд, закончив первым из выступающих в одиночку.
Для понимания материала желательны знания о машинном обучении, но не обязательны.
Читать полностью »

Открытый курс машинного обучения. Тема 2: Визуализация данных c Python - 1

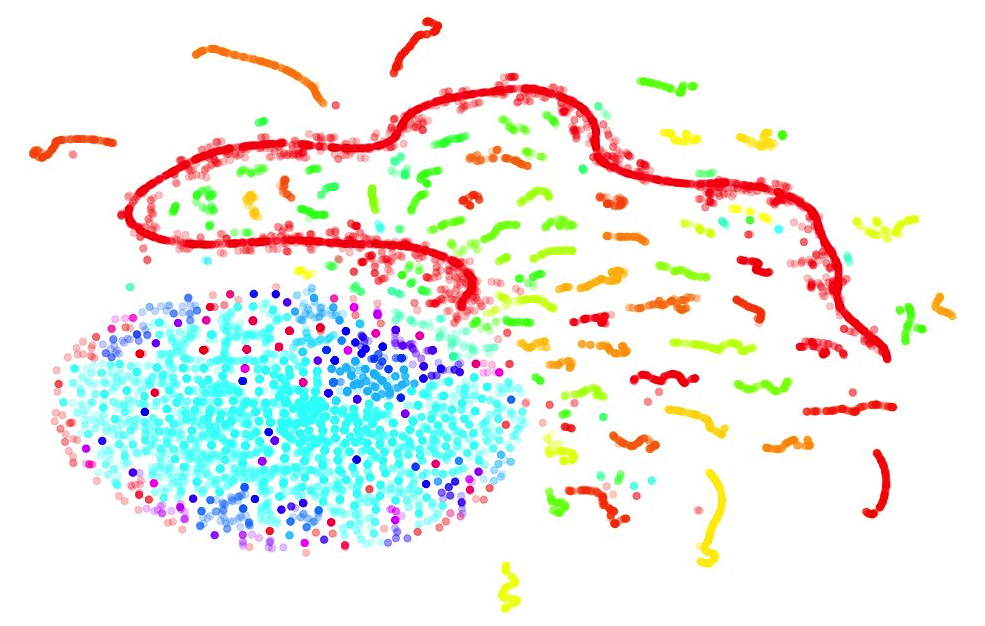
Привет всем, кто начал проходить курс! Новые участники, добро пожаловать! Второе занятие посвящено визуализации данных в Python. Сначала мы посмотрим на основные методы библиотек Seaborn и Plotly, затем поанализируем знакомый нам по первой статье набор данных по оттоку клиентов телеком-оператора и подглядим в n-мерное пространство с помощью алгоритма t-SNE.

Напомним, что к курсу еще можно подключиться, дедлайн по 1 домашнему заданию – 6 марта 23:59.

Сейчас статья уже будет существенно длиннее. Готовы? Поехали!

Читать полностью »

Специально для тех, кто не успел зарегистрироваться на Superjob Data Science Meetup, мы организуем прямую трансляцию события на Youtube или Facebook.

Начало в 19:00 по московскому времени.
image
Читать полностью »

Довольно часто enterprise задачи по обработке данных затрагивают данные, сопровождаемые временной меткой. В R такие метки, обычно хранятся как класс POSIXct. Выбор методов работы с таким типом данных по принципу аналогии может привести к большому разочарованию и убеждению о крайней медлительности R. Хотя если взглянуть на эту чуть более пристально, то оказывается, что дело не совсем в R, а в руках и голове.

Ниже затрону пару кейсов, которые встретились в этом месяце и возможные варианты их решения. В ходе решения появляются весьма интересные вопросы. Заодно упомяну инструменты, которые оказываются крайне полезными для решения подобных задачек. Практика показала, что об их существовании знают немногие.

Читать полностью »

Старт открытого курса OpenDataScience

Привет всем, кто ждал запуска открытого курса по практическому анализу данных и машинному обучению!

Открытый курс машинного обучения. Тема 1. Первичный анализ данных с Pandas - 1

Первая статья посвящена первичному анализу данных с Pandas.

Пока в серии планируется 7 статей, идущих вместе с тетрадками Jupyter (репозиторий mlcourse_open), соревнованиями и домашними заданиями.

Далее идет список будущих статей, описание курса и собственно, первая тема – введение в Pandas.

Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js