Рубрика «data science» - 39

16 мая в Университете ИТМО состоялся семинар, посвященный теме машинного обучения. Приглашенный лектор, заведующий кафедрой высокопроизводительных компьютерных технологий Уральского федерального университета Андрей Созыкин, рассказывал о профессии специалиста по Data science и направлениях развития этой сферы в ближайшем будущем.

В сегодняшнем материале — выдержки из интервью с лектором и рассказ о том, что нужно знать и уметь будущему специалисту по работе с данными.

Как стать специалистом по Data science: итоги открытого семинара в Университете ИТМО - 1Читать полностью »

Интересно, но такая область как профессиональное развитие остается немного в стороне от шума из-за data science. Стартапы в сфере HRtech только начинают наращивать обороты и увеличивать свою долю, замещая традиционный подход в сфере работы с профессионалами или, теми, кто хочет стать профессионалом.

Сфера HRtech очень разнообразна и включает в себя автоматизацию найма сотрудников, развитие и коучинг, автоматизацию внутренних HR процедур, отслеживание рыночных зарплат, трекинг кандидатов, сотрудников и многое другое. Данное исследование помогает с помощью методов анализа данных ответить на вопрос как взаимосвязаны навыки, какие есть специализации, какие навыки более популярны, а какие навыки следует изучить следующим.

Читать полностью »

image

Привет!

В последнее время все чаще приходится наблюдать, что ожидания работодателей и потенциальных ученых по данными сильно отличаются. Компания, инвестируя в новые разработки в первую очередь ждет возврат на инвестиции, а не очередную модель. Специалист же, окончивший всевозможные курсы ждет на вход чистые и понятные данные, а на выходе хотел бы отдать модель прикрепив к ней метрики качества. А дальше «пусть менеджеры разбираются», как это все будет встроено в процесс и как именно полученная модель будет использоваться. В результате возникает пропасть и непонимание между бизнесом и учеными.

По факту оказывается, что модели сами по себе никому не нужны, а на деле приходится заниматься очень большим количеством рутинных задач.

Хотелось бы на обобщенных примерах (все совпадения с реальной жизнью случайны) показать, какие же на самом деле трудности приходится преодолевать, чтобы принести работодателю деньги. Наверное, после этого в аналитику данных люди будут идти более осознанно, попутно получая нужные для работы навыки, а не изучая очередную статью про алгоритм.
Читать полностью »

Нейрокурятник часть ноль. Или нейро- без курятника. Или как правильно закоптиться в нейросети.

image
Курочка снесла яичко. Сам процесс выглядит ужасно. Результат — съедобно. Массовый геноцид кур.
В этой статье будет описано:

  1. Где, как и почему можно получить небольшое качественное самообразование в сфере работы с нейросетями БЕСПЛАТНО, СЕЙЧАС и СОВСЕМ НЕ БЫСТРО;
  2. Будет описана логика рекурсии и будут порекомендованы книги по теме;
  3. Будет описан список основных терминов, которые нужно разобрать на 2-3 уровня абстракции вниз;
  4. Будет приведен ipynb-notebook, который содержит необходимые ссылки и базовые подходы;
  5. Будет немного своеобразного саркастичного юмора;
  6. Будут описаны некоторые простые закономерности, с которыми вы столкнетесь при работе с нейросетями;

Статьи про нейрокурятник

Заголовок спойлера

  1. Вступление про обучение себя нейросетям
  2. Железо, софт и конфиг для наблюдения за курами
  3. Разметка датасетов
  4. Параллельное участие в соревнованиях, визуализации внутренностей нейросетей, развитие архитектур моделей
  5. Работающая модель для распознавания кур в курятнике
  6. Бот, который постит события из жизни кур

Читать полностью »

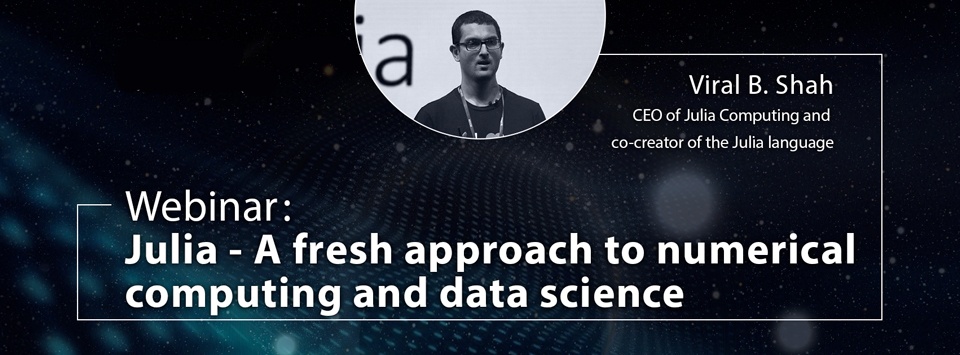
Видеозапись вебинара «Julia — A fresh approach to numerical computing and data science» - 1

Команда FlyElephant в марте проводила вебинар с со-основателем и CEO в Julia Computing, а также со-автором языка Julia — Viral B. Shah, на тему "Julia — A fresh approach to numerical computing and data science".

Читать полностью »

Меня зовут Пётр Ромов, я — data scientist в Yandex Data Factory. В этом посте я предложу сравнительно простой и надежный способ начать карьеру аналитика данных.

Многие из вас наверняка знают или хотя бы слышали про Kaggle. Для тех, кто не слышал: Kaggle — это площадка, на которой компании проводят конкурсы по созданию прогнозирующих моделей. Её популярность столь велика, что часто под «кэглами» специалисты понимают сами конкурсы. Победитель каждого соревнования определяется автоматически — по метрике, которую назначил организатор. Среди прочих, Kaggle в разное время опробовали Facebook, Microsoft и нынешний владелец — Google. Яндекс тоже несколько раз отметился. Как правило, Kaggle-сообществу дают решать задачи, довольно близкие к реальным: это, с одной стороны, делает конкурс интересным, а с другой — продвигает компанию как работодателя с солидными задачами. Впрочем, если вам скажут, что компания-организатор конкурса задействовала в своём сервисе алгоритм одного из победителей, — не верьте. Обычно решения из топа слишком сложны и недостаточно производительны, а погони за тысячными долями значения метрики не настолько и нужны на практике. Поэтому организаторов больше интересуют подходы и идейная часть алгоритмов.
Спортивный анализ данных, или как стать специалистом по data science - 1

Kaggle — не единственная площадка с соревнованиями по анализу данных. Существуют и другие: DrivenData, DataScience.net, CodaLab. Кроме того, конкурсы проводятся в рамках научных конференций, связанных с машинным обучением: SIGKDD, RecSys, CIKM.

Для успешного решения нужно, с одной стороны, изучить теорию, а с другой — начать практиковать использование различных подходов и моделей. Другими словами, участие в «кэглах» вполне способно сделать из вас аналитика данных. Вопрос — как научиться в них участвовать?

Читать полностью »

Приглашаем на IV конференцию по практическому применению науки о данных DataScience Lab 13 мая - 1

Команда FlyElephant приглашает всех 13 мая в Одессу на IV конференцию по практическому применению науки о данных Data Science Lab (exAI&BigDataLab).

Data Science Lab — это ежегодная техническая конференция, которая объединяет исследователей, инженеров и разработчиков, связанных с Data Science для обмена опытом и обсуждения актуальных тем в области машинного обучения, обработки естественного языка, распознавания образов и других аспектов анализа данных. Темы докладов раскрывают вопросы от практического внедрения результатов исследований до самых последних теоретических разработок.
Читать полностью »

Сегодня мы подготовили для вас дайджест, в котором постарались собрать самые интересные литературные источники, статьи, видеокурсы и лекции (в том числе подготовленные силами преподавателей, студентов и сотрудников Университета ИТМО), которые позволят познакомиться с Data Science.

Эти материалы затрагивают как теоретические аспекты работы с данными, так и практические — направленные на создание алгоритмов и написание программ.

Дайджест Университета ИТМО: материалы для тех, кто хочет влиться в Data Science - 1Читать полностью »

image

В последние несколько лет курсы по Data Science стали, наверное, самыми популярным направлением онлайн-образования: десятки предложений можно найти на Coursera, edX, а для освоения анализа данных на базовом уровне появились даже специальные проекты, посвященные лишь этой дисциплине (например, DataCamp). В этой подборке мы собрали самые интересные курсы по Data Science на различных платформах. Для вашего удобства мы внимательно изучили отзывы – как на сайтах самих образовательных провайдеров, так и на сторонних порталах, где оцениваются преимущества и недостатки тех или иных курсов и специализаций. Поскольку количество курсов огромно, мы сделали акцент на тех, что предлагают научить слушателя целому комплексу навыков – например, в случае Coursera речь пойдет не об отдельных курсах (даже в области Data Science их число приближается к сотне, а содержание многих дублирует друг друга), а о специализациях.

Читать полностью »

Обычно модели машинного обучения строят в jupyter-ноутбуках, код которых выглядит, мягко говоря, не очень — длинные простыни из лапши выражений и вызовов "на коленке" написанных функций. Понятно, что такой код почти невозможно поддерживать, поэтому каждый проект переписывается чуть ли не с нуля. А о внедрении этого кода в production даже подумать страшно.

Поэтому сегодня представляем на ваш строгий суд превью библиотеки по работе с датасетами и data science моделями. С ее помощью ваш код может выглядеть так:

my_dataset.
    load('/some/path').
    normalize().
    resize(shape=(256, 256, 256)).
    random_rotate(angle=(-30, 30))
    random_crop(shape=(64, 64, 64))

for i in range(MAX_ITER):
    batch = my_dataset.next_batch(BATCH_SIZE, shuffle=True)
    # обучаем модель, подавая ей батчи с данными    

В этой статье вы узнаете об основных классах и методах, которые помогут сделать ваш код простым, понятным и удобным.

Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js