
На одной из встреч Программного комитета конференции разработчиков высоконагруженных систем HighLoad++Читать полностью »
На одной из встреч Программного комитета конференции разработчиков высоконагруженных систем HighLoad++Читать полностью »
Как вы считаете, какова стоимость очередей с приоритетами? То есть если кто-то лезет вне очереди, то как посчитать стоимость для всей системы в этой ситуации, чему она пропорциональна? Времени обслуживания клиента — например, 5 минут стоит его обслужить? Она пропорциональна количеству ожидающих, потому что время ожидания для каждого из них увеличится.
Для начала о себе — я занимаюсь разработкой СУБД Tarantool в Mail.ru. Этот доклад будет об обработке очередей. У нас много очередей внутри системы, фактически вся база данных построена как система массового обслуживания.
В основном речь будет идти о проблемах балансировки нагрузки, но перед этим я хотел бы поговорить о том, зачем нужны очереди и как они появились именно в компьютерных системах, чего они позволяют добиться.

Всем привет! Меня зовут Денис Иванов, и я расскажу о масштабировании баз данных через шардирование и партиционирование. После этого доклада у всех должно появиться желание что-то попартицировать, пошардировать, вы поймете, что это очень просто, оно никак жрать не просит, работает, и все замечательно.
Немного расскажу о себе — я работаю в команде WebAPI в компании 2GIS, мы предоставляем API для организаций, у нас очень много разных данных, 8 стран, в которых мы работаем, 250 крупных городов, 50 тыс. населенных пунктов. У нас достаточно большая нагрузка — 25 млн. активных пользователей в месяц, и в среднем нагрузка около 2000 RPS идет на API. Все это располагается в трех датацентрах.
Перейдем к проблемам, которые мы с вами сегодня будем решать. Одна из проблем — это большое количество данных. Когда вы разрабатываете тот или иной проект, у вас в любой момент времени может случиться так, что данных становится очень много. Если бизнес работает, он приносит деньги. Соответственно, данных больше, денег больше, и с этими данными что-то нужно делать, потому что эти запросы очень долго начинают выполняться, и у нас сервер начинает не вывозить. Одно из решений, что с этими данными делать — это масштабирование базы данных.
Читать полностью »
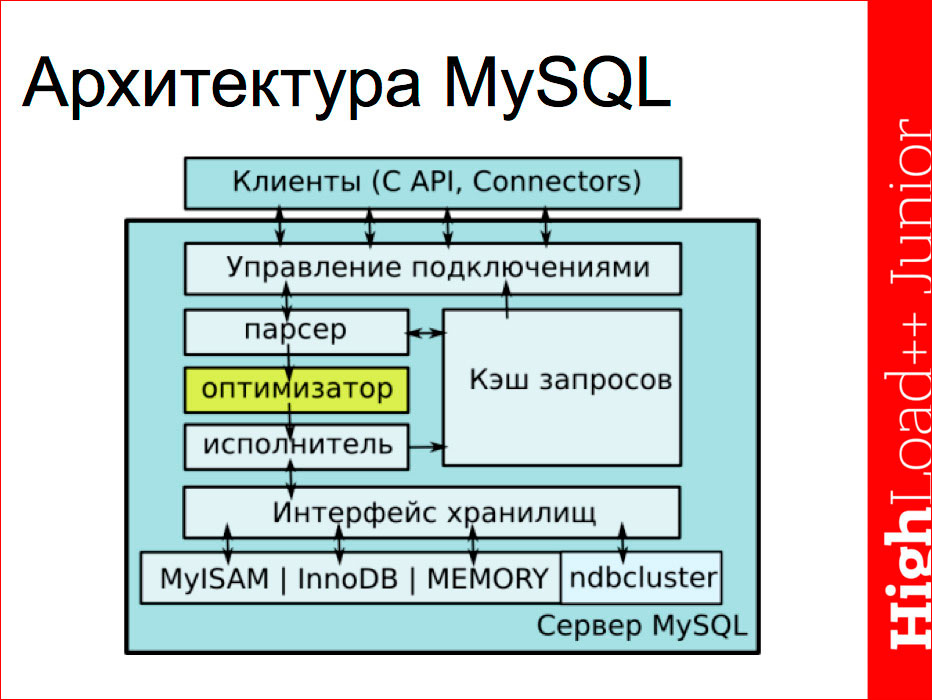
Темой доклада Василия Лукьянчикова является индексирование в MySQL и расширенные возможности EXPLAIN, т.е. нашей задачей будет ответить на вопросы: что мы можем выяснить с помощью EXPLAIN'а, на что следует обращать внимание?
Многие ограничения EXPLAIN'а связаны с оптимизатором, поэтому мы предварительно посмотрим на архитектуру, чтобы понять, откуда следуют ограничения и что, в принципе, с помощью EXPLAIN'а можно сделать.
По индексам мы пройдемся очень кратко, исключительно в плане того, какие нюансы есть в MySQL, в отличие от общей теории.
Доклад, таким образом, состоит из 3х частей:

Мой доклад предназначен для тех людей, которые знают слово «репликация», даже знают, что в MySQL она есть, и, возможно, один раз ее настроили, 15 минут потратили и забыли. Больше про нее они не знают ничего.
Мы немного пройдемся по теории, попытаемся объяснить, как это все работает внутри, а после этого вы с утроенными силами сможете сами нырнуть в документацию.
Что такое репликация, в принципе? Это копирование изменений. У нас есть одна копия БД, мы хотим с какой-то целью еще одну копию.
Репликация бывает разных видов. Разные оси сравнения:

На дворе сентябрь, а это значит, что мы в очередной раз объявляем набор в Школу программистов HeadHunter. В седьмой раз Школа открывает свои двери — в этом году мы снова будем готовить full-stack разработчиков.
Обучение будет проходить в московском офисе компании HeadHunter по вечерам два раза в неделю. Первый этап отбора можно пройти прямо на сайте школы, заполнив анкету и решив предложенные задачи. Справившихся с ними ждут задания посложнее, а затем и очное интервью.
Четверть нашего техдепа — это выпускники Школы. Мы любим разработчиков, потому что умеем их готовить!
Читать полностью »
Я попытаюсь залезть в «потроха» и «кишки» бэкенда веб-сервиса и расскажу, как это внутреннее устройство влияет на эффективность сервиса, а также на продукт, его характеристики, и как бы мы могли этим воспользоваться, чтобы наше приложение выдерживало большую нагрузку или работало бы быстрее.
Какую часть я называю веб-сервисом, бэкендом, application-сервером? В классической архитектуре это то, что стоит за http rеverse proxy или load-балансировщиком, а с другой стороны у него находятся база данных, memcached и др. Вот только об этом бэкенде и будет идти речь.
Немаловажный пункт, который очень часто упускают из вида разработчики — это эксплуатация проекта. Как выбрать дата-центр? Как прогнозировать угрозы? Что может произойти на уровне фронтенда? Как балансировать фронтенд? Как мониторить? Как настраивать логи? Какие нужны метрики?
И ведь это только фронтенд, а есть ещё бекенд и база данных. Везде разные законы и логика. Подробнее об эксплуатации highload-проектов в докладе Николая Сивко (Head Hunter) с конференции HighLoad++ Junior.
В сегодняшней статье поговорим о неотъемлемой составляющей большого числа современных веб-проектов — о фреймворках.
Роман Ивлиев на примере множества проектов портала banki.ru, а также заказной разработки в студии крупных проектов Онтико. Рассмотрим следующие темы и поищем ответы на вопросы:
Банки.ру — проект с 10-летней историей. В разные времена banki.ru испытывали разные нагрузки. Портал перестраивался под новые требования как логически, так и технологически, что-то мы меняли в авральном режиме, что-то — эволюционным путём. Сейчас средняя посещаемость примерно 2 миллиона просмотра страниц, т.е. проект уже не маленький, но ещё и не совсем большой.
Эта статья — расшифровка доклада Романа Ивлиева (CIO Banki.ru) на обучающей конференции HighLoad++ Junior, которая прошла пару месяцев назад в Москве в рамках фестиваля “Российские интернет-технологии”.
В этой статье мы хотим поговорить об оптимизации, её своевременности, и о субоптимизации, о том, что далеко не всегда лучшие практики разработки нагруженных систем идут на пользу бизнесу.
Посмотрим примеры и поищем ответы на вопросы:
В заключение Роман Ивлиев расскажет про несколько примеров из жизни banki.ru в части замены технологических решений в области высоких нагрузок, и что из этого вышло.