
 Казалось бы, что про диски Advanced Format за последние 4 года успели узнать все. Публикаций действительно много, но настало время рассмотреть все технические подробности и подводные камни в одной большой статье. Речь пойдёт об использовании AF-дисков в серверах, и я заметил, что для большинства администраторов даже в крупных компаниях знание предмета в большинстве случаев сводится к «это как-то связано с современными дисками, но у меня всё работает».
Читать полностью »
Рубрика «raid» - 5
Диски, контроллеры, ОС и Advanced Format
2014-12-05 в 9:27, admin, рубрики: hdd, raid, ит-инфраструктура, хранение данныхПочему по мере заполнения SSD падает скорость записи в RAID
2014-11-03 в 16:58, admin, рубрики: IOPS, raid, ssd, trim, Серверное администрирование, системное администрирование, хранение данныхЭта проблема наиболее актуальна для аппаратных RAID или firmware RAID (таких как Intel RST RAID 1/10/5/6) с непромышленными SSD.
Особенность SSD
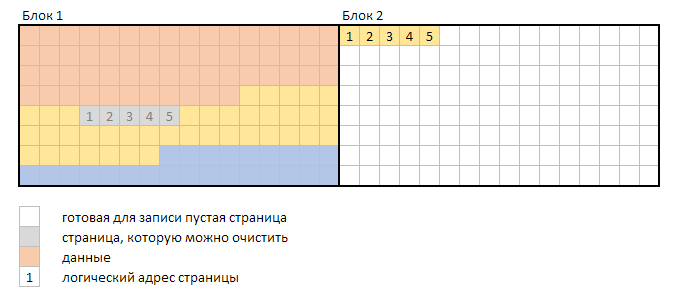
SSD пишут и читают данные страницами, записать можно только на очищенные страницы, а очистить страницы можно только большими блоками. Например, у диска размер страницы 8 КБ, в блоке находится 128 страниц, таким образом, размер блока — 1024 КБ (здесь и далее, если не указано иного, КБ и МБ двоичные).
Например, если изменить 40 КБ в одном файле, то на физическом уровне это будет выглядеть так:
SSD + raid0 — не всё так просто
2014-09-25 в 11:48, admin, рубрики: CDN, LSI, raid, raid0, ssd, ucdn, webzilla, Блог компании Webzilla, Железо, системное администрирование, спасибо за чтение, СХДВступление
Коллеги с соседнего отдела (UCDN) обратились с довольно интересной и неожиданной проблемой: при тестировании raid0 на большом числе SSD, производительность менялась вот таким вот печальным образом:
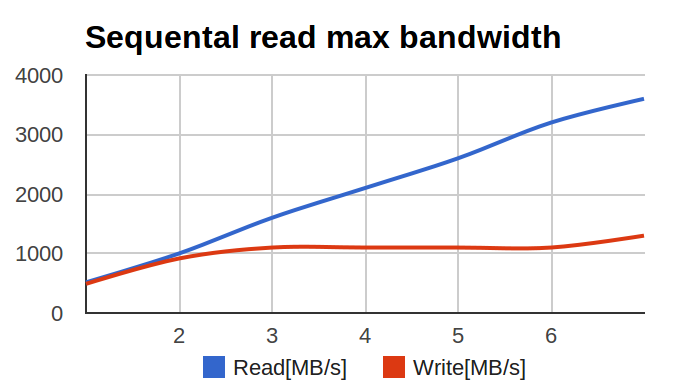
По оси X — число дисков в массиве, по оси Y — мегабайтов в секунду.
Я начал изучать проблему. Первичный диагноз был простой — аппаратный рейд не справился с большим числом SSD и упёрся в свой собственный потолок по производительности.
После того, как аппаратный рейд выкинули и на его место поставили HBA, а диски собрали в raid0 с помощью linux-raid (его часто называют 'mdadm' по названию утилиты командной строки), ситуация улучшилась. Но не прошла полностью -цифры возросли, но всё ещё были ниже рассчётных. При этом ключевым параметром были не IOPS'ы, а многопоточная линейная запись (то есть большие куски данных, записываемых в случайные места).
Ситуация для меня была необычной — я никогда не гонялся за чистым bandwidth рейдов. IOPS'ы — наше всё. А тут — надо многомногомного в секунду и побольше.
Адские графики
Я начал с определения baseline, то есть производительности единичного диска. Делал я это, скорее, для очистки совести.
Вот график линейного чтения с одной SSD.
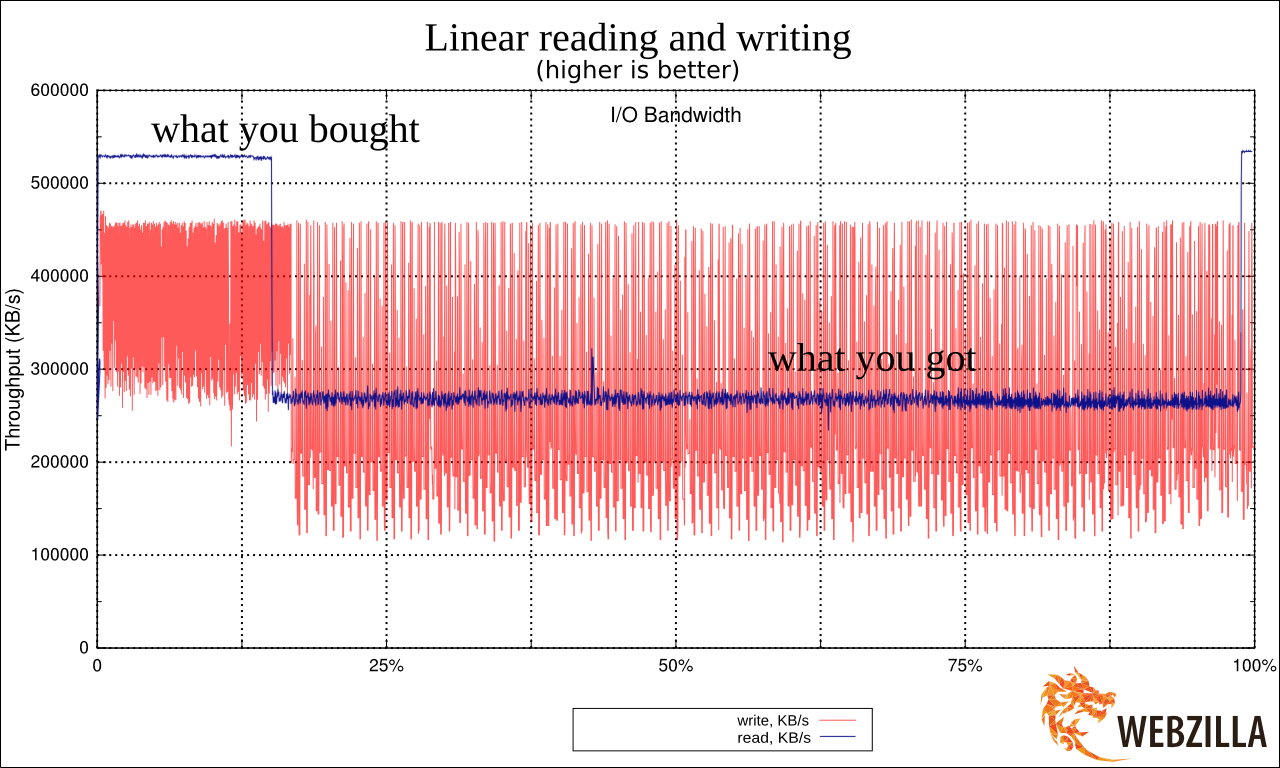
Увидев результат я реально взвился. Потому что это очень сильно напоминало ухищрения, на которые идут производители дешёвых USB-флешек. Они помещают быструю память в районы размещения FAT (таблицы) в FAT32 (файловой системе) и более медленную — в район хранения данных. Это позволяет чуть-чуть выиграть по производительности при работе с мелкими операциями с метаданными, при этом предполагая, что пользователи, копирующие большие файлы во-первых готовы подождать, а во вторых сами операции будут происходить крупными блоками. Подробнее про это душераздирающее явление: lwn.net/Articles/428584/
Читать полностью »
Это видео будет вечным или широко-доступно увеличиваем вместимость видеорегистратора (NVR-DVR)
2014-08-20 в 12:04, admin, рубрики: DAS, NVR, raid, видеонаблюдение, видеорегистратор, хранение данных Проблема с недостатком объема для хранения архива в цифровых/сетевых видеорегистраторах стара как мир. Вариантов ее решения много, но всегда есть конкретное
ограничение: «бюджет». В результате, наши желания хранить архивы по 30-60 (а это почти 30-40Тб) суток превращаются в «несбыточную мечту». В идеале хотелось бы, чтобы архив резервировался автоматически без хронической дилеммы хватит ли места очередному бэкапу на USB-HDD или нет. Наличие данной дилеммы особенно напрягает, так как процесс в долговременной перспективе может превратиться в лотерею: вы полагаете, что бекап прошел, а он и не начинался так как внешний сингловый диск давно заполнен.
Читать полностью »
Производительность хранилищ
2014-06-29 в 21:11, admin, рубрики: avago, LSI, raid, sas, высокая производительность, Железо, производительность, пропускная способность, хранилище данных, метки: avago, LSI, raid, sas, производительность, пропускная способность, хранилище данных Поскольку компания LSI (теперь уже часть Avago Technologies) продала свое подразделение flash-контроллеров небезызвестной Seagate, основной областью их внимания вновь становятся решения для RAID и SAS (своеобразный back to basics). Чтоб отметить это «возвращение к корням», я решил перевести интересную статью Томаса Павела (Thomas Pavel), директора по продажам storage-подразделения EMEA. Не уверен насчет того, выложена ли данная статья в Интернет, по крайней мере пока не нашел.
Читать полностью »
Конвертация RAID 10 из 4-х дисков в RAID 6 из 8-ми дисков на серверах HP Proliant
2014-04-02 в 15:56, admin, рубрики: hp proliant, raid, ит-инфраструктура, Серверное администрирование, системное администрирование 
Производить конвертацию мы будем на сервере HP Proliant DL160 G8 с обычным разбиением по разделам (не lvm). Т.е. диски sda1...sda8, каждый из которых примонтирован в определенный каталог. В случае с lvm процесс немного легче и удобнее. Статья должна подойти для любого hp-сервера, в котором используется официальная утилита hpacucli. В данном примере у нас CentOS 6.5, но подойдет любой Linux, поддерживаемый hpacucli.
Читать полностью »
Извлечение дисков из живого рейда на adaptec 6805
2014-02-28 в 12:40, admin, рубрики: raid, Серверное администрирование, системное администрирование, метки: raidЗадача:
Извлечь 2 харда из raid-10 на логическом уровне (т.е., не извлекая из сервака физически), чтобы собрать из них raid-1, перенести туда систему и подготовить всё что можно к ребуту, таким образом минимизировав время и количество даунтаймов.
В чем сложность?
В 5 серии адаптеков вопрос решался двумя командами:
1. Зафейлили диск: arcconf setstate 1 device 0 0 ddd
2. Перевели в статус Ready: arcconf setstate 1 device 0 0 rdy
3. Делаем с дисками, что хотим.
В 6 серии так не прокатывает. Вне зависимости от того, включен failover или нет, диски возвращаются в состояние Present, и с ними ничего нельзя поделать (думаю, ясно, что сам рейд будет Degraded, пока не пройдет Rebuild).
Попытка обратиться в официальную тех.поддержку была неудачна — ответ я получил, но возникло ощущение, что я использую домашнюю железку, а не сервер, который нельзя просто так дергать туда-сюда:
После того как вы провели команду «arcconf setstate 1 device 0 0 ddd», система была перезагружена? Если нет, то перезагрузите и инициализируете оба диска в БИОСе контроллера. Там сразу же можно и создать RAID-1.
Чтобы стереть мете-данные на диске под Arcconf диск можно инициализировать с командой «arcconf task». Например: arcconf task start 1 device 0 0 initialize
После этого диск должен быть доступным для создания других логических дисков.
Однако, если Вы выбрасываете из RAID-10 два диска, то он остаётся в статусе «Degraded». При ошибке одного из оставшийся в массиве дисков может рухнуть весь массив. Поэтому, возможно, просто сделайте бэкап всех данных, потом просто удалите массив RAID-10 и создавайте два отдельных RAID-1.
Я подумал и решил вопрос очередью экспериментов, после чего смог выполнить поставленную задачу.
Производительность RAID массивов
2014-02-22 в 12:10, admin, рубрики: ESXi, raid, raid10, raid5, speedtest, VMware, виртуализация, Накопители, системное администрирование, метки: ESXi, raid, raid10, raid5, speedtest, vmwareУверен, что каждый системный администратор сталкивался с вопросом какой raid массив использовать для той или иной задачи. Хочу поделиться своими мыслями, цифрами и рассуждениями на эту тему.
Задача — планирование места для размещение виртуальных машин на системе хранения данных.
Используемое аппаратное и программное обеспечение для тестирования — VMWare ESXi 5.5 на HP ProLiant DL380 Gen8, виртуальная машина Windows 2008 R2 Enterprise (2 CPU, 4 Gb RAM, 60 Gb HDD), дисковая система HP P2000 G3 MSA FC, диски HP SAS 600Gb 10k, программа оценки скорости Cristal Disk Mark.
Цель — подбор типа raid массива.
Читать полностью »
StableBit DrivePool — дисковый массив с дублированием файлов
2013-09-16 в 9:27, admin, рубрики: raid, windows, дисковый массив, резервное копирование, метки: raid, windows, дисковый массив, резервное копированиеЯ постоянно пытаюсь найти какие-то альтернативы RAID'ам в плане объединения нескольких жестких дисков в единый массив. Пробовал много что, но ни на чем так и не остановился окончательно. RAID не нравится тем, что штука достаточно капризная, негибкая и требовательная до дискового пространства.
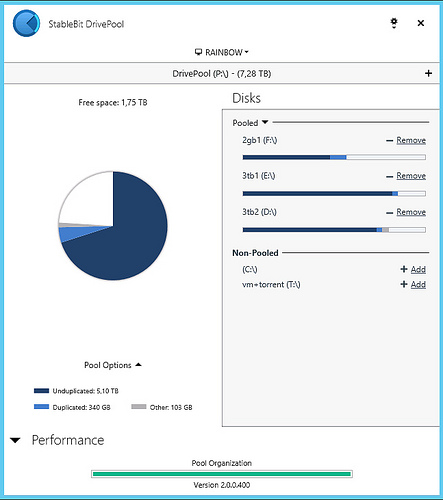
Что мне вообще хочется:
- Объединить диски с данными в один массив большого объема, чтобы не приходилось вручную сортировать файлы — что возникает при нескольких дисках (пусть даже при монтировании их в папки).
- Иметь возможность добавлять/удалять/заменять диски в любой момент без развала массива.
- Независимость информации на дисках друг от друга — чтобы смерть одного из них не приводила к недоступности остальных.
- В идеале — какой-то метод хранения одного файла на нескольких дисках. Бэкапы — это хорошо и я их делаю, но лучше, когда к их помощи не приходится прибегать.
LSI Nytro MegaRAID NMR8100-4i в деле
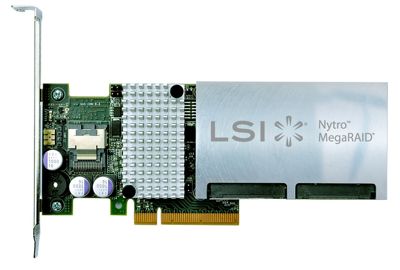
2013-08-09 в 23:34, admin, рубрики: hostkey, LSI, raid, ssd caching, Блог компании HOSTKEY, виртуализация, выделенный сервер, высокая производительность, Железо, хостинг, метки: hostkey, LSI, raid, ssd caching, виртуализация, выделенный сервер, хостингКлиент сформулировал мне в HOSTKEY задачу — на 1 (один) сервер с 12 ядрами и 64Гб памяти надо примерно 3-4Тб места под более-менее однотипные виртуалки, но что бы работало все как на SSD и при этом уложиться в 16000р в месяц. Стали думать, вариантов было несколько:
- делаем все на SSD. берем 6 дисков по 500Гб типа Samsung 840 Pro eMLC, собираем их в страйп или еще как хитро, добавляем пару дисков по 3Тб для бакапа и… не проходим в бюджет. 2U сервер, 8 портовый RAID контроллер и диски по 12000р за штуку не пропускают.
- Делаем все на жестких дисках, берем 12x300Gb SAS 15K и опять не проходим ни в бюджет, ни в производительность.
- Используем RAID контроллер с внешним SSD кэшем – LSI CacheCade или Adaptec MaxCache. Идея получше, но нам надо 4 диска по 2Тб в RAID10 – придется брать 8 портовый контроллер и к нему SSD на 120Гб eMLC или SLC. Что бы к SSD был доступ, опять надо брать 2U корпус. Контроллер 8 портов + SSD стоит около 37000р, в бюджет не проходим.
- Используем новую LSI Nytro MegaRAID NMR8100-4i. Берем 1U систему, ставим в нее контроллер, ставим в нее 4 диска по 2Тб в RAID10 и вписываемся и в производительность и в бюджет. Нитра стоит 27000р, на ней уже стоят 2 диска по 44Гб, причем SLC!
Сказано – сделано, примерно 3 рабочих дня и 4 вариант у нас на столе. Посмотрим, на что он способен — не на рекламных проспектах, а на практике.
Читать полностью »