Рубрика «raid» - 4

Всё, что вы хотели узнать о RAID-контроллерах, но лень было искать - 1

Дисковый массив с нотками ретро.

На плечах RAID-контроллеров лежит ответственная задача — управление дисковой подсистемой, то есть всей информацией, хранимой на сервере. Именно они отвечают за работу дисковых массивов, позволяя повысить производительность сервера или надёжность хранения данных. Поэтому давайте поговорим о RAID-контроллерах, установленных в серверы вендоров «большой тройки», об их возможностях и особенностях.
Читать полностью »

Пускай уже давно, но как-то незаметно, прошла новость о том, что Hyper-V а потом и Azure начал поддерживать FreeBSD. Любители старой, доброй, FreeBSD возрадовались, а многие другие люди могли недоумевать: «зачем?». Именно благодаря усилиям компании NetApp, FreeBSD теперь поддерживается в Hyper-V и Azure. Каким образом NetApp в этом заинтересована? Дело в том, что ОС ONTAP построена на базе FreeBSD. Именно для того, чтобы появились продукты созданные на базе Data ONTAP-v, такие как Cloud ONTAP и Data ONTAP Edge. Кроме того компания NetApp является одним из самых больших современных контрибюторов кода для FreeBSD.
NetApp virtual storage appliance: Data ONTAP-v - 1
Читать полностью »

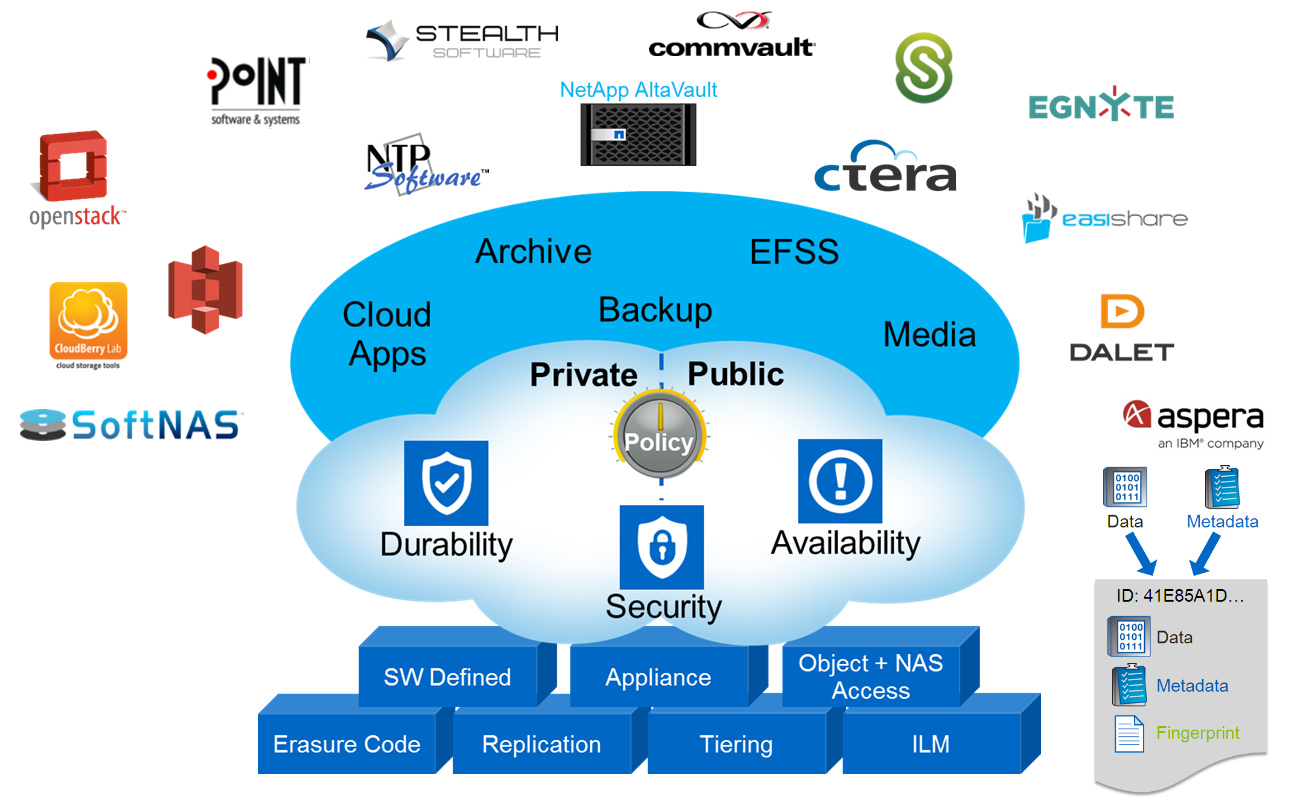
В этой статье я отклонюсь от традиционной для меня темы систем хранения FAS и подниму тему объектного хранения данных в системах NetApp StorageGrid WebScale. Если кратко, то объектное хранение — это третий тип хранения наряду с NAS и SAN. Представьте себе, что каждый файл состоит из данных и метаинформации (владелец, права, время модификации и т.д.), так вот объектное хранение позволяет разъединить эти части и хранить их в виде «ключ/значение». Такой подход хранения информации открывает возможности децентрализованного, распределённого хранения данных огромных масштабов с прозрачной миграцией данных, репликацией и прозрачным переключением конечных потребителей между нодами объектного кластера. В широком смысле объектное хранилище может быть реализовано как на уровне устройства (жесткого диска), при помощи специализированных SCSI команд (Object-based Storage Device Commands), так и на уровне протокола доступа к системе хранения, которая состоит из нескольких дисков (которые, в свою очередь, вовсе не обязаны быть объектными). В обоих случаях используется Ethernet для подключения и IP протокол для передачи данных. Примером реализации объектного хранилища на уровне устройства являются жесткие диски линейки Seagate Kinetic Open Storage platform. Примером систем хранения данных в облаке может быть Microsoft Azure BLOB, Amazon S3. В этой статье я остановлюсь на объектных СХД, которые можно развернуть у себя на сайте и при необходимости подключить к облаку.
Объектное хранилище NetApp StorageGrid - 1
Читать полностью »

Системы хранения данных для подавляющего большинства веб-проектов (и не только) играют ключевую роль. Ведь зачастую задача сводится не только к хранению определенного типа контента, но и к обеспечению его отдачи посетителям, а также обработки, что накладывает определенные требования к производительности.

В то время, как при производстве накопителей используется множество других метрик, чтоб описать и гарантировать должную производительность, на рынке систем хранения и дисковых накопителей, принято использовать IOPS, как сравнительную метрику, с целью «удобства» сравнения. Однако производительность систем хранения, измеряемая в IOPS (Input Output Operations per Second), операциях ввода / вывода (записи / чтения), подвержена влиянию большого множества факторов.

В этой статье я хотел бы рассмотреть эти факторы, чтобы сделать меру производительности, выраженную в IOPS, более понятной.

Начнем с того, что IOPS вовсе не IOPS и даже совсем не IOPS, так как существует множество переменных, которые определяют сколько IOPS мы получим в одних и других случаях. Также следует принять во внимание, что системы хранения используют функции чтения и записи и обеспечивают различное количество IOPS для этих функций в зависимости от архитектуры и типа приложения, в особенности в случаях, когда операции ввода / вывода происходят в одно и тоже время. Различные рабочие нагрузки предъявляют различные требования к операциям ввода / вывода (I/O). Таким образом, системы хранения, которые на первый взгляд должны были бы обеспечивать должную производительность, в действительности могут не справится с поставленной задачей. Читать полностью »

Привет, %хабрачитатель%!

Несколько месяцев назад у нас возникли проблемы с одной виртуальной машиной, запущенной на сервере Dell PowerEdge R720 с ESXi 5.5. Перезагрузка этой VM длилась довольно долго и вызвала сильное падение производительности на самом хосте.
Lifecycle-лог на сервере был наполнен сообщениями вида:

PDR47
A block on Disk 0 in Backplane 1 of Integrated RAID Controller 1 was
punctured by the controller.

PDR64
An unrecoverable disk media error occurred on Disk 0 in Backplane 1 of
Integrated RAID Controller 1.

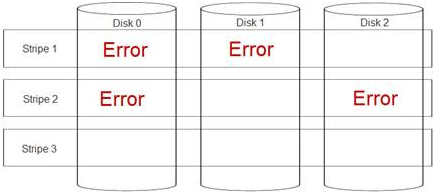
Гугление привело к неутешительному выводу: рейд-массив поврежден и восстановить его невозможно. А именно — повредились данные, относящиеся к одному блоку (страйпу), сразу на нескольких дисках (double fault):
Автоматизация проверки на целостность рейд-массива на сервере Dell - 1
К счастью, делловские RAID-контроллеры обладают фичей продолжать работу, несмотря на неконсисентное состояние массива — puncture (https://www.dell.com/support/Article/us/en/04/438291/EN#Unique-Hyphenated-Issue-Here-2), что позволяет сохранить хотя бы ту часть данных, которая не повредились. Это, конечно, не никак отменяет необходимость последующей замены дисков и пересборки рейд-массива «с нуля».
Для предотвращения подобных ситуаций Dell рекомендует запускать проверку целостности массива не реже одного раза в месяц. Увы, но мы об этом узнали слишком поздно.

Такую проверку можно запускать как через веб-интерфейс Dell OpenManage Server Administrator (http://www.dell.com/support/contents/us/en/19/article/Product-Support/Self-support-Knowledgebase/enterprise-resource-center/Enterprise-Tools/OMSA/), так и через утилиты omconfig/omreport, входящие в OMSA. И, если бы разработчики из Dell не «забыли» включить эти утилиты в OpenManage для ESXi, то проблем с автоматизацией бы не возникло, т.к. понятно, что ручная проверка целостности массива на каждом сервере, совершенно не IT-way. Не говоря уже о том, что интерфейс OMSA очень медленный и работать с ним удовольствие еще то.
Ребята из Dell «поработали на славу» и простым способом автоматизировать проверку (например, через открытие в cURL заранее подготовленной ссылки) невозможно, т.к. веб-интерфейс генерируется динамически и постоянные ссылки в нем отсутствуют.

Что же делать? Читать полностью »

Тестируем PostgreSQL на SSD RAID-0 массиве с таблицей в 10 миллиардов записей. (Часть 3, заключительная) - 1

Пора провести финальные тесты и подвести итоги цикла статей. Сегодня мы рассмотрим влияние размера shared_buffers на производительность БД. Первые части можно почитать здесь и здесь.

В ходе развития сервиса оптимизации затрат на сотовую связь Dr. Tariff (iOS, Android) для совместного пилота с одним из партнеров нам потребовалась большая и производительная реляционная база данных.

Читать полностью »

Тестируем PostgreSQL на SSD RAID-0 массиве с таблицей в 10 миллиардов записей. (Часть 2) - 1

Итак, продолжим исследовать характеристики работы PostgreSQL на SSD и HDD дисках с целью повышения производительности системы. Первую часть можно почитать здесь.

В ходе развития сервиса оптимизации затрат на сотовую связь Dr. Tariff (iOS, Android) для совместного пилота с одним из партнеров нам потребовалась большая и производительная реляционная база данных.

В этот раз мы протестировали PostgreSQL на RAID-0 массиве из двух SSD дисков. RAID массив собирался с помощью mdadm. Размер страйпа (блока информации, который распределяется на все диски массива) – 512k.
Читать полностью »

Тестируем PostgreSQL на SSD RAID-0 массиве с таблицей в 10 миллиардов записей. (Часть 1) - 1

В ходе развития сервиса оптимизации затрат на сотовую связь Dr. Tariff (iOS, Android) для совместного пилота с одним из партнеров нам потребовалась большая и производительная реляционная база данных.

Производительности HDD диска было явно недостаточно. Размер базы должен был составить несколько сотен гигабайт, поэтому размещение ее в оперативной памяти было бы слишком дорого. SSD диск наилучшим образом подходит для этой задачи. Но одного SSD диска могло не хватить, поэтому было решено собрать RAID-0 массив из двух дисков. Пользуясь случаем мы решили провести тестирование производительности PostgreSQL на одном и двух SSD дисках.

Основные цели тестирования

1. Сравнить производительность PostgreSQL на SSD RAID-0 массиве с производительностью на одиночном SSD.
2. Изучить производительность базовых операций (SELECT и UPDATE) в зависимости от размера таблицы, количества подключений, настроек сервера и других параметров.

Тестирование проводилось в несколько итераций. По каждой части решено было написать подробную статью с отчетами:

  1. Тестирование одного SSD диска
  2. Тестирование RAID-0 массива из 2-х SSD дисков
  3. Влияние настроек сервера на производительность БД
  4. Сравнение SSD с HDD

Читать полностью »

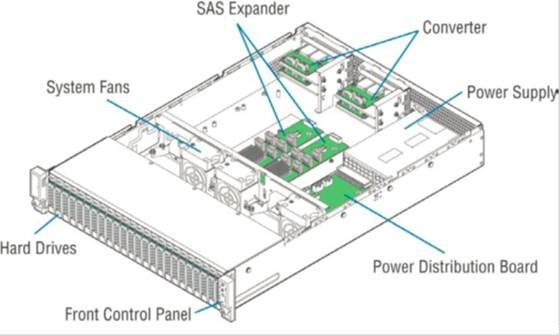
Буквально недавно мне довелось тестировать дисковую полку от компании Intel®. «Казалось бы, чего может быть удивительного в обычной дисковой полке,»-подумал я, но после детального рассмотрения полка оказалась не совсем типичной. Собственно, об этом я и расскажу.

Тестирование полки Intel® Storage System JBOD 2000 Family - 1

Читать полностью »

Как разработчики сидели в Петербурге и тихо ели грибы, а потом написали ОС для систем хранения данных - 1

В конце 2008 года на тогда ещё небольшую петербуржскую компанию вышел один западный медиахолдинг примерно так:
— Это вы там упоролись по хардкору и приспособили SSE-инструкции для реализации кода Рида-Соломона?
— Да, только мы не…
— Да мне пофиг. Хотите заказ?

Проблема была в том, что видеомонтаж требовал адовой производительности, и тогда использовались RAID-5 массивы. Чем больше дисков в RAID-5 — тем выше была вероятность отказа прямо во время монтажа (для 12 дисков — 6%, а для 36 дисков — уже 17-18%). Дроп диска при монтаже недопустим: даже если диск падает в хайэндовой СХД, скорость резко деградирует. Медиахолдигу надоело с криком биться головой о стену каждый раз, и поэтому кто-то посоветовал им сумрачного русского гения.

Много позже, когда наши соотечественники подросли, возникла вторая интересная задача — Silent Data Corruption. Это такой тип ошибок хранения, когда на блине одновременно меняется и бит в основных данных, и контрольный бит. Если речь о видео или фотографии — в целом, никто даже не заметит. А если речь про медицинские данные, то это становится диагностической проблемой. Так появился специальный продукт под этот рынок.

Ниже — история того, что они делали, немного математики и результат — ОС для highload-СХД. Серьёзно, первая русская ОС, доведённая до ума и выпущенная. Хоть и для СХД. Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js