
В прошлой статье я рассказывал, как устроено ядро нашего поиска: триграммы, crc32, словарь болей и два сита. В конце был короткий раздел «А где же нейросеть?», и он заслуживает отдельного разговора. Сегодня про то, как модель встроена сверху и почему мы с самого начала исходили из того, что она когда-нибудь подведёт.
Рубрика «reasoning»
Языковая модель в поиске магазина: как подключить её так, чтобы её падение никто не заметил
2026-10-07 в 7:08, admin, рубрики: claude, deepseek, fallback, json, llm, python, reasoning, отказоустойчивость, умный поиск, языковые моделиGigaChat 3.5 Reasoning — первая в России открытая модель с рассуждениями
2026-09-10 в 6:05, admin, рубрики: AGI, AI, alignment, GigaChat, llm, online rl, reasoning, reinforcement learningПривет. Мы выпускаем GigaChat 3.5 Reasoning, первую модель GigaChat с полноценным рассуждением, обученную на технологии online RL. Веса и код запуска на huggingface, также модель можно попробовать в giga.chat.
Главное, что изменилось в обучении: после SFT модель целиком прошла через online RL. Не один домен и не одна финальная стадия, а шесть отдельных экспертов (математика, код, агенты, и другие), каждый со своей наградой, которые потом собрали обратно в одну модель. Как это устроено и на чём мы набили шишки, рассказываем ниже.
Single Task Algorithmic Reasoning Models: как с помощью маленькой модели обойти большую LLM?
2026-08-12 в 15:09, admin, рубрики: adaptive compute time, llm, reasoning, альтернативные архитектурыПривет! Результаты коллег по цеху и наши исследования позволяют сделать однозначный вывод: в 2026-м для рецепта отличной reasoning-модели уже недостаточно лишь текстовых рассуждений. Для качественных ответов на большинство вопросов пользователей нужна работа с инструментами, мультимодальные режимы рассуждений, и нередко даже такая экзотика, как рассуждения в латентных представлениях сети.
Мы рады поделиться с сообществом фреймворком для обучения рекурсивных reasoning-моделей STARM, существенно опережающих по качеству предыдущие open source-аналоги.
О чём расскажем?
«Скопируй промпт дважды и получишь +76%». Я решил проверить
2026-08-03 в 8:27, admin, рубрики: gemini, llm, reasoning, воспроизводимость, промпт-инжиниринг, промпты, экспериментВсем привет. В декабре по всем AI-каналам пролетел лайфхак, который звучал как развод: продублируй свой запрос к нейросети, буквально Ctrl+C, Ctrl+V в одном сообщении, и точность вырастет. В пересказах фигурировали «+76%» и ссылка на Google Research, что придавало всей этой истории солидности. Трюк выглядел как-то настораживающе и при том вроде не сложным для проверки. Короче, я потратил $1.48, прогнал 3360 запросов и теперь знаю ответ. Он оказался интереснее, чем «работает || не работает».
Что на самом деле написано в статье
Источник это препринт Prompt Repetition Improves Non-Reasoning LLMsЧитать полностью »
Модель находит баг в криптографии, а криптограф узнаёт от неё новую математику
2026-02-05 в 16:27, admin, рубрики: gemini, Google Research, llm, LWE, peer review, reasoning, SNARG, zk-SNARK, верификация доказательств, дерево Штейнера
Эта статья — ответ на критику: «перестаньте рассказывать сказки, как AI помогает в науке, покажите примеры!». Действительно, без примеров, рассказы об успешном успехе AI выглядят как сектантский бред.
Читаем вместе. ИИ в AppSec: могут ли LLM работать с уязвимым кодом
2025-10-01 в 10:59, admin, рубрики: claude, dataset, gpt-4, large language model, llm, reasoning, безопасная разработка, искусственный интеллект, промптинг, уязвимый исходный код
Grok 4 Fast — новая модель от xAI
2025-09-21 в 7:31, admin, рубрики: AI, grok, Grok4Fast, llm, openrouter, reasoning, Vercel, xai, генеративный ииКоманда AI for Devs подготовила перевод анонса Grok 4 Fast — новой модели xAI, которая сочетает быстрые ответы и глубокие рассуждения, снижает стоимость токенов на 98% и впервые становится доступной всем пользователям без ограничений.
Мы рады представить Grok 4 FastЧитать полностью »
Галлюцинации LLM: запретить нельзя использовать
2025-09-17 в 18:30, admin, рубрики: llm, reasoning, галлюцинирование нейросетей, достоверность, ИИ, нейросети, промт, трансформеры, языковые модели
Давайте поговорим о галлюцинациях LLM - больших языковых моделей.
На первый взгляд это выглядит как ошибка, ложь или выдумка. В недавнем отчёте OpenAI Why Language Models HallucinateЧитать полностью »
Deep Think with Confidence (DeepConf): уверенные рассуждения с ранней остановкой
2025-09-14 в 6:30, admin, рубрики: CONFidence, DeepConf, reasoning😎 Следуй за белым кроликом 💊
📌 Telegram @TheWeeklyBrief — краткие обзоры и подкасты 📰🎧🐇
📌 GitHub Pages — углублённый разбор статей, ныряем в кроличью нору 📝💻🐾
Предпосылки и мотивация
Не «ты — эксперт », а «думай так» — альтернативный промтинг для LLM
2025-09-05 в 11:30, admin, рубрики: reasoning, галлюцинации, ИИ, промт, промтинг, творческое мышление, творчество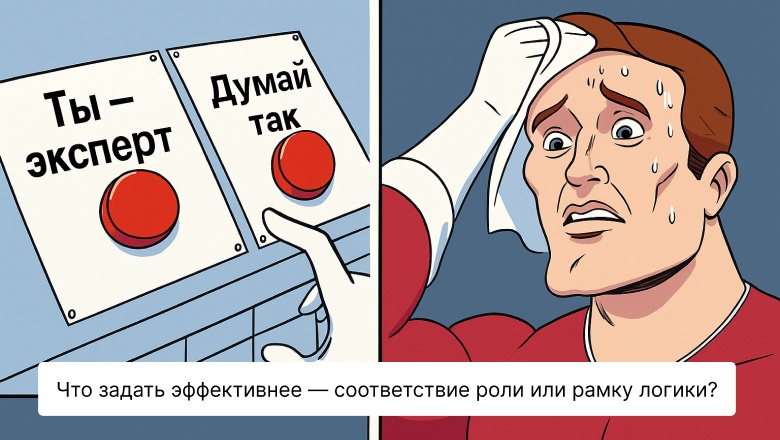
За последнее время большие языковые модели (LLM) стали привычным инструментом для анализа и работы с текстом. Но, что важно, качество ответа зависит не только от самой модели, но и от того, как именно задан запрос.