Рубрика «СУБД» - 18

Экспорт данных из PostgreSQL в Excel - 1

Приветствую всех.
При автоматизации небольших магазинов для хранения данных часто используют PostgreSQL. И часто возникает потребность экспортировать эти данные в Excel. В этой статье я расскажу вам как я решал эту задачу. Естественно, матерые специалисты вряд ли откроют для себя что-то новое. Однако, материал будет интересен тем кто «плавает» в этой теме.
Читать полностью »

Всем привет,

Описываются базовые возможности, плюсы и минусы использования встроенного полнотекстового поиска СУБД Postgre на основе опыта его практического использования.

Использование полнотекстового индексирования и поиска в PostgreSQL - 1

При разработке приложений, особенно web-приложений, в 95% возникает задача выбрать системы для управления как структурированным контентом, так и неструктурированными (текстовая информация произвольной структуры), а также данными мультимедиа (выходит за рамки данной статьи).
Архитектор приложения задается вопросом: совместить эти данные под управлением одной СУБД, либо же взять отдельное специализированное средство для каждого вида информации.

Существуют проверенные временем инструменты для индексирования и поиска неструктурированных текстовых данных — Django, Sphinx, Lucene, на Хабре есть хорошие авторские статьи на эту тему.
Преимущество в том, что это отдельная система и она приспособлена для своей задачи максимально хорошо.
Но есть и архитектурный минус такого решения — ведь структурная и описательная часть данных чаще всего связаны между собой, а следовательно придется сконструировать комбинированные запросы.
Читать полностью »

От первой СУБД к полноценной ECM. История жизни одного программного комплекса
Не то, чтобы однажды утром мы проснулись и подумали, а почему бы не создать софт, который позволит управлять большими потоками нормативно-правовой и нормативно-технической документации. Нет, поверьте, с такими мыслями не просыпаются. Особенно, когда на дворе девяностые и вся надежда только на два арендованных компьютера, да на группу энтузиастов, состоящую из 10 человек. Скорее, наши программные разработки стали ответом на реальную потребность времени. Сейчас ECM-системами «Кодекс» и «Техэксперт» пользуются более 200 тысяч пользователей по всей стране, а 23 года назад никто из нас и представить себе не мог, что из этого всего получится.

В честь нашего первого поста на Хабре хотим поделиться с вами парочкой фотографий из «семейного» архива и рассказать о том, как мы развивались вместе с отечественными ИТ.Читать полностью »

Пусть и с некоторым опозданием, по сравнению с остальными компаниями, но Microsoft сделала необходимое и выпустила собственную нереляционную базу данных: она называется DocumentDB. И пусть это проприетарная система, которая привязана к сервису Azure, это не делает новость менее значимой.

DocumentDB автоматически индексирует содержимое всех документов, допускает полнотекстовый поиск в реальном времени, полностью поддерживает требования ACID к транзакциям (атомарность, согласованность, изолированность, надёжность). Система очень похожа на MongoDB как эффективное хранилище JSON-документов с богатыми API для запросов, в то же время выгодно отличается от MongoDB по масштабируемости и надёжности работы, глубокой интеграции JavaScript, поддержке RESTful API, асинхронных запросов и др.

DocumentDB: база данных NoSQL от Microsoft

Как и MongoDB, DocumentDB представляет собой иерархию баз данных, коллекций и документов.
Читать полностью »

Продолжая публикацию материалов о техниках физического моделирования в СУБД Teradata мы, как и обещали в прошлой статье, хотим рассказать о дополнительных техниках, не относящихся напрямую к обычным индексам (хоть в этой статье мы и коснемся особых видов индексов, о которых следует знать).

Помимо обычных индексов в СУБД Teradata присутствует ряд специфичных и иногда тонких техник, которые могут применяться в физическом моделировании. Приведем описание большинства из техник, а если возникнут вопросы или желание узнать подробней, будем рады ответить в комментариях.
Читать полностью »

в 16:11, , рубрики: big data, teradata, СУБД, метки: , ,

Предисловие: По работе мне пришлось изучать устройство базы данных Teradata, и оказалось, что в интернете почти нет информации, особенно на русском языке. Поэтому я решила собрать в кучу всю доступную информацию.

Стремительное увеличение объемов носителей информации и удешевление стоимости хранения данных привело к появлению методов, способных обеспечить более быстрый доступ к необходимым данным – индексы, хранение данных в отсортированном виде и т.п. Эти методы вполне успешно справляются со своей задачей, однако возрастающая конкуренция в мире заставляет искать новые, более быстрые, способы доступа к информации. «Кто владеет информацией, тот владеет миром». Основной интерес вызывают базы данных с традиционной реляционной моделью данных, отвечающие требованиям ACID (Atomicity, Consistency, Isolation, Durability — атомарность, согласованность, изолированность, надежность) и предназначенные для аналитики Больших Данных (Big Data).

Teradata – это параллельная реляционная СУБД, которая работает на операционных системах:

  • MP-RAS UNIX
  • Microsoft Windows 2000/2003 Server
  • SuSE Linux

Разнообразие поддерживаемых ОС — одна из причин, почему Teradata имеет открытую архитектуру.
Читать полностью »

Оптимизация производительности – это такая область, в которой каждый хотел бы стать великим мастером. Если говорить о специалистах в области работы с базами данных, то мы все приходим новичками и в начале карьеры затрачиваем массу времени, изучая основы, стараясь постичь искусство настройки серверов баз данных и приложений для улучшения производительности. Однако, и по мере проникновения в тему глубже, оптимизация производительности не становится легче.

По мере развития технологий, внедрению современных «гибких» подходов, «непрерывной интеграции» в области баз данных необходимость в более быстром отклике на запросы конечных пользователей только усиливается. В нынешних условиях распространения мобильных устройств практически всегда требуется внести изменения в системы обработки данных, чтобы ускорить обмен данными с «нативными» или WEB-приложений пользователей.

Мы наблюдаем постоянное появление и ввод новых технологий. Это здорово! А в это же время имеющиеся «старые» технологии требуют массу внимания и времени для поддержки. «Океан» данных, «море» баз данных, больше распределенных систем. Остается меньше времени на настройку и оптимизацию. Сокращение окон для модификации, поддержки и внесения изменений осложняет задачу увеличить непрерывность работы систем на имеющемся оборудовании.

В области настройки оптимизации баз данных, часто встречаются ситуации, когда трудно выбрать «правильное» решение. В таких случаях приходится полагаться на различные инструменты, которые помогают оценить ситуацию и найти пути ее улучшения. Освоив такие инструменты, часто становится проще найти лучшее решение, если в дальнейшем возникает подобная ситуация.
В подтверждение этой мысли приведу перевод любопытной статьи из блога bulldba.com/db-optimizer


В новых релизах DB Optimizer компании Embarcadero, начиная с версии 3.0, имеется отличная новая возможность: наложить на диаграмму VST explain plan запроса!

[Примечание переводчика:
Диаграмма визуальной оптимизации Visual SQL Tuning (VST) превращает текстовый SQL-код в графическую SQL-диаграмму, показывает индексы и ограничения в таблицах и представлениях с использованием статистических сведений, а также операции соединения, используемые в инструкции SQL, такие как прямые и подразумеваемые декартовы произведения и отношения «многие ко многим». ]

Возьмем для примера следующий запрос:

SELECT COUNT (*) 
FROM   a,  b,  c
WHERE
       b.val2 = 100 AND
       a.val1 = b.id AND
       b.val1 = c.id; 

По колонкам b.id и c.id созданы индексы. В окне DB Optimizer этот запрос выглядит так:
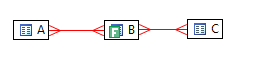
Использование слоя плана выполнения SQL запроса на VST диаграммах

Красные линии связей такого вида в соответствии с определениями говорят, что отношения могут быть типа «многие ко многим».
Вопрос: «какой план выполнения этого запроса является оптимальным?».

Один из возможных оптимальных планов выполнения этого «дерева запроса» может быть таким:

  1. Начать с наиболее селективного фильтра
  2. Выполнить JOIN с подчиненными таблицами, если возможно
  3. Если нет – то выполнить JOIN с таблицей верхнего уровня

Читать полностью »

Для справки: xBase — семейство систем программирования, СУБД, берущих начало с dBase (1980 г.). Их объединяет общий язык программирования ( естественно, с вариациями, присущими конкретной реализации ) и встроенные в этот язык средства доступа к реляционным базам данных формата DBF. Собственно, dBase начинался как СУБД с языком, предназначеннным для обслуживания баз данных. Это процедурный язык программирования, он относится к группе интерпретируемых языков и обладает многими, если не всеми, их родовыми чертами, такими, например, как динамическая типизация.

Clipper, непосредственный предшественник Harbour, был создан в 1985 г. с целью повышения производительности dBase III. Для этого исходный код программы преобразовывался на стадии компиляции в байт-код, который встраивался в исполнямый файл вместе с виртуальной машиной, предназначенной для исполнения этого байт-кода. Таким образом, Clipper давал на выходе автономный exe файл, не требующий для своего запуска и выполнения внешнего интерпретатора, как в случае dBase или FoxBase ( другой популярный xBase продукт ).Читать полностью »

image
Мне всегда нравилось, когда заголовок однозначно говорит о том, что будет дальше, например, «Техасская резня бензопилой». Поэтому под катом мы действительно будем добавлять пространственный поиск к СУБД, в которой его изначально не было.
Читать полностью »

Аналитика в рознице: сегодня вы не купили презервативы, а магазин уже знает, когда вам пригодится скидка на детское питание
Вот как-то так это хитро работает

Про вашего будущего ребёнка – это, конечно, утрировано, но все может быть. На практике мы помогаем рознице бороться за каждый рубль с помощью математического аппарата. Вот, например, у вас в бумажнике есть карта лояльности, либо вы расплачиваетесь кредиткой. Это значит, что в целом магазин знает, сколько и каких продуктов вам надо. Дальше можно построить оптимальную модель вашего путешествия по магазину и понять, в какой ситуации вы купите больше. Что где должно стоять, какое молоко вы предпочитаете (вдруг вы готовы брать дорогое и натуральное без колебаний?) и так далее. Смоделировать вас по совокупности данных легко.

Такую же аналитику можно применять ко всем аспектам работы розницы.

Из смешного — один раз система просчитала, что будет выгодно уничтожить примерно полтонны бумаги. Сначала думали, что баг — но начали копать и выяснили, что поставщик даёт скидку за определённый порог закупки. А сеть может не успевать продавать нужное количество бумаги. С учётом стоимости склада, поставки и уровня скидки начиная с порога — проще взять и уничтожить кучу товара, чтобы получать его по цене ниже. Скидка минимум вдвое компенсирует убытки от его потери. Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js