
Как и многие россияне, в последнее время я каждый день захожу проголосовать на сайт 10russia.ru. Если кто не в курсе, Россия 10 — всероссийский проект, в рамках которого каждый может проголосовать за свой любимый географический или архитектурный объект в России. Задача проекта – выбор десяти новых визуальных символов России.
Мне показались странными цифры в ТОП2 в голосовании, и я решил посмотреть, как они меняются. Читать полностью »
Рубрика «data mining» - 92
Следим за голосованием на «Россия 10»
2013-08-30 в 8:35, admin, рубрики: data mining, php, голосование, метки: monitoring, голосованиеСистема персонализации News360: ранжирование кластеров информации
2013-08-28 в 9:00, admin, рубрики: data mining, искусственный интеллект, кластерный анализ, ранжирование, метки: кластерный анализ, ранжированиеКогда система рекомендаций работает с большим количеством контента, основной задачей становится не фильтрация этого контента, а его ранжирование. Если говорить о новостях — каждый день выходят сотни тысяч статей, тысячи из которых могут затрагивать интересы каждого человека, читающего новости. Но в основном пользователи не читают больше 5-10 статей в день (по данным News360). Какие статьи показать первыми?
Ответ на этот вопрос в News360 ищут уже третий год. Мы нашли уже много разных ответов, но в этом году решили отказаться от концепции, которая была основной на протяжении всех предыдущих лет.
В статье простыми словами постараюсь рассказать о том, почему в News360 сначала несколько лет работали над реализацией и развитием системы кластеризации статей по событиям и ранжирования событий, а затем выбросили этот подход и решили реализовать другой. А также немного о том, как работает News360, что под капотом и где об этом почитать.

Число Данбара и пользователи ВКонтакте
2013-08-07 в 12:24, admin, рубрики: data mining, Вконтакте, дружба, социальные сети, Социальные сети и сообщества, метки: Вконтакте, дружба, социальные сети  Недавно я наткнулся на такую удивительную штуку как число Данбара.
История такова. 20 с лишним лет назад, когда выражение «британские учёные» ещё не было мемом, антрополог Робин Данбар, изучая данные по человекообразным обезьянам, обнаружил, что численность их стаи подчиняется определённому закону. Есть максимальное количество членов стаи. Если стая рарастается и её численность превышает порог, она разделяется на две. Причём для разных видов этот предельный размер получается разным.
Читать полностью »
Вероятностные модели: борьба с циклами и вариационные приближения
2013-08-02 в 16:03, admin, рубрики: data mining, байесовские сети, Блог компании Surfingbird, искусственный интеллект, математика, математическое моделирование, теория вероятностей, метки: data mining, байесовские сети, математика, математическое моделирование, теория вероятностейВ четвёртой серии цикла о графических вероятностных моделях (часть 1, часть 2, часть 3) мы продолжим разговор о том, как справляться со сложными фактор-графами. В прошлый раз мы изучили алгоритм передачи сообщений, который, правда, работает только в тех случаях, когда фактор-граф представляет собой дерево, и в каждом узле можно без проблем пересчитать распределения грубой силой. Что делать в по-настоящему интересных случаях, когда в графе есть большие содержательные циклы, мы начнём обсуждать сегодня – поговорим о паре относительно простых методов и обсудим очень мощный, но непростой в использовании инструмент – вариационные приближения.
Решение задачи кластеризации методом градиентного спуска
2013-08-02 в 12:04, admin, рубрики: data mining, Алгоритмы, искусственный интеллект, кластеризация, метки: кластеризация  Привет. В этой статье будет рассмотрен способ кластеризации данных, используя метод градиентного спуска. Честно говоря данный способ носит больше академический характер, нежели практический. Реализация этого метода мне понадобилась в демонстрационных целях для курса по машинному обучению, что бы показать как одинаковые задачи можно решить различными способами. Хотя конечно если вы планируете осуществить кластеризацию данных, используя дифференцируемую метрику, для которой вычислительно труднее найти центроид, нежели подсчитать градиент на некотором наборе данных, то этот метод может быть полезным. Итак если вам интересно как можно решить задачу k-means кластеризации с обобщенной метрикой используя метод градиентного спуска, прошу под кат. Код на языке R.
Интеллектуальное извлечение данных. Основы web data extraction
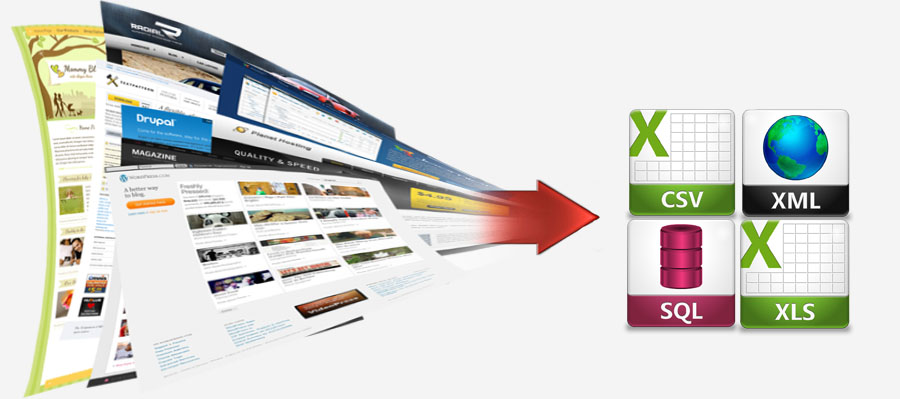
2013-07-30 в 9:18, admin, рубрики: big data, data mining, метки: big data, data mining Мы (да и не только мы) уже рассказывали на хабре пару раз о проекте интеллектуального извлечения данных Convextra. Но предыдущие статьи это, по сути, обзоры сервиса, и его функциональности, а сегодня я хотел бы затронуть теоретическую и технологическую сторону вопроса извлечения данных. В русскоязычном сегменте очень немного информации, посвященной данной теме, и почти полностью отсутствует статьи о механизмах полуавтоматического или автоматического (интеллектуального) извлечения данных. Так как data extraction имеет непосредственное отношение к таким актуальным темам как data mining и Big Data, то, думаю, восполнение «информационного пробела» будет интересно довольно широкой аудитории. Намеренно постараюсь излагать на простом языке, поближе к этой самой «широкой аудитории». А извращенцев любителей матана ждут ссылки на источники внизу статьи, пройдя по которым, можно удовлетворить себя формулами, дифурами, матмоделями и строгим математическим описанием некоторых вопросов.
Скрытые цепи Маркова, алгоритм Баума-Велша
2013-07-29 в 21:30, admin, рубрики: data mining, Алгоритмы, алгоритмы классификации, метки: data mining, алгоритмы классификацииСкрытые модели/цепи Маркова одни из подходов к представлению данных. Мне очень понравилось как обобщается множество таких подходов в этой статье.
В продолжение же моей предыдущей статьи описания скрытых моделей Маркова, задамся вопросом: откуда взять хорошую модель? Ответ достаточно стандартен, взять неплохую модель и сделать из нее хорошую.
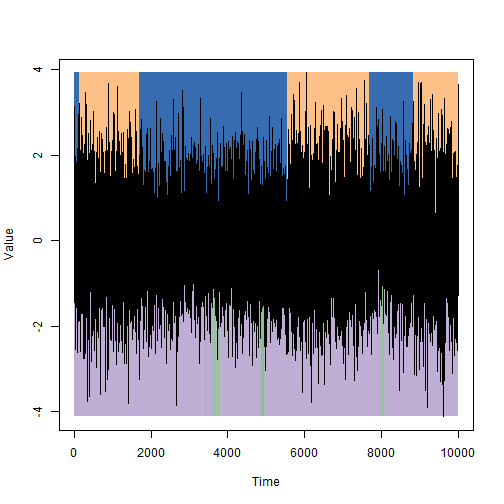
Напомню пример: нам нужно реализовать детектор лжи, который по подрагиванию рук человека, определяет, говорит он правду или нет. Допустим, когда человек лжет, руки трясутся чуть больше, но нам не известно на сколько именно. Возьмем модель наобум, прогоним алгоритм Витерби из предыдущей статьи и получим довольно странные результаты:
Читать полностью »
Разбираем «Противостояние — Военная хроника» (1996-1997гг, Дока)
2013-07-18 в 10:51, admin, рубрики: data mining, hex редакор, reverse engineering, Восстановление данных, реверс-инжиниринг, Стратегия, метки: hex редакор, reverse engineering, реверс-инжиниринг, СтратегияВступление
Добрый всем, хочу рассказать про тёплую и ламповую стратегию детства — Противостояние. Игра была выпущена в 1996-98 гг нашей Российской фирмой Дока.
Игра — стратегия в реальном времени про вторую мировую войну. Спустя много лет я решил сперва пройти её и записать прохождение, а затем постараться по максимуму продлить удовольствие от игры, распаковывая ресурсы и пытаясь понять игровую логику.
Под катом я опишу процесс извлечения музыки, графики и немножко не дотяну до редактора карт.
Так же в описании будут отсылки на 8-битную палитру цветов, псевдоархивы, RLE-сжатие и чуток HEX-редактора. В самом коде я подсмотрел только алгоритм декодирования изображений, сжатый RLE.

Практическая некромантия на примере игры Gulf War: Operation Desert Hammer (1999г)
2013-07-15 в 10:31, admin, рубрики: data mining, reverse engineering, Восстановление данных, ностальгия, ретро, форматы файлов, метки: reverse engineering, ностальгия, ретро, форматы файлов Добрый всем!
Всё началось со шкафа со старыми играми. Лет 10 назад взял у друга игру, положил её в тумбочку и вспомнил о ней через 10 лет. Заинтересовался, что за игра такая, мне неизвестная. Оказалось что это танковая аркада 1999 года, от фирмы 3DO, о похождениях супер-американского танка во время войны в заливе.

Предобучение ограниченными машинами Больцмана для распознавания реальных изображений
2013-07-11 в 16:49, admin, рубрики: data mining, machine learning, restricted boltzmann machine, искусственный интеллект, машина Больцмана, машинное обучение, нейронные сети, ограниченная машина больцмана, метки: machine learning, restricted boltzmann machine, машина Больцмана, машинное обучение, нейронные сети, ограниченная машина больцмана 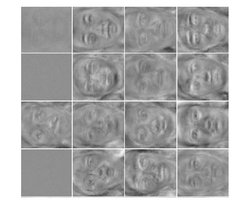
Доброго времени суток. Этот топик рассчитан на тех, кто имеет представление об ограниченных машинах Больцмана (restricted Boltzmann machine, RBM) и их использовании для предобучения нейронных сетей. В нем мы рассмотрим особенности применения ограниченных машин Больцмана для работы с изображениями, взятыми из реального мира, поймем, почему стандартные типы нейронов плохо подходят для этой задачи и как их улучшить, а также немного пораспознаем выражения эмоций на человеческих лицах в качестве эксперимента. Те, кто представления o RBM не имеет, могут его получить, в частности, отсюда:
Реализация Restricted Boltzmann machine на c#,
Предобучение нейронной сети с использованием ограниченной машины Больцмана
Читать полностью »