Рубрика «data mining» - 93

На данный момент большой проблемой распознавания речи (и смысла текста) является сложность предугадать смысл, а точнее контекст в котором находится слово. Часть проблемы решается дополнительным анализом соседних слов и предложения, а в тексте также анализируются заголовки документов. Большая проблема состоит в сложности реализации алгоритмов, особенно если речь идет о мобильных приложениях которые имеют ограниченные ресурсы.

Проблема может быть решена если автор приложения сам укажет контекст в котором произнесена фраза или написано сообщение для анализа.
Читать полностью »
После большого перерыва продолжаем цикл о графических вероятностных моделях (часть 1, часть 2). Сегодня мы наконец-то от постановок задач перейдём к алгоритмам; поговорим мы о самом простом, но часто полезном алгоритме вывода на фактор-графах – алгоритме передачи сообщений. Или, как его ещё можно назвать, алгоритме правильной расстановки скобок.

Вероятностные модели: искусство расставлять скобки
by sergey-lesiuk
Читать полностью »

Многие из нас на сегодня уже слышали про проект PRISM от Агенства Hациональной Безопасноти США. Вкратце, данный проект собирает всю информацию о так называемых «подозреваемых пользователях». Зашифрованные email-ы хранятся у этих ребят без срока давности до расшифровки, по нажатию кнопки сотрудник АHБ может получить доступ к вашему Фейсбук аккаунту, ко всем данным Гугла (например вашим поисковым запросам), и даже к удалённым вами письмам. Данная ситуация подвергает надруганию не только в нашу и вашу личную жизнь (на что сотрудникам АHБ в принципе наплевать), но и в личную жизнь граждан США (с чем сотрудникам АHБ приходится считаться). Но давайте отступим на минутку от истерики и вооружившись здоровой паранойей взглянем на ситуацию под другим углом.
Читать полностью »

Фильтрация смс спама с помощью наивного байесовского классификатора (код на R) Привет. В этом посте мы рассмотрим простую модель фильтрации спама с помощью наивного байесовского классификатора с размытием по Лапласу, напишем несколько строк кода на R, и, наконец, протестируем на англоязычной базе данных смс спама. Вообще, на хабре я нашел две статьи посвященные данной теме, но ни в одной не было наглядного примера, чтобы можно было скачать код и посмотреть результат. Также не было упоминания про размытие, что существенно увеличивает качество модели, без особых затрат усилий, в отличие, скажем, от сложной предобработки текста. Но вообще, запилить очередной пост про наивного байеса меня побудило то, что я пишу методичку для студентов с примерами кода на R, вот и решил поделиться инфой.

Читать полностью »

В современном мире отношения между людьми помимо социального уровня заняли еще один — цифровой. С распространением виртуальных социальных сетей появилась тенденция иметь собственную страницу с персональными данными, искать друзей по интересам, создавать группы и пр. Количество информации в соцсетях постоянно увеличивается. Возникла мысль обработать данные, которые, на первый взгляд, не кажутся полезными, но после обработки вполне могут послужить на благое дело.

В данной статье рассматривается поиск наиболее влиятельных объектов. Данная информация может быть полезна как для проведения различных виртуальных маркетинговых акций, так и для выявления пользователей с подозрительно высокой активностью.
Читать полностью »

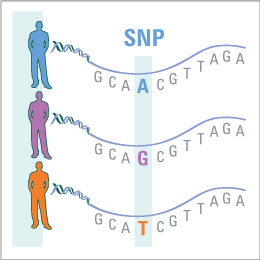
Метод опорных векторов для нахождения полиморфизмов в геноме Статья 2013-ого года «A support vector machine for identification of single-nucleotide polymorphisms from next-generation sequencing data» (O'Fallon, Wooderchak-Donahue, Crockett) предлагает новый метод определения полиформизмов в геноме на основе применения метода опорных векторов (SVM). Хотя ранее в статье 2011-ого года «A framework for variation discovery and genotyping using next-generation DNA sequencing data» уже описывалось применение методов машинного обучения для определения однонуклеотидных полиморфизмов (SNP-ов, снипов), подход, основанный на использовании SVM, описан впервые в данной статье.

Определение полиморфизмов в геноме является важной (например, для полногеномного поиска ассоциаций aka GWAS), но нетривиальной задачей. Приходится учитывать, что многие организмы гетерозиготны, а также, что данные могут содержать ошибочную информацию.
Читать полностью »

В MarkLogic Server реализован собственный диалект XQuery, который называется XQuery 1.0-ml. Не трудно догадаться, что это — тот самый XQuery 1.0 с некоторыми дополнениями от MarkLogic, призванными сделать жизнь разработчика лучше. Читать полностью »

Здравствуйте.

Понадобилось мне использовать для анализа данных OLAP кубы. Эту технологию я активно изучал и использовал в 2001-2002 годах и даже сертифицировался по ней. Но потом долгое время не прикасался к ней. И вот совсем недавно попробовал воспользоваться 2012 SQL Server’ом, но не тут то было: многое и того что появилось в новом сервере оказалось мне совершенно не знакомым.

Потратив некоторое время на знакомство, решил поделиться навыками с сообществом: записал обучающий видеоролик о том, как создается куб и измерения.

Ролик ознакомительный, возможно, некоторые вещи сделаны неправильно, но пример вполне рабочий. Предполагается, что читатель (зритель) уже знаком с понятиями многомерного куба, измерений, мер и для чего это используется.

Читать полностью »

Ларри Пейдж о программе PRISM: «What the ...?»
Штаб-квартира АНБ

Как известно, 6 июня газета The Washington Post опубликовала слайды из презентации PowerPoint, в которой речь идёт о секретной программе АНБ по наблюдению за гражданским населением. Якобы, в рамках программы PRISM девять интернет-компаний предоставляли АНБ прямой доступ к своим серверам для получения информации о пользователях: Microsoft, Yahoo, Google, Facebook, PalTalk, YouTube, Skype, AOL и Apple.
Читать полностью »

Поиск Яндекса сможет адаптироваться к вашим интересам за несколько секундС сегодняшнего дня поиск Яндекса персонализирует ответ не только на основе истории ваших интересов — он будет учитывать и то, что вы делаете на поиске прямо сейчас. Это важное изменение для пользователей: от того, чем мы занимаемся сейчас, зависит то, что мы ожидаем получить в ответ. Поиск Яндекса становится адаптивным. Чтобы это стало возможным, нам пришлось реализовать новую технологию доставки данных в реальном времени.

Чтобы понять, что хочет пользователь, нужен контекст. Когда-то всем контекстом, который был доступен Яндексу, был текст поискового запроса. Со временем мы научились учитывать, из какого региона его задают.

Важным этапом стала персонализация ответа для разных пользователей — мы стали использовать знания о конкретном человеке, чтобы дать ему более точный ответ. Для этого мы использовали данные, посчитанные на истории запросов и кликов пользователя. Причём они были посчитаны как по истории за длинный период, так и по недавней. Мы рассказывали на Хабре об этом этапе.

Каждый раз дополнение пользовательского контекста влечёт за собой изменение качества работы системы, а иногда и пользовательского поведения.Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js