Рубрика «data mining» - 94

Как Яндекс распознаёт музыку с микрофонаПоиск по каталогу музыки — это задача, которую можно решать разными путями, как с точки зрения пользователя, так и технологически. Яндекс уже довольно давно научился искать и по названиям композиций, и по текстам песен. На сказанные голосом запросы про музыку мы тоже умеем отвечать в Яндекс.Поиске под iOS и Android, сегодня же речь пойдёт о поиске по аудиосигналу, а если конкретно — по записанному с микрофона фрагменту музыкального произведения. Именно такая функция встроена в мобильное приложение Яндекс.Музыки:
imageКак Яндекс распознаёт музыку с микрофона

Помогать пользователям в решении этой задачи готовы буквально несколько компаний. Несмотря на то, что нам предстоит ещё немало сделать, качество распознавания уже сопоставимо с лидерами в этой области. К тому же поиск музыки по аудиофрагменту не самая тривиальная и освещённая в Рунете тема; надеемся, что многим будет любопытно узнать подробности.
Читать полностью »

Nelson Mandela said: “Education is the most powerful weapon
which you can use to change the world.”

Волею судеб нам посчастливилось стать одними из участников курса по Data Mining (программа GameChangers, Санкт-Петербург). Цель курса – изучение методов и технологий обработки данных в различных областях IT-индустрии. Лекции у нас читают эксперты из крупнейших IT компаний, а студенты работают над реальными задачами и проектами.
И так получилось, что в рамках данного курса наша рабочая группа занимается разработкой проекта в области Educational Data Mining.

В России пока единицы знают о существовании этого направления, поэтому для начала в общих чертах расскажем про EDM: общие цели, кто может использовать и зачем.
Читать полностью »

Оптимизация общественного транспорта после анализа данных GSMГруппа исследователей из IBM, используя информацию о перемещениях 500 тыс. пользователей мобильной связи, разработали модель для улучшения маршрутов общественного транспорта.

Модель успешно опробовали в городе Абиджан (население 3,8 млн человек, столица Кот-д’Ивуара). На иллюстрации показаны действующие маршруты автобусов (малиновым) и улучшения, предлагаемые алгоритмом (синим). Он предложил 65 возможных улучшений, в том числе три новых маршрута, с общей экономией времени 10% в пассажиро-минутах для всех пассажиров, учитывая время поездки и время ожидания.

Новый алгоритм полезен не только для оптимизации, но и для прокладки новых маршрутов в только что построенных микрорайонах. Здесь он чётко показывает, какими путями, в какое время и в каком объёме передвигается людская масса. Можно составить оптимальные маршруты и расписание транспорта. Важен сам факт появления нового инструмента, который могут использовать городские власти для оптимизации инфраструктуры мегаполиса.
Читать полностью »

IBM Watson будет работать в колл центрах служб поддержкиВ одних только США на работу колл-центров служб поддержки пользователей ежегодно тратится 112 миллиардов долларов. При этом половина из 270 миллиардов обращений остаётся нерешённой. Почти каждый может вспомнить множество примеров, когда звонок в службу поддержки превращался в длительный квест по выслушиванию записанных стандартных фраз и нажиманию цифровых кнопок только для того, чтобы пообщаться с живым человеком и обнаружить, что он и сам толком не разбирается в вашей проблеме.

Суперкомпьютеру Watson, который обыгрывает чемпионов викторин и уже приступил к работе онколога-диагноста в некоторых больницах Америки, вполне по силам справиться и с этой работой — считают в IBM. По данным компании, почти две трети из нерешённых вопросов клиентов могли бы быть решены, если бы сотрудники колл-центров могли искать информацию быстрее. Такой поиск в среднем занимает от шести до девяти минут на один звонок.

В ближайшие месяцы тестирование Watson в службах поддержки начнут первые клиенты IBM — австралийский банк ANZ, Royal Bank of Canada, компания Nielsen, занимающаяся исследованием потребительского поведения, израильский мобильный оператор Celcom, консалтинговая и аналитическая компания IHS. Watson будет общаться с клиентами этих компаний по разнообразным каналам — в чатах, по почте, через мобильные приложения. Некоторые компании намерены даже приобрести системы распознавания голоса, чтобы Watson мог говорить по телефону.
Читать полностью »

Начинающие data scientists к вашим услугам На Coursera сейчас идёт курс Introduction to Data Science от University of Washington, в ходе которого студентов будут учить работе с большими массивами данных, статистическому анализу, data mining, алгоритмам машинного обучения и прочим таким вещам. Авторы курса приглашают организации (коммерческие, некоммерческие и даже просто отдельных людей), которым будет полезна помощь в работе с данными, принять участие, подкинув студентам для решения задачи из реальной жизни.

Схема примерно такая: организация формулирует задачу и предоставляет данные (собственные или из открытых источников), студенты её решают и пишут отчёт. Отчёт потом оценивается другими студентами, плюс организация даёт свой отзыв о работе.
В полюсе все: организация бесплатно получает рабочие руки мозги, а студент — опыт.
Читать полностью »

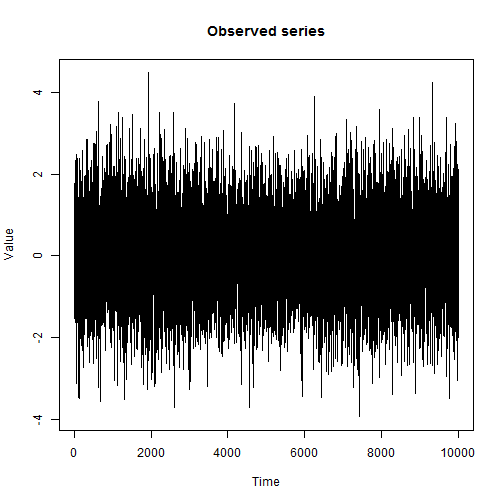
Нам нужно реализовать детектор лжи, который по подрагиванию рук человека, определяет, говорит он правду или нет. Допустим, когда человек лжет, руки трясутся чуть больше. Сигнал может быть таким:

Исходный сигнал

Интересный метод, описан в статье «A Tutorial on Hidden Markov Models and Selected Applications in Speech Recognition» L.R. Rabiner, которая вводит модель скрытой цепи Маркова и описывает три ценных алгоритма: The Forward-Backward Procedure, Viterbi Algorithm и Baum-Welch reestimation. Несмотря на то, что эти алгоритмы представляют интерес только в совокупности, для большего понимания описывать их лучше по отдельности.
Читать полностью »

Отголоски прошлого — получение данных из framework database 3В данной статье я хочу рассказать вам об недавно приключившейся со мной ситуации и принятому пути ее решения. Я не профессиональный программист, однако небольшой опыт мне помог решить данную задачу.

Сразу хочется обратить ваше внимание, что речь в данной статье не пойдет о «популярном фреймворке» для какого-либо языка программирования, речь пойдет о стареньком «framework» для ms dos и разборе формата, в котором оной хранит данные с дальнейшим преобразованием этих данных к одному из современных форматов баз данных.
Читать полностью »

Пару месяцев назад на хабре уже проскальзывало упоминание о сервисе извлечения данных с веб-страниц Convextra, который позволяет парсить даже сложные структуры данных буквально в 2-3 клика. Несмотря на то, что на момент написания той статьи сервис находился в альфа стадии и больше глючил, чем работал, аудитория хабра тепло восприняла идею и мы получили много полезных отзывов, предложений и багрепортов. Поэтому хочется рассказать о том, что из предложенного вами и в каком виде удалось реализовать за это время.

Читать полностью »

Data mining: Инструментарий — Theano
В предыдущих материалах этого цикла мы рассматривали методы предварительной обработки данных при помощи СУБД. Это может быть полезно при очень больших объемах обрабатываемой информации. В этой статье я продолжу описывать инструменты для интеллектуальной обработки больших объёмов данных, остановившись на использовании Python и Theano.
Читать полностью »

Как выглядят переводы? Это документ, оформленный на другом сайте, других страницах, но который повторяет последовательность мыслей автора и структуру его текста. Бывает, что авторский текст меняется, особенно часто это случается в документации — основном профессиональном применении переводов, с которыми приходится встречаться программистам и другим пользователям технической продукции. Если привязать перевод к исходному коду статьи, документации или книги так, чтобы скрипт показа перевода следовал по структуре, проверял изменения и отмечал непереведённое, то становится очень легко следить за изменениями текстов и переводить изменения. Новые версии текстов не становятся слишком отличными от старых и прежние переводы остаются частично работать. Перевод сам будет следить за своей актуальностью. Все прочие тексты будут представлять собой просто слепки, имеющие меньшую ценность, чем созданный и поддерживаемый таким способом перевод. Да, за их состоянием скрипт или сервер может следить, чтобы вовремя сообщить держателям слепков об устаревании. Слепки полезны не только как источник контента владельцам сторонних ресурсов, но нужны пользователям для работы в оффлайне или в составе пользовательских программ. Но более ценным будет всё же перевод, привязанный к структуре и оформлению оригинала. Он же поможет следить не за копией сайта, а за самим оригинальным сайтом в случае работы с документацией.
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js