
Рубрика «ml» - 8

Введение

В декабре 2025 года VK провёл RecSys Challenge LSVD — соревнование по машинному обучению с нестандартной постановкой задачи. Традиционные рекомендательные системы решают проблему "что показать пользователю", но здесь требовалось обратное: для каждого нового клипа определить, каким пользователям он может быть интересен. Такой подход помогает решать проблему холодного старта контента, когда новое видео только появляется в системе и не имеет истории взаимодействий.

Я принял участие в этом челлендже и хочу поделиться своим решением, архитектурой системы и практическими выводами.
Постановка задачи и данные

Читать полностью »

Пятница, 17:43. Твоя модель тренируется уже шесть часов. Loss красиво падает, метрики растут — ещё пара эпох и можно будет отправить результаты с победным эмодзи.

И тут приходит сообщение: «Срочно глянь PR, блокер для релиза».

Ты смотришь на терминал. Потом в чат. Потом снова на терминал.

git checkout feature/urgent-fix убьёт твой эксперимент. git stash — это русская рулетка для ML-кода с его конфигами, весами и кешами. Клонировать репозиторий заново? 47 гигабайт датасетов скажут тебе «спасибо».

Знакомо?

Большинство ML-инженеров живут в этом аду переключения контекста годами. А потом узнают про git worktreeЧитать полностью »

Всем привет! В этой небольшой статье хочу поделиться своим первым опытом работы с ML-моделями.

С чего все началось?

В начале 3 семестра я попал на проект ВУЗа, связанный с НС. Прошел курс по сеткам, пробежался по Pytorch и приступил к задачам на проекте. В процессе своего спринта решил параллельно изучать классический ML, где собственно выяснил, что "Hello world!" в мире машинного обучения является работа с датасетом титаник (предсказать выжил ли пассажир или нет). После этого ознакомился с Kaggle и полетел!

Titanic - Machine Learning from Disaster

При открытии "компетитив" сразу же наткнулся на тот самый Читать полностью »

Однажды, в начале третьего лета нейронок, на меня вышел представитель одного красного нефтехимического концерна. Прежде, его подразделение занималось цифровыми двойниками производств, но тут тема была интереснее - полидировать тему с машинным обучением для оптимизации Химико-Технологических процессов (ХТП). Соблазн повтирать очки был очень велик, но, я не берусь за проекта, которые сам считаю нереализуемыми.

Читать полностью »

В предыдущей статье "Почему нейросети не заменят прикладных специалистов: простая логика против вероятностных подходов" рассматривались общие вопросы поиска решений управляемого данными. Эта информационная технология, основанная на простой логике, позволяет оперативно вести диалог с пользователем, используя накопленные в процессе поиска решения данные. Для того чтобы это работало - требуется фрагментировать знания предметной области в виде функций с заданными областями допустимых значений входящих в них параметров.

Читать полностью »

Нейросети помогают решать множество повседневных задач. Однако идея, сначала «развалить» всё и токенезировать, а затем пытаться сложить из фрагментов целое — с точки зрения математики выглядит, конечно, красиво, но с точки зрения простой логики идея спорная.

Это статья о том, что такое инженерное мышление и, как правильная формализация предметных знаний способствует реализации экспертных систем с применением простой логики.

Читать полностью »

Я уверен, вы видели модели машинного обучения, которые принимают текст и предсказывают, является ли он спамом. Аналогично модель может проанализировать отзыв о фильме и определить его тональность — положительную или отрицательную, понимать что «груша» связана с «яблоком» куда больше, чем с «теплоходом».

Первое правило обучения любой модели машинного обучения — это преобразование входных данных в числа. Любой цифровой объект можно представить как некое число: картинку, текст, аудио или видеофайл — практически всё что угодно.

Читать полностью »

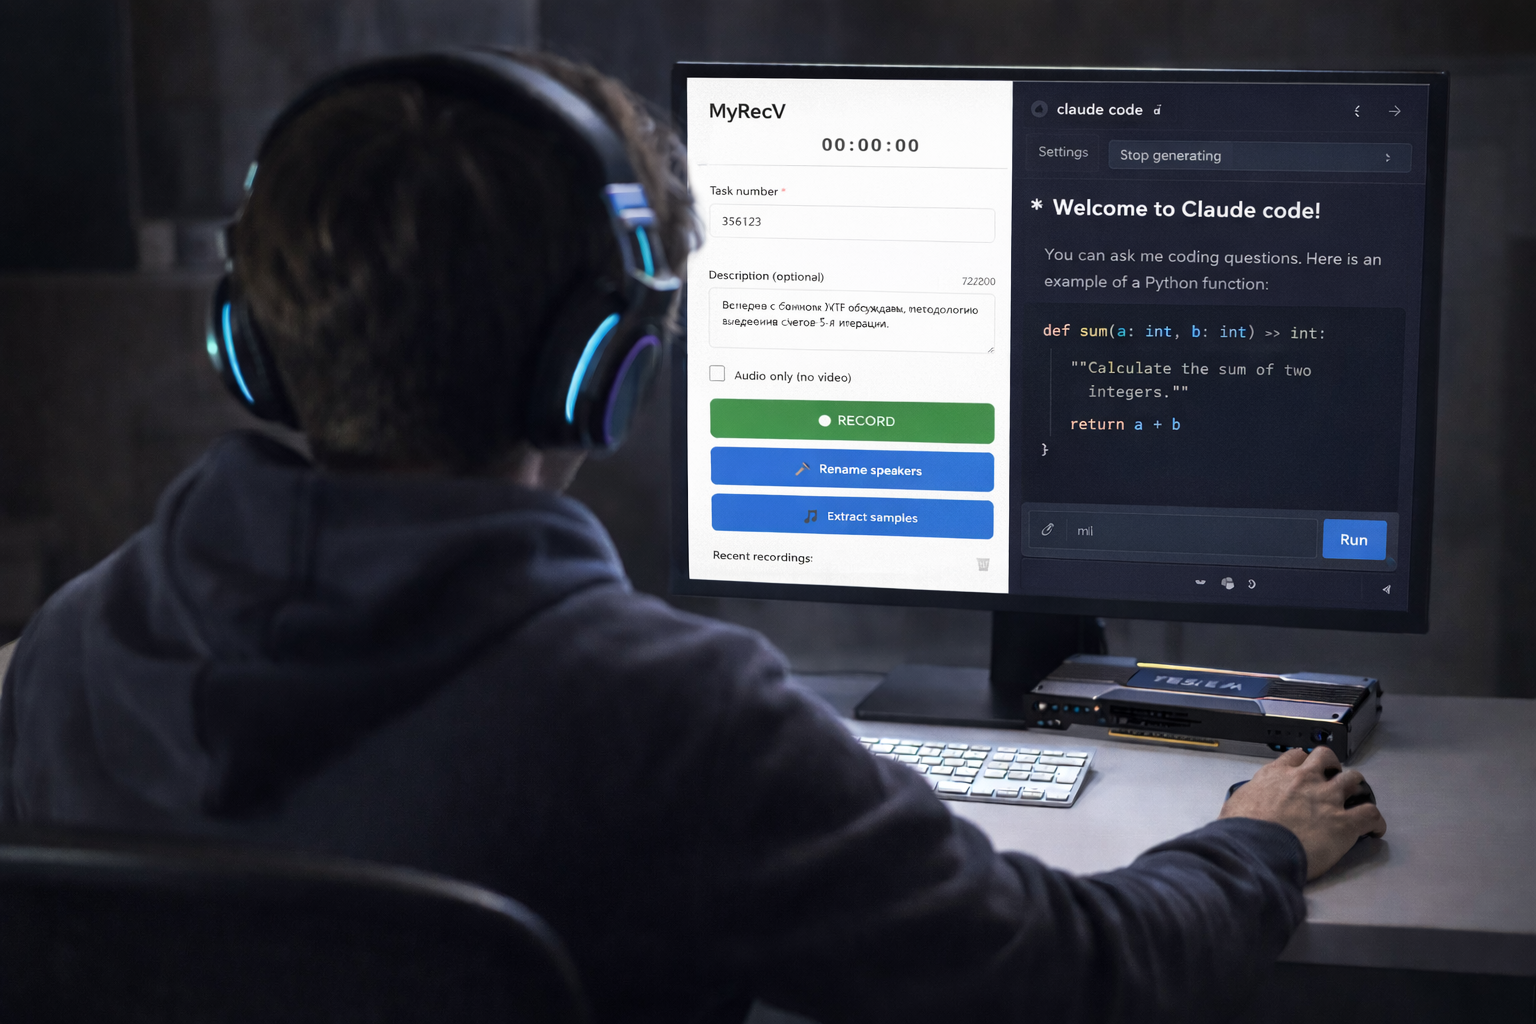
Как я решил проблему длинных совещаний вайбкодингом и китайской видеокартой - 1

Еще одна статья про whisper + pyannote для транскрибации совещаний? Да, но нет.

Читать полностью »

Про AI сейчас пишут много, мягко говоря. Причём пишут буквально все, кому не лень. Но если вы PHP-разработчик, то, скорее всего, ощущение примерно такое: тема вроде бы важная, но почти всё – не для вас, а двигаться в эту сторону нужно, ибо... ну, вы и сами понимаете.

Большинство материалов сразу уезжают в Python, Jupyter, PyTorch, обучение моделей, математику и датасеты. Даже когда речь идёт не про data science, а про практику – примеры всё равно из другого мира.

Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js