Рубрика «python» - 188

Привет.
Наверняка многие об этом задумывались, возможно у кого то эта идея лежит в TODO. У меня она пролежала примерно год, но таки удалось ее реализовать в виде работающего прототипа.

TgCloud:

  • Виртуальная файловая система с открытым исходным г****кодом.
  • На локальном диске — только метаданные: имена, размер, структура папок и т.д.
  • Данные хранятся в Telegram и загружаются только при работе с файлом
  • Размер и тип файлов не ограничен, можно использовать с любой ОС

Telegram. Безлимитный сетевой диск. Бесплатный - 1
Подробности реализации и ссылка на репозиторий — под катом
Читать полностью »

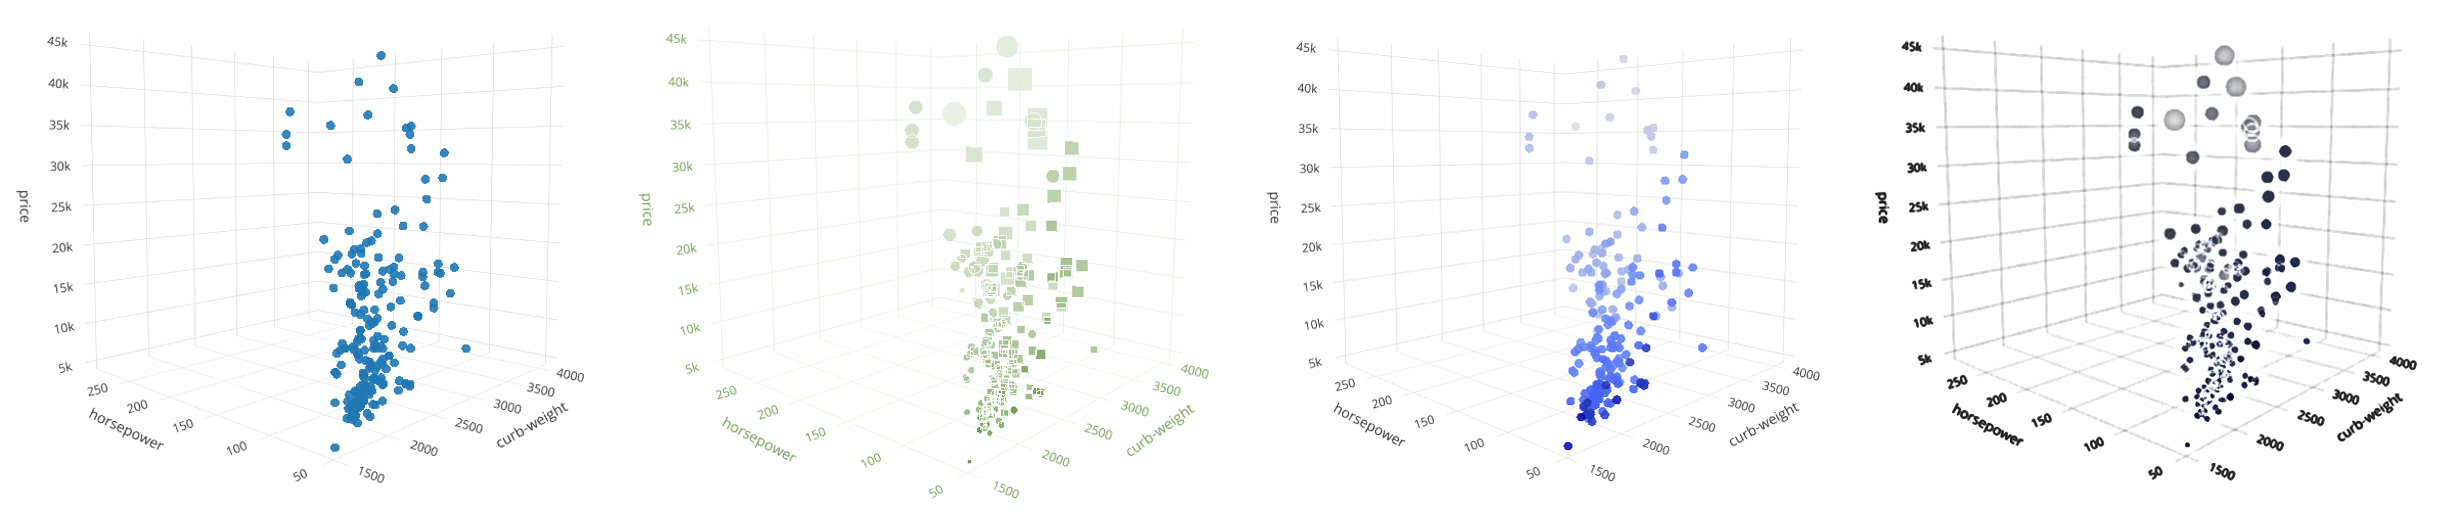
Многомерные графики в Python — от трёхмерных и до шестимерных - 1

Примеры многомерных графиков

Введение

Визуализация — важная часть анализа данных, а способность посмотреть на несколько измерений одновременно эту задачу облегчает. В туториале мы будем рисовать графики вплоть до 6 измерений.

Plotly — это питоновская библиотека с открытым исходным кодом для разнообразной визуализации, которая предлагает гораздо больше настроек, чем известные matplotlib и seaborn. Модуль устанавливается как обычно — pip install plotly. Его мы и будем использовать для рисования графиков.

Давайте подготовим данные

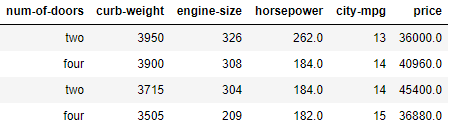
Для визуализации мы используем простые данные об автомобилях от UCI (Калифорнийский университет в Ирвине — прим. перев.), которые представляют собой 26 характеристик для 205 машин (26 столбцов на 205 строк). Для визуализации шести измерений мы возьмём такие шесть параметров.

Многомерные графики в Python — от трёхмерных и до шестимерных - 2

Здесь показаны только 4 строки из 205

Загрузим данные из CSV с помощью pandas.

import pandas as pd
data = pd.read_csv("cars.csv")

Теперь, подготовившись, начнем с двух измерений.

Читать полностью »

Зачем нужен __init__.py знает, наверное, любой питонист, но что насчёт __main__.py? Я видел немало проектов либо рабочих, либо на Github, которые не используют это магический файл, хотя могли бы сделать свою жизнь проще. На мой взгляд, __main__.py это лучший способ для взаимодействия с питоновскими модулями, состоящими из нескольких файлов.

Но давайте сначала разберёмся: как большинство людей запускают свои скрипты на Python?

Однажды вы напишете программу, которую захотите использовать и как импортируемый модуль, и как инструмент запускаемый из командной строки. Вы скорей всего в курсе, как обычно поступают в этом случае:

if __name__ == '__main__':
    main(sys.argv)

Когда вы скармливаете скрипт интерпретатору, магическая глобальная переменная __name__ получает значение __main__. Таким образом мы узнаём, что это не импорт, а именно запуск. Например:

python myapp.py

И это прекрасно работает для одиночного файла.

Проблема

Но если вы похожи на меня, вы не захотите, чтобы всё ваше приложение теснилось в единственном файле. Разбиение логики по разным файлам упрощает редактирование и поддержку. Например:

.
├── README.me
├── requirements.txt
├── setup.py
└── src
    ├── __init__.py
    ├── client.py
    ├── logic.py
    ├── models.py
    └── run.py

Но пользователю, который склонировал проект из репозитория будет не понятно — какой из этих файлов главный? Неужели run.py? А может client.py? Где же искать знакомую строку if __name__ == '__main__'? Вот здесь-то __main__.py и способен проявить себя.

Читать полностью »

Хабр, привет.

Сегодня у нас пост с интересным заданием — будем обучать логистическую регрессию с L1 и L2 регуляризациями с помощью метода Stochastic Gradient Descent (SGD).

image

Перед тем как приступить к статье и коду, беглым шагом пробежимся по основным понятиям L1 и L2 регуляризации, логистической регрессии и стахостического градиентного спуска (Stochastic Gradient Descent — SGD).Читать полностью »

Доброго времени суток, уважаемые читатели!

Сегодня DevOps находится на волне успеха. Практически на любой конференции, посвященной автоматизации, можно услышать от спикера мол “мы внедрили DevOps и тут и там, применили это и то, вести проекты стало значительно проще и т. д. и т. п.”. И это похвально. Но, как правило, внедрение DevOps во многих компаниях заканчивается на этапе автоматизации IT Operations, и очень мало кто говорит о внедрении DevOps непосредственно в сам процесс разработки.

Мне бы хотелось исправить это маленькое недоразумение. DevOps в разработку может прийти через формализацию кодовой базы, например, при написании GUI для REST API.

В этой статье хотелось бы поделиться с вами решением нестандартного кейса, с которым столкнулась наша компания – нам довелось автоматизировать формирование интерфейса веб-приложения. Я вам расскажу о том, как мы пришли к данной задачей и что использовали для ее решения. Мы не считаем, что наш подход является единственно верным, но нам он очень даже нравится.

Надеюсь данный материал будет вам интересен и полезен.

Ну что ж, начнем!
Читать полностью »

Прошло немало времени с тех пор, как мы рассказывали о том, что нового в змеиной стране. Mamba всё еще быстра, поддерживает больше операций Conda и отрастила хвост (бэкенд) посолиднее благодаря изменениям в libsolv.

Что нового в разработке Mamba - 1

Ускоряем змею!

А что такое Mamba?

Mamba — это drop-in замена Conda, потрясающего кросс-платформенного менеджера пакетов. На наш взгляд у Conda есть один фатальный недостаток: она слишком медленная, когда много пакетов уже установлено или при одновременной установке нескольких пакетов. Mamba по-прежнему использует Conda почти для всего, кроме разрешения зависимостей. Мы заменили эту часть Conda на альтернативную реализацию под названием libsolv — C библиотеку, которая уже лежит в основе менеджеров пакетов в Linux системах типа dnf в Fedora или zypper в OpenSuse.

Интерфейс командной строки, работа с окружением, формат файла пакета, процесс установки, формат repodata и всё остальное — один-в-один как в Conda и работает на том же питоновском коде, что и Conda. Так что отличие, и правда, только в разрешении зависимостей!

Читать полностью »

«Пять экзабайт информации создано человечеством с момента зарождения цивилизации до 2003 года, но столько же сейчас создаётся каждые два дня». Эрик Шмидт

Обзор Python-пакета Datatable - 1


Datatable — это Python-библиотека для выполнения эффективной многопоточной обработки данных. Datatable поддерживает наборы данных, которые не помещаются в памяти.

Если вы пишете на R, то вы, вероятно, уже используете пакет data.table. Data.table — это расширение R-пакета data.frame. Кроме того, без этого пакета не обойтись тем, кто пользуется R для быстрой агрегации больших наборов данных (речь идёт, в частности, о 100 Гб данных в RAM).

Пакет data.table для R весьма гибок и производителен. Пользоваться им легко и удобно, программы, в которых он применяется, пишутся довольно быстро. Этот пакет широко известен в кругах R-программистов. Его загружают более 400 тысяч раз в месяц, он используется в почти 650 CRAN и Bioconductor-пакетах (источник).

Какая от всего этого польза для тех, кто занимается анализом данных на Python? Всё дело в том, что существует Python-пакет datatable, являющийся аналогом data.table из мира R. Пакет datatable чётко ориентирован на обработку больших наборов данных. Он отличается высокой производительностью — как при работе с данными, которые полностью помещаются в оперативной памяти, так и при работе с данными, размер которых превышает объём доступной RAM. Он поддерживает и многопоточную обработку данных. В целом, пакет datatable вполне можно назвать младшим братом data.table.
Читать полностью »

Введение

При проведении CWT анализа средствами библиотеки PyWavelets (бесплатное программное обеспечение с открытым исходным кодом, выпущенное по лицензии MIT) возникают проблемы с визуализацией результата. Предложенная разработчиками тестовая программа по визуализации приведена в следующем листинге:

Листинг

 import pywt
import numpy as np
import matplotlib.pyplot as plt
t = np.linspace(-1, 1, 200, endpoint=False)
sig  = np.cos(2 * np.pi * 7 * t) + np.real(np.exp(-7*(t-0.4)**2)*np.exp(1j*2*np.pi*2*(t-0.4)))
widths = np.arange(1, 31)
cwtmatr, freqs = pywt.cwt(sig, widths, 'cmor1-1.5')
plt.imshow(cwtmatr, extent=[-1, 1, 1, 31], cmap='PRGn', aspect='auto',
             vmax=abs(cwtmatr).max(), vmin=-abs(cwtmatr).max())  # doctest: +SKIP
plt.show() # doctest: +SKIP

При работе с комплексными вейвлетами, например с 'cmor1-1.5', программа выдаёт ошибку:

File"C:UsersUserAppDataLocalProgramsPythonPython36libsite-packagesmatplotlibimage.py", line 642, in set_data
    raise TypeError("Image data cannot be converted to float")
TypeError: Image data cannot be converted to float

Указанная ошибка, а так же сложности с выбором масштаба (widths) для обеспечения необходимого временного разрешения, затрудняют, особенно для начинающих пользователей, изучение CWT анализа, что и побудило меня к написанию данной статьи учебного характера.

Целью настоящей публикации является рассмотрение применения нового модуля визуализации scaleogram для анализа простых и специальных сигналов, а так же при использовании методов нормализации, логарифмического масштабирования и синтеза, которые позволяют получить дополнительную информацию при анализе временных рядов.
Читать полностью »

image

Эта статья об агентах машинного обучения в Unity написана Майклом Лэнхемом — техническим новатором, активным разработчиком под Unity, консультантом, менеджером и автором многих игр на движке Unity, графических проектов и книг.

Разработчики Unity внедрили поддержку машинного обучения и в частности глубинного обучения с подкреплением ради создания SDK глубинного обучения с подкреплением (deep reinforcement learning, DRL) для разработчиков игр и симуляций. К счастью, команда Unity под руководством Дэнни Лэнджа успешно реализована надёжный и современный движок DRL, способный показывать впечатляющие результаты. В качестве основы движка DRL Unity использует модель proximal policy optimization (PPO); эта модель значительно сложнее и в некоторых аспектах может отличаться.

В этой статье я познакомлю вас с инструментами и SDK для создания агентов DRL в играх и симуляциях. Несмотря на новизну и мощь этого инструмента, его легко использовать и он имеет вспомогательные инструменты, позволяющие осваивать концепции машинного обучения на ходу. Для работы с туториалом необходимо установить движок Unity.
Читать полностью »

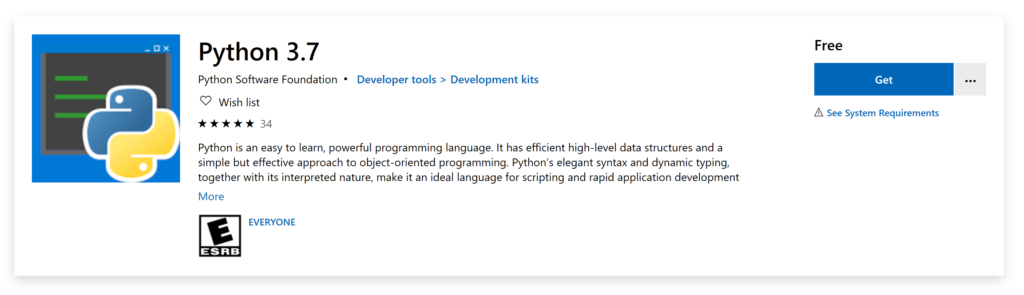
Несколько дней назад команда Windows анонсировала майское обновление 2019 для Windows 10. В этом посте мы взглянем на то, что мы, команда Python, сделали для того, чтобы установка Python в Windows стала проще. В частности поговорим о Microsoft Store и о добавлении дефолтной команды “python.exe” для облегчения поиска (в коллаборации с Windows). Возможно вы уже слышали об этом в подкасте Python Bytes, на PyCon US, или в Twitter.

The header of the Python 3.7 page in the Microsoft StoreЧитать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js