Рубрика «python» - 291

Сможет ли Питон прожевать миллион запросов в секунду? - 1

Возможно ли с помощью Python обработать миллион запросов в секунду? До недавнего времени это было немыслимо.

Многие компании мигрируют с Python на другие языки программирования для повышения производительности и, соответственно, экономии на стоимости вычислительных ресурсов. На самом деле в этом нет необходимости. Поставленных целей можно добиться и с помощью Python.

Python-сообщество в последнее время уделяет много внимания производительности. С помощью CPython 3.6 за счет новой реализации словарей удалось повысить скорость работы интерпретатора. А благодаря новому соглашению о вызове (calling convention) и словарному кешу CPython 3.7 должен стать еще быстрее.

Для определенного класса задач хорошо подходит PyPy с его JIT-компиляцией. Также можно использовать NumPy, в котором улучшена поддержка расширений на Си. Ожидается, что в этом году PyPy достигнет совместимости с Python 3.5.

Эти замечательные решения вдохновили меня на создание нового в той области, где Python используется очень активно: в разработке веб- и микросервисов.

Читать полностью »

Глубинное обучение по особенностям заголовка и содержимого статьи для преодоления кликбейта - 1
Облако слов для кликбейта

TL;DR: Я добился точности распознавания кликбейта 99,2% на тестовых данных по особенностям заголовка и контента. Код доступен в репозитории GitHub.

Когда-то в прошлом я написал статью о выявлении кликбейта. Та статья получила хорошие отклики, а также много критики. Некоторые сказали, что нужно учитывать содержимое сайта, другие просили больше примеров из разных источников, а некоторые предложили попробовать методы глубинного обучения.

В этой статье я постараюсь решить эти вопросы и вывести выявление кликбейта на новый уровень.
Читать полностью »

Привет всем, кто дожил до пятой темы нашего курса!

Курс собрал уже более 1000 участников, из них первые 3 домашних задания сделали 520, 450 и 360 человек соответственно. Открытый курс машинного обучения. Тема 5. Композиции: бэггинг, случайный лес - 1 Около 200 участников пока идут с максимальным баллом. Отток намного ниже, чем в MOOC-ах, даже несмотря на большой объем наших статей.

Данное занятие мы посвятим простым методам композиции: бэггингу и случайному лесу. Вы узнаете, как можно получить распределение среднего по генеральной совокупности, если у нас есть информация только о небольшой ее части; посмотрим, как с помощью композиции алгоритмов уменьшить дисперсию, и таким образом улучшим точность модели; разберём, что такое случайный лес, какие его параметры нужно «подкручивать» и как найти самый важный признак. Сконцентрируемся на практике, добавив «щепотку» математики.

Список статей серии

  1. Первичный анализ данных с Pandas
  2. Визуальный анализ данных c Python
  3. Классификация, деревья решений и метод ближайших соседей
  4. Линейные модели классификации и регрессии
  5. Композиции: бэггинг, случайный лес
  6. Обучение без учителя: PCA, кластеризация, поиск аномалий
  7. Искусство построения и отбора признаков. Приложения в задачах обработки текста, изображений и гео-данных

Читать полностью »

Варим ML Boot Camp III: Starter Kit - 1

16 марта закончилось соревнование по машинному обучению ML Boot Camp III. Я не настоящий сварщик, но, тем не менее, смог добиться 7го места в финальной таблице результатов. В данной статье я хотел бы поделиться тем, как начать участвовать в такого рода чемпионатах, на что стоит обратить внимание в первый раз при решении задачи и рассказать о своем подходе.

Читать полностью »

Добрый день! В этой статье я хотел бы вкратце рассказать о решении которое принесло мне первое место на конкурсе по машинному обучению ML Boot Camp III от mail.ru.
Читать полностью »

image Всем привет! Это уже шестой выпуск дайджеста на Хабрахабр о новостях из мира Python. В сегодняшнем выпуске вы найдёте интересные материалы, касающиеся машинного обучения, профилирования и оптимизации Python-приложений, хороших практик при написании Python-кода и многого другого. Присылайте свои актуальные материалы, а также любые замечания и предложения, которые будут добавлены в ближайший дайджест.

А теперь к делу!
Читать полностью »

Не секрет, что SQLAlchemy — самая популярная ORM на Python. Она позволяет писать куда более продвинутые вещи, чем большинство Active Record собратьев. Но плата за это — более сложный код, и в простых задачах вроде CRUD это напрягает.

О том, как я сделал Алхимию удобной, воспользовавшись опытом лучших Active Record ORM, читайте под катом.

Читать полностью »

Добрый день, читатель! Данная статья расскажет о пути получения второго места на соревновании MLBootCamp III. Для тех, кто не в курсе — это соревнование по машинному обучению и анализу данных от Mail.Ru Group, проходило с 15 февраля по 15 марта.

В статье будет коротко про историю построения решения, немного советов про то, на чем набил шишек и благодарности.

Итак, поехали.
Читать полностью »

Предсказываем будущее с помощью библиотеки Facebook Prophet - 1

Прогнозирование временных рядов — это достаточно популярная аналитическая задача. Прогнозы используются, например, для понимания, сколько серверов понадобится online-сервису через год, каков будет спрос на каждый товар в гипермаркете, или для постановки целей и оценки работы команды (для этого можно построить baseline прогноз и сравнить фактическое значение с прогнозируемым).

Существует большое количество различных подходов для прогнозирования временных рядов, такие как ARIMA, ARCH, регрессионные модели, нейронные сети и т.д.

Сегодня же мы познакомимся с библиотекой для прогнозирования временных рядов Facebook Prophet (в переводе с английского, "пророк", выпущена в open-source 23-го февраля 2017 года), а также попробуем в жизненной задаче – прогнозировании числа постов на Хабрехабре.

Читать полностью »

Введение

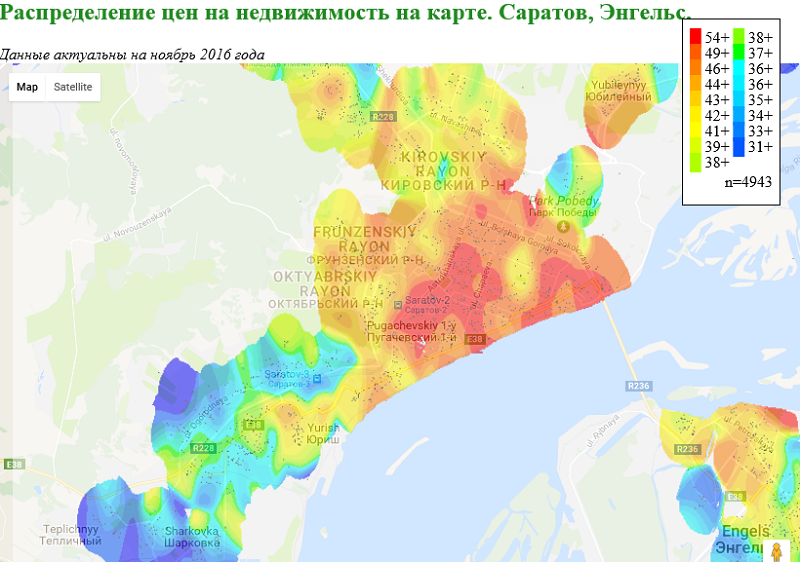
Начну с конца. Это скриншот с некой web-карты, визуализирующей среднюю стоимость недвижимости на вторичном рынке Саратова и Энгельса:

Статистика по стоимости недвижимости — визуализация на карте - 1

Цвета на карте можно соотнести с цветами на «легенде», цвет на «легенде» соответствует средней стоимости квадратного метра общей площади в тысячах рублей.

Точка на карте соответствует одному предложению по продаже (на вторичном рынке) квартиры с Авито. Всего таких точек, как видно на «легенде», для построения графика использовалось 4943.
Карта в интерактивном виде доступна на GitHub.

А теперь немного предыстории..

Давным-давно…
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js