Рубрика «sql» - 35

WITH w AS  NOT MATERIALIZED (
    SELECT * 
    FROM very_very_big_table
)
SELECT * 
FROM w AS w1 
    JOIN w AS w2 
        ON w1.key = w2.ref
WHERE w2.key = 123;

Сегодня в репозиторий PostgreSQL упал комит, позволяющий управлять поведением обработки подзапросов CTE, а именно: теперь можно явно указывать, будет ли подзапрос материализовываться отдельно или же выполняться как часть одного большого запроса.

Это войдет в PostgreSQL 12, и это big deal. Давайте рассмотрим, почему

Читать полностью »

«Удаление» объектов в Django - 1

Рано или поздно перед разработчиками встаёт задача удаления ненужных данных. И чем сложнее сервис, тем больше нюансов необходимо учесть. В данной статье я расскажу, как мы реализовали «удаление» в базе данных с сотней связей.
Читать полностью »

И снова привет!

Коллеги, в последний день января мы запускаем курс «MS SQL Server разработчик», в связи с чем у нас прошёл тематический открытый урок. На нём мы поговорили о том, как MS SQL Server выполняет запрос SELECT, обсудили, в каком порядке и что анализируется, а также немного погрузились в чтение плана запроса.

Преподаватель — Кристина Кучерова, архитектор модели данных в Сбербанке России.

Читать полностью »

в 16:41, , рубрики: java, sql, versioning

Введение

Liquibase представляет из себя систему управления версиями базы данных, в основном это касается структуры и в меньшей степени содержимого базы. При этом описание базы с одной стороны достаточно абстрактно и позволяет использовать на нижнем уровне различные СУБД, и с другой стороны всегда можно перейти на SQL-диалект конкретной СУБД, что достаточно гибко. Liquibase является устоявшимся проектом с открытым исходным кодом и активно используется за пределами своей родной Java среды и не требует глубоких знаний Java для работы. В качестве описания структуры базы и изменений базы исторически использовался XML формат, однако сейчас параллельно поддерживается YAML и JSON.

В данной статье мы немного обобщим опыт предыдущих поколений и сосредоточимся на работе с Liquibase с использованием Maven. В качестве тестовой операционной системы будем использовать Ubuntu.

Читать полностью »

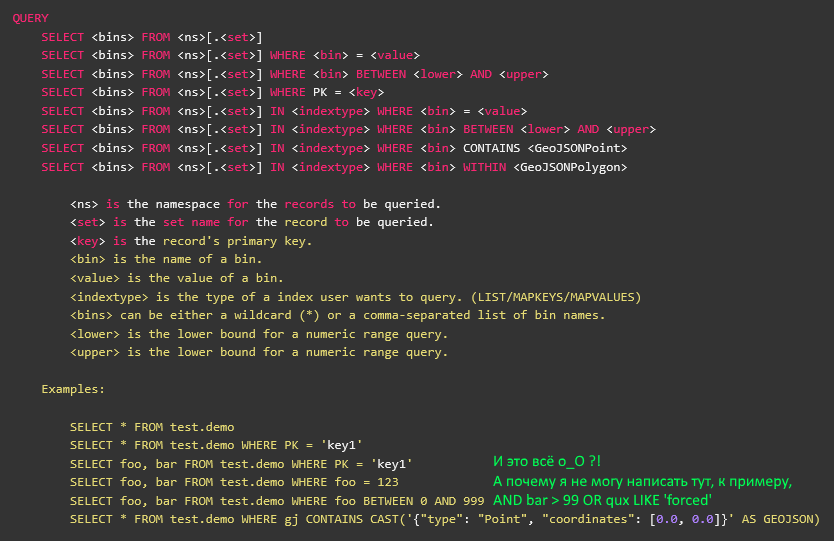
TL;DR: GitHub://PastorGL/AQLSelectEx.

Aerospike AQL SELECT

Однажды, ещё не в студёную, но уже зимнюю пору, а конкретно пару месяцев назад, для проекта, над которым я работаю (нечто Geospatial на основе Big Data), потребовалось быстрое NoSQL / Key-Value хранилище.

Терабайты исходников мы вполне успешно прожёвываем при помощи Apache Spark, но схлопнутый до смешного объёма (всего лишь миллионы записей) конечный результат расчётов надо где-то хранить. И очень желательно хранить таким образом, чтобы его можно было по ассоциированным с каждой строкой результата (это одна цифра) метаданным (а вот их довольно много) быстро найти и отдать наружу.

Читать полностью »

Несколько лет назад на форуме SQL.ru решили провести сравнение реализаций трассировщиков лучей на разных языках программирования. К сожалению, моя заявка не может участвовать т.к. она не выводит надпись «PIXAR», поэтому публикую ее здесь.

Для чистоты эксперимента я использовал SQLite без расширений. Оказалось, что там нет даже функции SQRT.

WITH RECURSIVE numbers AS (SELECT 0 AS n UNION ALL SELECT n+1 FROM numbers WHERE n<89),
pixels AS (SELECT rows.n as row, cols.n as col FROM numbers as rows CROSS JOIN numbers as cols WHERE rows.n > 4 AND rows.n < 38 AND cols.n > 9 AND cols.n < 89),
rawRays AS (SELECT row, col, -0.9049 + col * 0.0065 + row * 0.0057 as x, -0.1487 + row * -0.0171 as y, 0.6713 + col * 0.0045 + row * -0.0081 as z FROM pixels),
norms AS (SELECT row, col, x, y, z, (1 + x * x + y * y + z * z) / 2 as n FROM rawRays),
rays AS (SELECT row, col, x / n AS x, y / n AS y, z / n AS z FROM norms),
iters AS (SELECT row, col, 0 as it, 0 as v FROM rays UNION ALL SELECT rays.row, rays.col, it + 1 AS it, v + MAX(ABS(0.7+v*x) - 0.3, ABS(0.7+v*y) - 0.3, ABS(-1.1+v*z) - 0.3, -((0.7+v*x) * (0.7+v*x) + (0.7+v*y) * (0.7+v*y) + (-1.1+v*z) * (-1.1+v*z)) * 1.78 + 0.28) AS v FROM iters JOIN rays ON rays.row = iters.row AND rays.col = iters.col WHERE it < 15),
lastIters AS (SELECT it0.row, it0.col, it0.v AS v0, it1.v AS v1, it2.v AS v2 FROM iters as it0 JOIN iters AS it1 ON it0.col = it1.col AND it0.row = it1.row JOIN iters AS it2 ON it0.col = it2.col AND it0.row = it2.row WHERE it0.it = 15 AND it1.it = 14 AND it2.it = 13),
res AS (SELECT col, (v0 - v1) / (v1 - v2) as v FROM lastIters)
SELECT group_concat(substr('$@B%8&WM#*oahkbdpqwmZO0QLCJUYXzcvunxrjft/|()1{}[]?-_+~<>i!lI;:,"^. ', round(1 + max(0, min(66, v * 67))), 1) || CASE WHEN col=88 THEN X'0A' ELSE '' END, '') FROM res;

                                :++++I
                          _________________________"
                   ------/jucYJLQ0OZmwwwwwwwmmZO0QCUXcnj----------
            ???????:<}/nzJQOwqdbkhao***####**o         LUcx|[<;????????????????
     ]]]]]]]]][[[  !{xu;    o#MW&8%BB@@@@@                -ct[l  ]]]]]]]]]]]??-
U[[[[[[[}}}}}}}}}   ;1X]      $$$$$$$$$$                  cx["   [[[[[[[[]]]??
UUJJJCCCLLL{{{{{{{{{{   :|QZzffB$$$$$$               |Qu?     {{{{{{}}}[[]]??-
YUUJJJCCCLLLQQ000OOO111111111         ,l!!;           111111111111{{}}[[]]??-
 YUUJJJCCCLLLQQQ00OOOZZZmmmwww(((((((((((((((((((()))))))))))))11{{     i]??-
 YYUUUJJCCCLLL  ?fuv|  ZZZmmmwwwqqqpppd||||||||||||||||||((())11{   i++i;??--
 YYYUUUJJJ i               Cmmwwwqqqppppdddbbbbk///////||(())11  }czfYuf{_--
  XYYUUU                       Wwwwqqqpppddddbbbbkkkk/||(()))  |j     :zr)--
  XXYYY;                         $$wqqqqpppddddbbbbk/|||(()) ^X        Jcf-
  XXXY                          $$$$xwqqqppppddddbbb/||(()) v          LX-_
   zXX!                        $$$$$$$nqqqqppppdddbb||(()) q          mQX-
   zzX>                      $$$$$$$$$$$$qqqqppppddd|(()) k          dmL-_
    zzl                     $$$$$$$$$$$$$$wqqqqppppd((() o        W*kqOJ__
    czz?                  $$$$$$$$$$$$$$$$$ wqqqqpp|(() O     $$BadmQ__
    ccc!1x             $$$$$$$$              wwqqqq(() {$$$$$$$Babw0___
     vcc<)xXQm   W%@$$$$$$                   mwwwwq()) %$$$$$@%W#adwQ___
     vvcc>1rzCZqkoM&B$$                      bmmwww)) )o$$$$B&MokpZL-__+
     uvvvcc]tuUQmpkoM                         Zmmmm)1 J-   &MohdmQU-__++
      uuvvvcc{jvUQmp                          ZZZm)11 J:    kpmQUc-__;
      nuuuvvvcc}fuYL                         nOOZZ11  /|   .0CXu}-_
        nuuvvvccc-)jv                       !00OOO11{ ;/zvzvxt1--
             vvvcccz+{                     }QQ000O1{{   !~+~>?-
                  ccczz:<]               : LQQQQ00{{}}[   ]??
                       zzzzXX  ";I;"   JCCCLLLLQQQ{}}[[]]]?
                           zzXXXYYYUUUUJJJCCCCLLL{}}[[]]]
                                XXYYYYUUUJJJJCCCC}}[[]]
                                     YYYUUUUJJJJC}[[]
                                          YUUUUJJ[[
                                               UU

Здесь можно покрутить кубик

Под катом построчный разбор запроса. Как обычно, достаточно знания основ SQL и школьной математики.
Читать полностью »

Доброго времени суток, Хабровчане! В этой статье я хочу рассказать о своем опыте упрощения взаимодействия с базами данных SQL при разработке десктопного приложения с помощью класса QSqlRelationalTableModel кроссплатформенной библиотеки Qt.

Пролог

С Qt я познакомился еще будучи студентом 1 курса, только начиная программировать на C++, тогда же и серьезно заинтересовался библиотекой и, с тех пор, слежу за ее апдейтами. Несколько месяцев назад, на работе, мне дали ТЗ, в котором требовалось разработать приложение, взаимодействующее с БД SQLite. Структура базы фиксирована и заранее известна мне из ТЗ.

Приложение должно уметь удобно для оператора представлять данные, хранящиеся в базе, позволять добавлять новые записи, удалять и изменять уже существующие.

Далее я кратко опишу процесс разработки с приведением кусков кода и попытаюсь аргументированно объяснить, почему в данном случае был сделан выбор в пользу QSqlRelationalTableModel.
Читать полностью »

Введение

Всем привет! Это моя первая статья и пишу я ее от лица младшего инженера-разработчика на языке C#. Так что здесь не будет каких-то подробных сведений о SQL, лишь практические сведения и размышления по решению довольно не очевидной задачи, с которой мне пришлось столкнуться, для таких же новичков, как и я сам.

Сначала я опишу формулировку своей задачи в качестве примера, в котором возникает реальная необходимость переноса большой таблицы.

Итак, представим, что у вас есть web-сервис и SQL (MS-SQL) база данных с таблицей html-писем, которые ваш сервис рассылает пользователям. Письма хранятся за некоторое количество лет и удалить их нельзя, так как они нужны для сбора статистики и аналитики. Однако, с каждым годом количество писем растет, база разрастается, а места на SQL-сервере все меньше (в нашем случае еще одним фактором было восстановление базы на тестовую площадку, т.к. его время пропорционально росло) и с этим нужно что-то делать. Благо, в нашем случае есть свободный сервер с кучей свободного места (в реальности его может не быть и конечно это временное решение, но это выходит за рамки статьи). Так возникла задача по переносу большой таблицы (и говоря «большой», я имею в виду реально большую таблицу, все что я видел, пока искал похожие решения, было в районе 60-100Гб, в нашем случае таблица весила более 300 Гб).

Мы рассмотрим несколько способов решения этой задачи, но не все они будут относится к переносу вида сервер – сервер. Иногда может возникнуть необходимость переноса таблицы между базами в рамках одного сервера. Также, некоторые способы чисто теоретические, я не проверял их все на практике, однако они наверняка должны сработать.
Читать полностью »

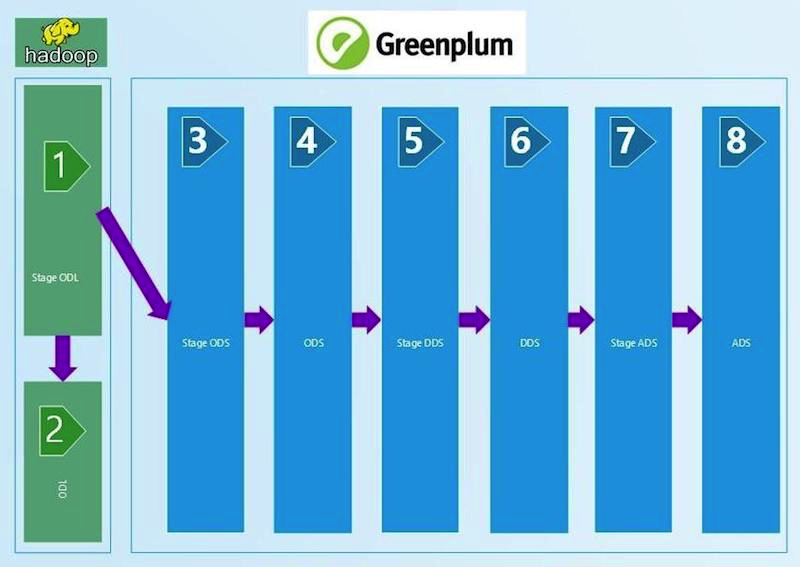
В «Ростелекоме», как и в любой крупной компании, имеется корпоративное хранилище данных (ЦХД). Наше ЦХД постоянно разрастается и расширяется, мы строим на нем полезные витрины, отчеты и кубы данных. В какой-то момент мы столкнулись с тем, что некачественные данные мешают нам при построении витрин, получаемые агрегаты не сходятся с агрегатами систем источников и вызывают непонимание бизнеса. Например, данные с Null значениями в внешних ключах (foreign key) не соединяются с данными других таблиц.

Автоматизация качества данных корпоративного хранилища - 1

Мы понимали, что для обеспечения уверенности в качестве данных нам нужен регулярный процесс сверок. Конечно, автоматизированный и позволяющий каждому из технологических уровней быть уверенным в качестве данных и их сходимости, как по вертикали, так и по горизонтали. В итоге мы параллельно рассмотрели три готовые платформы для управления сверками от различных вендоров и написали свою собственную. Делимся опытом в этом посте.
Читать полностью »

Автор статьи – Виктор Варламов, OCP.
Оригинал статьи опубликован 07.07.2017.
Отдельное спасибо автору перевода — brutaltag.

В нашей системе подготовки отчетности обычно выполняются сотни длительных запросов, которые вызываются различными событиями. Параметрами запросов служат список клиентов и временной интервал (дневной, недельный, месячный). Из-за неравномерных данных в таблицах один запрос может выдать как одну строку, так и миллион строк, в зависимости от параметров отчета (у разных клиентов — различное количество строк в таблицах фактов). Каждый отчет выполнен в виде пакета с основной функцией, которая принимает входные параметры, проводит дополнительные преобразования, затем открывает статический курсор со связанными переменными и в конце возвращает этот открытый курсор. Параметр БД CURSOR_SHARING выставлен в FORCE.
В такой ситуации приходится сталкиваться с плохой производительностью, как в случае повторного использования плана запроса оптимизатором, так и при полном разборе запроса с параметрами в виде литералов. Связанные переменные могут вызвать неоптимальный план запроса.
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js