Рубрика «sql» - 34

В прошлый раз мы поговорили о согласованности данных, посмотрели на отличие между разными уровнями изоляции транзакций глазами пользователя и разобрались, почему это важно знать. Теперь мы начинаем изучать, как в PostgreSQL реализованы изоляция на основе снимков и механизм многоверсионности.

В этой статье мы посмотрим на то, как данные физически располагаются в файлах и страницах. Это уводит нас в сторону от темы изоляции, но такое отступление необходимо для понимания дальнейшего материала. Нам потребуется разобраться, как устроено хранение данных на низком уровне.

Отношения (relations)

Если заглянуть внутрь таблиц и индексов, то окажется, что они устроены схожим образом. И то, и другое — объекты базы, которые содержат некоторые данные, состоящие из строк.

То, что таблица состоит из строк, не вызывает сомнений; для индекса это менее очевидно. Тем не менее, представьте B-дерево: оно состоит из узлов, которые содержат индексированные значения и ссылки на другие узлы или на табличные строки. Вот эти узлы и можно считать индексными строками — фактически, так оно и есть.

На самом деле есть еще некоторое количество объектов, устроенных похожим образом: последовательности (по сути однострочные таблицы), материализованные представления (по сути таблицы, помнящие запрос). А еще есть обычные представления, которые сами по себе не хранят данные, но во всех остальных смыслах похожи на таблицы.

Все эти объекты в PostgreSQL называются общим словом отношение (по-английски relation). Слово крайне неудачное, потому что это термин из реляционной теории. Можно провести параллель между отношением и таблицей (представлением), но уж никак не между отношением и индексом. Но так уж сложилось: дают о себе знать академические корни PostgreSQL. Мне думается, что сначала так называли именно таблицы и представления, а остальное наросло со временем.
Читать полностью »
Продуктовая аналитика ВКонтакте на базе ClickHouse - 1

Развивая любой продукт, будь то видеосервис или лента, истории или статьи, хочется уметь измерять условное «счастье» пользователя. Понимать, делаем мы своими изменениями лучше или хуже, корректировать направление развития продукта, опираясь не на интуицию и собственные ощущения, а на метрики и цифры, в которые можно верить.

В этой статье я расскажу, как нам удалось запустить продуктовую статистику и аналитику на сервисе с 97-миллионной месячной аудиторией, получив при этом чрезвычайно высокую производительность аналитических запросов. Речь пойдёт о ClickHouse, используемых движках и особенностях запросов. Я опишу подход к агрегации данных, который позволяет нам за доли секунды получать сложные метрики, и расскажу о преобразовании и тестировании данных.

Сейчас у нас около 6 миллиардов продуктовых событий в сутки, в ближайшее время дойдём до 20–25 миллиардов. А дальше — не такими быстрыми темпами поднимемся до 40–50 миллиардов к концу года, когда опишем все интересующие нас продуктовые события.

1 rows in set. Elapsed: 0.287 sec. Processed 59.85 billion rows, 59.85 GB (208.16 billion rows/s., 208.16 GB/s.)

Подробности под катом.
Читать полностью »

Недавно с некоторым удивлением узнал, что в одном из департментов огромной фирмы, где я работаю, запрещен запуск SQL profiler в business hours.

Опасен ли SQL profiler? - 1

Читать полностью »

Привет! Этой статьей я начинаю серию циклов (или цикл серий? в общем, задумка грандиозная) о внутреннем устройстве PostgreSQL.

Материал будет основан на учебных курсах по администрированию, которые делаем мы с Павлом pluzanov. Смотреть видео не все любят (я точно не люблю), а читать слайды, пусть даже с комментариями, — совсем «не то».

Конечно, статьи не будут повторять содержание курсов один в один. Я буду говорить только о том, как все устроено, опуская собственно администрирование, зато постараюсь делать это более подробно и обстоятельно. И я верю в то, что такие знания полезны прикладному разработчику не меньше, чем администратору.

Ориентироваться я буду на тех, кто уже имеет определенный опыт использования PostgreSQL и хотя бы в общих чертах представляет себе, что к чему. Для совсем новичков текст будет тяжеловат. Например, я ни слова не скажу о том, как установить PostgreSQL и запустить psql.

Вещи, о которых пойдет речь, не сильно меняются от версии к версии, но использовать я буду текущий, 11-й «ванильный» PostgreSQL.

Первый цикл посвящен вопросам, связанным с изоляцией и многоверсионностью, и план его таков:

  1. Изоляция, как ее понимают стандарт и PostgreSQL (эта статья);
  2. Слои, файлы, страницы — что творится на физическом уровне;
  3. Версии строк, виртуальные и вложенные транзакции;
  4. Снимки данных и видимость версий строк, горизонт событий;
  5. Внутристраничная очистка и HOT-обновления;
  6. Обычная очистка (vacuum);
  7. Автоматическая очистка (autovacuum);
  8. Переполнение счетчика транзакций и заморозка.

Ну, поехали.
Читать полностью »

Мы продолжаем публиковать видео и расшифровки лучших докладов с конференции PGConf.Russia 2019. В первой части доклада Ивана Фролкова речь шла о непоследовательном именовании, о constraints, о том, где лучше сосредоточить логику — в базе или в приложении. В этой части вас ждет разбор обработки ошибок, конкурентного доступа, неотменяемых операций, CTE и JSON.

Типичные ошибки при работе с PostgreSQL. Часть 2 - 1

Расскажу такую историю. Наш клиент говорит: «Медленно работает база, а наше приложение занимается обслуживаем населения. Мы боимся, что нас тут поднимут на вилы». Выяснилось, что у них было очень много процессов в состоянии idle in transaction. Приложение начало транзакцию, ничего не делает, но и транзакцию не завершает. Если вы взаимодействуете с какими-то внешними сервисами, то, в принципе, это нормальная ситуация. Другое дело, что если у вас состояние idle in transaction длится долго (больше минуты уже подозрительно), то это плохо потому, что PostgreSQL очень не любит долгие транзакции: VACUUM не сможет почистить все те строки, которые он мог бы увидеть, и долго висящая транзакция эффективно блокирует VACUUM. Начинают разбухать таблицы, индексы становятся всё менее эффективными.

Типичные ошибки при работе с PostgreSQL. Часть 2 - 2Читать полностью »

Графики, отчеты и аналитика – все это так или иначе присутствует в back-office любого, даже совсем маленького, предприятия. Когда в обычных таблицах в Excel/Numbers/Libre становится уже тесно, но data все еще не очень big, традиционные решения для внутренних потребностей компании часто строятся с помощью реляционных баз данных, таких как PostgreSQL, MySQL или MariaDB.

Эти базы данных бесплатны, благодаря SQL удобно интегрируются с остальными компонентами в системе, они популярны и с ними умеют работать большинство разработчиков и аналитиков. Нагрузку (трафик и объемы) они могут переварить достаточно объемную, чтобы спокойно продержаться до того момента, когда компания сможет позволить себе более сложные (и дорогие) решения для аналитики и отчетов.
Читать полностью »

Всем привет, данная публикация будет посвящена работе с встраиваемой реляционной базой данных SQLite в Unity. Данная статья написана новичком для новичков с целью показания работы с SQLite, предполагается, что вы знаете основы SQL. Так как в интернете нет ясного тутора для новичков, я решил занять эту нишу. В данной статье мы напишем простенький класс для работы с данной СУБД, который можно использовать для решения широкого круга задач (локализация, сохранение данных, ведение разных таблиц).
Читать полностью »

5 лайфхаков оптимизации SQL-запросов в Greenplum - 1

Любые процессы, связанные с базой, рано или поздно сталкиваются с проблемами производительности запросов к этой базе.

Хранилище данных Ростелекома построено на Greenplum, большая часть вычислений (transform) производится sql-запросами, которые запускает (либо генерирует и запускает) ETL-механизм. СУБД имеет свои нюансы, существенно влияющие на производительность. Данная статья — попытка выделить наиболее критичные, с точки зрения производительности, аспекты работы с Greenplum и поделиться опытом.

В двух словах о Greenplum

Greenplum — MPP сервер БД, ядро которого построено на PostgreSql.

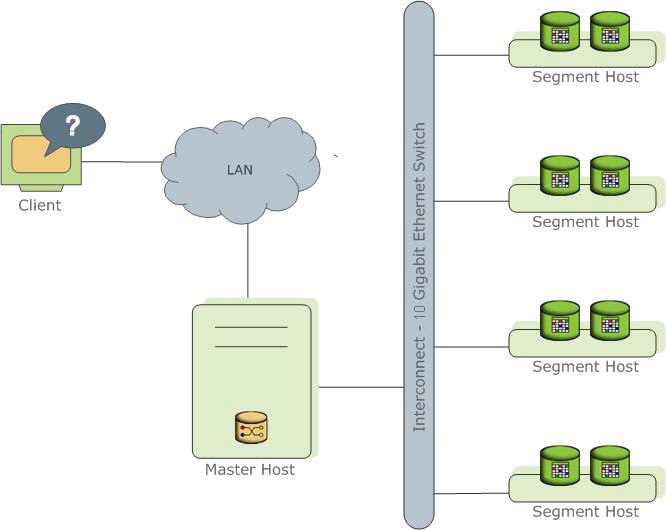
Представляет собой несколько разных экземпляров процесса PostgreSql (инстансы). Один из них является точкой входа для клиента и называется master instance (master), все остальные — Segment instanсe (segment, Независимые инстансы, на каждом из которых хранится своя порция данных). На каждом сервере (segment host) может быть запущено от одного до нескольких сервисов (segment). Делается это для того, чтобы лучше утилизировать ресурсы серверов и в первую очередь процессоры. Мастер хранит метаданные, отвечает за связь клиентов с данными, а также распределяет работу между сегментами.

5 лайфхаков оптимизации SQL-запросов в Greenplum - 2

Подробнее можно почитать в официальной документации.

Далее в статье будет много отсылок к плану запроса. Информацию для Greenplum можно получить тут.

Как писать хорошие запросы на Greenplum (ну или хотя бы не совсем печальные)

Читать полностью »

Довольно часто спрашивают, есть ли аналоги аналитических (оконных) функций в MySQL. Примечание. На момент написания статьи таких аналогов не было, однако статья и ныне представляет собой академический интерес в плане разбора оригинального для MySQL подхода к использованию переменных.

Для замены аналитических функций часто используют запросы с самосоединением, сложные подзапросы и прочее. Большинство таких решений оказываются неэффективными с точки зрения производительности.

Также в MySQL нет рекурсии. Однако с некоторой частью задач, которые обычно решаются аналитическими функциями или рекурсией, можно справиться и средствами MySQL.

Одним из этих средств является уникальный, нехарактерный для прочих СУБД механизм работы с переменными внутри запроса SQL. Мы можем объявить переменную внутри запроса, менять ей значение и подставлять в SELECT для вывода. Причем порядок обработки строк в запросе и, как следствие, порядок присвоения значений переменным можно задать в пользовательской сортировке!

Предупреждение. В статье подразумевается, что обработка выражений в предложении SELECT осуществляется слева направо, однако официального подтверждения такого порядка обработки в документации MySQL нет. Это необходимо иметь в виду при смене версии сервера. Для гарантии последовательности вычисления можно использовать фиктивный оператор CASE или IF.

Аналог рекурсии

Рассмотрим простой пример, который генерирует последовательность Фибоначчи (в последовательности Фибоначчи каждый член равен сумме двух предыдущих, а первые 2 равны единице):
Читать полностью »

Interface

In the first article, we've mentioned that an access method must provide information about itself. Let's look into the structure of the access method interface.

Properties

All properties of access methods are stored in the «pg_am» table («am» stands for access method). We can also get a list of available methods from this same table:

postgres=# select amname from pg_am;
 amname
--------
 btree
 hash
 gist
 gin
 spgist
 brin
(6 rows)

Although sequential scan can rightfully be referred to access methods, it is not on this list for historical reasons.

In PostgreSQL versions 9.5 and lower, each property was represented with a separate field of the «pg_am» table. Starting with version 9.6, properties are queried with special functions and are separated into several layers:

  • Access method properties — «pg_indexam_has_property»
  • Properties of a specific index — «pg_index_has_property»
  • Properties of individual columns of the index — «pg_index_column_has_property»

The access method layer and index layer are separated with an eye towards the future: as of now, all indexes based on one access method will always have the same properties.
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js