
Привет! Посмотрим на новые штуки в — DataGrip 2019.1. Напомним, что функциональность DataGrip включена и в другие наши платные IDE, кроме WebStorm.
Рубрика «sql» - 33
DataGrip 2019.1: поддержка новых баз, инициализационные скрипты, новые инспекции и другое
2019-04-03 в 13:58, admin, рубрики: db2, Hive, intellij idea, Microsoft SQL Server, mysql, postgresql, Snowflake, sql, Vertica, Администрирование баз данных, базы данных, Блог компании JetBrains
Была ли MongoDB вообще правильным выбором?
2019-03-31 в 18:50, admin, рубрики: mysql, nosql, sql, когнитивные искажения, хранилища данныхНедавно я узнал, что Red Hat удаляет поддержку MongoDB из Satellite (говорят, из-за изменений лицензии). Это заставило меня задуматься, что в последние несколько лет я видел кучу статей, как ужасна MongoDB и что никто никогда не должен её использовать. Но за это время MongoDB стала гораздо более зрелым продуктом. Что же случилось? Действительно ли вся ненависть объясняется ошибками в начале маркетинга новой СУБД? Или люди просто применяют MongoDB не там, где нужно?
Если вам вдруг кажется, что я защищаю MongoDB, пожалуйста, прочитайте дисклеймер в конце статьи.
Читать полностью »
MVCC-2. Слои, файлы, страницы
2019-03-29 в 21:13, admin, рубрики: files, forks, free space map, postgesql, postgresql, relations, sql, toast, tuples, visibility map, Блог компании Postgres ProfessionalВ прошлый раз мы поговорили о согласованности данных, посмотрели на отличие между разными уровнями изоляции транзакций глазами пользователя и разобрались, почему это важно знать. Теперь мы начинаем изучать, как в PostgreSQL реализованы изоляция на основе снимков и механизм многоверсионности.
В этой статье мы посмотрим на то, как данные физически располагаются в файлах и страницах. Это уводит нас в сторону от темы изоляции, но такое отступление необходимо для понимания дальнейшего материала. Нам потребуется разобраться, как устроено хранение данных на низком уровне.
Отношения (relations)
Если заглянуть внутрь таблиц и индексов, то окажется, что они устроены схожим образом. И то, и другое — объекты базы, которые содержат некоторые данные, состоящие из строк.
То, что таблица состоит из строк, не вызывает сомнений; для индекса это менее очевидно. Тем не менее, представьте B-дерево: оно состоит из узлов, которые содержат индексированные значения и ссылки на другие узлы или на табличные строки. Вот эти узлы и можно считать индексными строками — фактически, так оно и есть.
На самом деле есть еще некоторое количество объектов, устроенных похожим образом: последовательности (по сути однострочные таблицы), материализованные представления (по сути таблицы, помнящие запрос). А еще есть обычные представления, которые сами по себе не хранят данные, но во всех остальных смыслах похожи на таблицы.
Все эти объекты в PostgreSQL называются общим словом отношение (по-английски relation). Слово крайне неудачное, потому что это термин из реляционной теории. Можно провести параллель между отношением и таблицей (представлением), но уж никак не между отношением и индексом. Но так уж сложилось: дают о себе знать академические корни PostgreSQL. Мне думается, что сначала так называли именно таблицы и представления, а остальное наросло со временем.
Читать полностью »
Продуктовая аналитика ВКонтакте на базе ClickHouse
2019-03-26 в 10:52, admin, рубрики: big data, big data analytics, clickhouse, sql, анализ данных, аналитика, базы данных, Блог компании ВКонтакте, Вконтакте, продуктовая аналитика, статистический анализ
Развивая любой продукт, будь то видеосервис или лента, истории или статьи, хочется уметь измерять условное «счастье» пользователя. Понимать, делаем мы своими изменениями лучше или хуже, корректировать направление развития продукта, опираясь не на интуицию и собственные ощущения, а на метрики и цифры, в которые можно верить.
В этой статье я расскажу, как нам удалось запустить продуктовую статистику и аналитику на сервисе с 97-миллионной месячной аудиторией, получив при этом чрезвычайно высокую производительность аналитических запросов. Речь пойдёт о ClickHouse, используемых движках и особенностях запросов. Я опишу подход к агрегации данных, который позволяет нам за доли секунды получать сложные метрики, и расскажу о преобразовании и тестировании данных.
Сейчас у нас около 6 миллиардов продуктовых событий в сутки, в ближайшее время дойдём до 20–25 миллиардов. А дальше — не такими быстрыми темпами поднимемся до 40–50 миллиардов к концу года, когда опишем все интересующие нас продуктовые события.
1 rows in set. Elapsed: 0.287 sec. Processed 59.85 billion rows, 59.85 GB (208.16 billion rows/s., 208.16 GB/s.)
Подробности под катом.
Читать полностью »
Опасен ли SQL profiler?
2019-03-23 в 18:30, admin, рубрики: Microsoft SQL Server, MS Sql Server, mssql, performance optimization, sql, sql server, Администрирование баз данныхНедавно с некоторым удивлением узнал, что в одном из департментов огромной фирмы, где я работаю, запрещен запуск SQL profiler в business hours.

MVCC-1. Изоляция
2019-03-20 в 22:53, admin, рубрики: postgresql, sql, Блог компании Postgres Professional, метки никто не читаетПривет! Этой статьей я начинаю серию циклов (или цикл серий? в общем, задумка грандиозная) о внутреннем устройстве PostgreSQL.
Материал будет основан на учебных курсах по администрированию, которые делаем мы с Павлом pluzanov. Смотреть видео не все любят (я точно не люблю), а читать слайды, пусть даже с комментариями, — совсем «не то».
Конечно, статьи не будут повторять содержание курсов один в один. Я буду говорить только о том, как все устроено, опуская собственно администрирование, зато постараюсь делать это более подробно и обстоятельно. И я верю в то, что такие знания полезны прикладному разработчику не меньше, чем администратору.
Ориентироваться я буду на тех, кто уже имеет определенный опыт использования PostgreSQL и хотя бы в общих чертах представляет себе, что к чему. Для совсем новичков текст будет тяжеловат. Например, я ни слова не скажу о том, как установить PostgreSQL и запустить psql.
Вещи, о которых пойдет речь, не сильно меняются от версии к версии, но использовать я буду текущий, 11-й «ванильный» PostgreSQL.
Первый цикл посвящен вопросам, связанным с изоляцией и многоверсионностью, и план его таков:
- Изоляция, как ее понимают стандарт и PostgreSQL (эта статья);
- Слои, файлы, страницы — что творится на физическом уровне;
- Версии строк, виртуальные и вложенные транзакции;
- Снимки данных и видимость версий строк, горизонт событий;
- Внутристраничная очистка и HOT-обновления;
- Обычная очистка (vacuum);
- Автоматическая очистка (autovacuum);
- Переполнение счетчика транзакций и заморозка.
Ну, поехали.
Читать полностью »
Типичные ошибки при работе с PostgreSQL. Часть 2
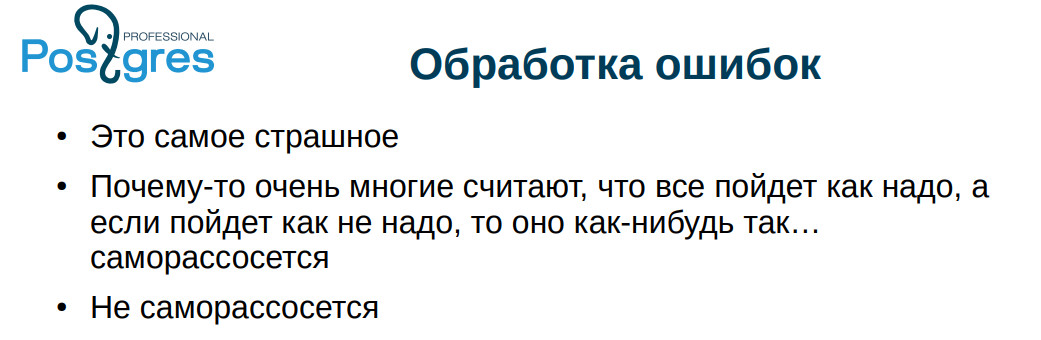
2019-03-18 в 9:49, admin, рубрики: dbms, pgsql, postgres, postgresql, sql, Блог компании Postgres Professional, СУБДМы продолжаем публиковать видео и расшифровки лучших докладов с конференции PGConf.Russia 2019. В первой части доклада Ивана Фролкова речь шла о непоследовательном именовании, о constraints, о том, где лучше сосредоточить логику — в базе или в приложении. В этой части вас ждет разбор обработки ошибок, конкурентного доступа, неотменяемых операций, CTE и JSON.
Расскажу такую историю. Наш клиент говорит: «Медленно работает база, а наше приложение занимается обслуживаем населения. Мы боимся, что нас тут поднимут на вилы». Выяснилось, что у них было очень много процессов в состоянии idle in transaction. Приложение начало транзакцию, ничего не делает, но и транзакцию не завершает. Если вы взаимодействуете с какими-то внешними сервисами, то, в принципе, это нормальная ситуация. Другое дело, что если у вас состояние idle in transaction длится долго (больше минуты уже подозрительно), то это плохо потому, что PostgreSQL очень не любит долгие транзакции: VACUUM не сможет почистить все те строки, которые он мог бы увидеть, и долго висящая транзакция эффективно блокирует VACUUM. Начинают разбухать таблицы, индексы становятся всё менее эффективными.
Сюрпризы планировщика запросов в БД PostgreSQL
2019-03-11 в 14:48, admin, рубрики: postgresql, sql, Администрирование баз данных, базы данных, Блог компании OkkoГрафики, отчеты и аналитика – все это так или иначе присутствует в back-office любого, даже совсем маленького, предприятия. Когда в обычных таблицах в Excel/Numbers/Libre становится уже тесно, но data все еще не очень big, традиционные решения для внутренних потребностей компании часто строятся с помощью реляционных баз данных, таких как PostgreSQL, MySQL или MariaDB.
Эти базы данных бесплатны, благодаря SQL удобно интегрируются с остальными компонентами в системе, они популярны и с ними умеют работать большинство разработчиков и аналитиков. Нагрузку (трафик и объемы) они могут переварить достаточно объемную, чтобы спокойно продержаться до того момента, когда компания сможет позволить себе более сложные (и дорогие) решения для аналитики и отчетов.
Читать полностью »
Использование SQLite в Unity (Unity + SQLite)
2019-03-07 в 15:22, admin, рубрики: C#, sql, sqlite, sqlite3, unity, unity3d, unity3d уроки, туториалыВсем привет, данная публикация будет посвящена работе с встраиваемой реляционной базой данных SQLite в Unity. Данная статья написана новичком для новичков с целью показания работы с SQLite, предполагается, что вы знаете основы SQL. Так как в интернете нет ясного тутора для новичков, я решил занять эту нишу. В данной статье мы напишем простенький класс для работы с данной СУБД, который можно использовать для решения широкого круга задач (локализация, сохранение данных, ведение разных таблиц).
Читать полностью »
5 лайфхаков оптимизации SQL-запросов в Greenplum
2019-03-06 в 11:54, admin, рубрики: greenplum, sql, Администрирование баз данных, базы данных, Блог компании Ростелеком, Ростелеком, хранение данных
Любые процессы, связанные с базой, рано или поздно сталкиваются с проблемами производительности запросов к этой базе.
Хранилище данных Ростелекома построено на Greenplum, большая часть вычислений (transform) производится sql-запросами, которые запускает (либо генерирует и запускает) ETL-механизм. СУБД имеет свои нюансы, существенно влияющие на производительность. Данная статья — попытка выделить наиболее критичные, с точки зрения производительности, аспекты работы с Greenplum и поделиться опытом.
В двух словах о Greenplum
Greenplum — MPP сервер БД, ядро которого построено на PostgreSql.
Представляет собой несколько разных экземпляров процесса PostgreSql (инстансы). Один из них является точкой входа для клиента и называется master instance (master), все остальные — Segment instanсe (segment, Независимые инстансы, на каждом из которых хранится своя порция данных). На каждом сервере (segment host) может быть запущено от одного до нескольких сервисов (segment). Делается это для того, чтобы лучше утилизировать ресурсы серверов и в первую очередь процессоры. Мастер хранит метаданные, отвечает за связь клиентов с данными, а также распределяет работу между сегментами.
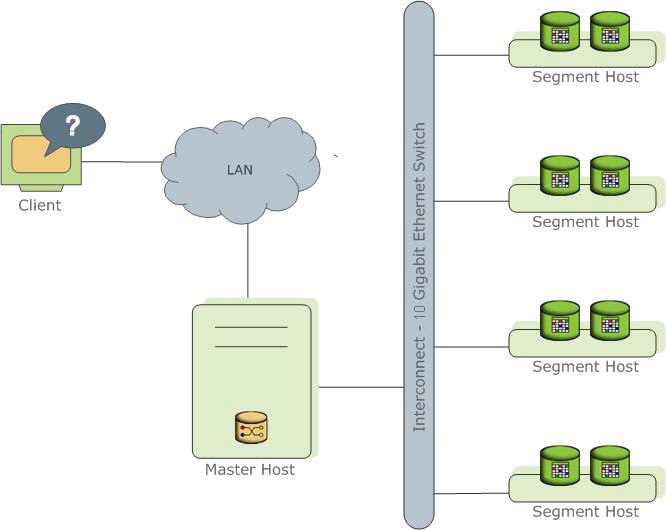
Подробнее можно почитать в официальной документации.
Далее в статье будет много отсылок к плану запроса. Информацию для Greenplum можно получить тут.