
Еще до Google Maps в 1998 году у пользователей сети Интернет была возможность посетить другой город, страну или континент, не выходя из дома. Это был первый крупнейший в мире онлайн атлас, который сочетал в себе как спутниковые, так и топографические снимки Земли. Проект носил название TerraServer и содержал в себе более 8 ТБ данных с изображениями от Геологической службы Соединенных Штатов (USGS) и СПИН-2 (SPIN-2), которые обрабатывались базой данных SQL. У данного проекта была всего одна цель и она заключалась вовсе не в том, чтобы помогать пользователям сидя перед монитором «перелетать» через горизонт. Нет, задачей TerraServer была демонстрация возможностей Microsoft: программное обеспечение компании могло обрабатывать самую большую базу данных без каких-либо проблем.
Рубрика «sql» - 58
TerraServer бесполезный сервис или упущенная возможность?
2016-07-25 в 15:24, admin, рубрики: Google, legato, microsoft, Microsoft SQL Server, sql, StorageTek 9710 TimberWolf, TerraServer, Блог компании ua-hosting.company, карты, обработка изображений, СУБД SQL Microsoft, метки: TerraServer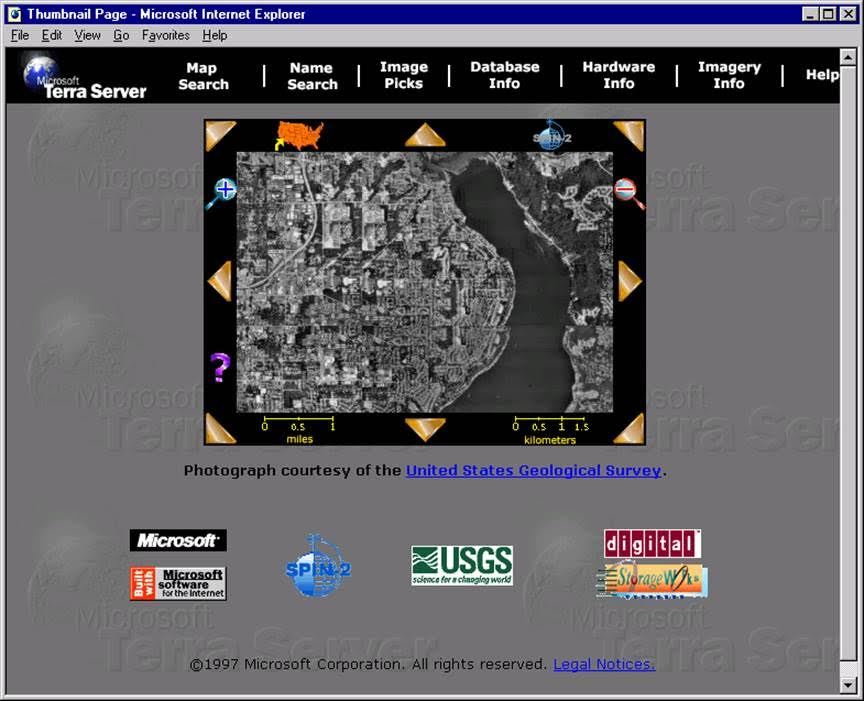
Oracle, обход мутирующих таблиц
2016-07-23 в 22:53, admin, рубрики: oracle, sql, мутирование талиц, обход мутации, Программирование
Рис.1 – художники мутанты ниндзя черепашки
Мутирование таблиц (ошибка ORA-04091) возникает, если в триггере уровня строки выполняется изменение или чтение данных из той же самой таблицы, для которой данный триггер должен был сработать.
Рассмотрим два способа обхода данной ситуации. Первый – через пакет – древний, как удар маваши гери с разворота, смотрится эффектно, но долго готовится и сложен в исполнении. Второй – более свежий и простой – с использованием составных триггеров.
Читать полностью »
Жадная загрузка в Yii2, для тех кто хочет понять что это такое
2016-07-22 в 13:14, admin, рубрики: sql, web, with, yii, yii2, yii2 framework, жадная загрузка, Разработка веб-сайтовПост рассказывает для чего необходимо использовать «жадную загрузку», вместо «ленивой загрузки», не претендует на идеал. И вряд ли заинтересует профессионалов, больше подходит для начинающих в изучении YII2.
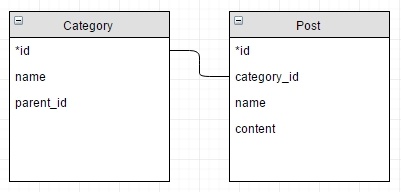
Используем жадную загрузку в своем приложении. Допустим у нас имеется две таблицы с постами и категориями. У каждого поста возможна одна категория, у категорий 1 или более постов.
Бекап баз данных через SQL VDI
2016-07-22 в 7:38, admin, рубрики: .net, 7z, backup, Microsoft SQL Server, sql, vdi, архивированиеХочу рассказать о том, как мы захотели сделать собственный бекап баз данных для Microsoft SQL Server, и что из этого получилось.
Проблема
Мы в компании используем Microsoft SQL Server, и вполне ожидаемо, что нам надо делать бекапы баз данных для него, что мы успешно делаем. Делается это следующим образом:
- Первый скрипт делает бекапы нужных баз данных
- Второй скрипт проходит по папкам с бекапами и архивирует их в 7zip
- Третий скрипт уносит эти бекапы на внешнее хранилище
Вроде всё логично на мой взгляд, но есть некая странность во всём этом. Так как некоторое время на сервере находятся файлы, которые активно занимают место, а потом данные файлы удаляются за ненадобностью. Хотелось всё это оптимизировать. Кроме того, у нас в комании есть продукт, одной из задач которого является синхронизация базы данных, и ему подобный код, оптимизирующий задачу, тоже очень пригодился бы.
Релиз DataGrip 2016.2: Импорт CSV, поддержка JSON и XML в строках, динамический SQL, улучшения для PostgreSQL
2016-07-21 в 13:18, admin, рубрики: DataGrip, jetbrains, Microsoft SQL Server, mysql, postgresql, sql, Блог компании JetBrainsПривет! У нас пора релизов. Это пост о том, что интересного в новой версии DataGrip — нашей IDE для SQL. Эти изменения также касаются IntelliJ IDEA, PyCharm, PhpStorm и RubyMine — тех инструментов от JetBrains, где есть поддержка баз данных.

Вот, что мы добавили:
Как думать на SQL?
2016-07-19 в 9:09, admin, рубрики: mysql, postgresql, sql, Администрирование баз данных, база данных, язык запросовНадо “
SELECT * WHERE a=b FROM c” или “SELECT WHERE a=b FROM c ON *” ?
Если вы похожи на меня, то согласитесь: SQL — это одна из тех штук, которые на первый взгляд кажутся легкими (читается как будто по-английски!), но почему-то приходится гуглить каждый простой запрос, чтобы найти правильный синтаксис.
А потом начинаются джойны, агрегирование, подзапросы, и получается совсем белиберда. Вроде такой:
SELECT members.firstname || ' ' || members.lastname
AS "Full Name"
FROM borrowings
INNER JOIN members
ON members.memberid=borrowings.memberid
INNER JOIN books
ON books.bookid=borrowings.bookid
WHERE borrowings.bookid IN (SELECT bookid
  FROM books
  WHERE stock>(SELECT avg(stock)
    FROM books))
GROUP BY members.firstname, members.lastname;
Буэ! Такое спугнет любого новичка, или даже разработчика среднего уровня, если он видит SQL впервые. Но не все так плохо.
Легко запомнить то, что интуитивно понятно, и с помощью этого руководства я надеюсь снизить порог входа в SQL для новичков, а уже опытным предложить по-новому взглянуть на SQL.Читать полностью »
Список полезных ресурсов по Microsoft SQL Server
2016-07-18 в 15:15, admin, рубрики: Microsoft SQL Server, sql, sql server, sql server 2008, sql server 2008 r2, sql server 2012, sql server 2014, sql server 2016, Администрирование баз данныхСписок из 144 бесплатных и платных интернет ресурсов для изучения и работы с Microsoft SQL Server.
Статья в формате markdown на английском языке доступна на Github
Что такое большие данные, часть 1
2016-07-15 в 10:14, admin, рубрики: amazon, big data, data mining, sql, Администрирование баз данных, Большие данные, информация, история, хранение данных
Большие данные — это Большие Новости, Большая Важность и Большой Бизнес, но что это на самом деле? Что такое большие данные? Для тех, кто живёт ими, всё очевидно, а я просто тупица — задавать подобные вопросы. Но те, кто живёт ими, считают большинство людей глупыми, верно? Поэтому в начале я хочу поговорить с теми читателями, которые, как и я, не в теме. Что это вообще такое? На этой неделе я планирую хорошенько исследовать этот вопрос, и, скорее всего, опубликовать три длинных статьи (прим. переводчика: переводы следующих двух частей выйдут в ближайшие дни).Читать полностью »
Как написать SQL-запрос на Slick и не открыть портал в ад
2016-07-14 в 16:01, admin, рубрики: java, orm, scala, Slick, sql, Блог компании Группа компаний «ЦИТ» (Центр ИТ), монады, функциональное программирование, метки: Slick
Slick — это не только фамилия одной из величайших солисток всех времён, но и название популярного Scala-фреймворка для работы с базами данных. Этот фреймворк исповедует «функционально-реляционный маппинг», реализует реактивные паттерны и обладает официальной поддержкой Lightbend. Однако отзывы разработчиков о нём, прямо скажем, смешанные — многие считают его неоправданно сложным, и это отчасти обоснованно. В этой статье я поделюсь своими впечатлениями о том, на что стоит обратить внимание при его использовании начинающему Scala-разработчику, чтобы в процессе написания запросов случайно не открыть портал в ад.
Читать полностью »
Анализ логов с помощью SQL?
2016-07-10 в 12:35, admin, рубрики: data mining, php, spark, sql, Разработка веб-сайтовПредставьте, что мы хотим написать на обычном SQL запрос не в базу данных, а к логам. В работе может возникнуть задача анализа логов, для которой потребуется делать запросы на SQL к неструктурированному набору данных, который даже не находится в СУБД. В этой заметке я расскажу о примере использования Spark SQL для выявления правил (логики) выбора необходимых документов из большого хранилища.