

Не так давно мы писали про Читать полностью »
Не так давно мы писали про Читать полностью »
Всем привет! Команда Qwen от Alibaba выложила в открытый доступ Qwen3-TTS — нейросетевую модель для синтеза речи с клонированием голоса. Сегодня хочу рассказать об этой технологии подробнее и поделиться портативной версией.

Всё шло к этому. Мы решилиЧитать полностью »
Наконец-то представляем наш синтез для языков России и СНГ. В этот раз получилось покрыть 20 языков, всего 95 голосов. От старой демки этот релиз отличается следующим:
2 октября 2025 года компания Neuphonic представила NeuTTS Air - открытую модель преобразования текста в речь, которая кардинально меняет подход к синтезу голоса. Главная особенность в том, что она работает полностью локально на обычных устройствах без необходимости подключения к интернету или облачным сервисам.
В конце июня этого года я возвращался с дачи, слушая радио в машине. Новости по радио выходят раз в час, и их разнообразие оставляет желать лучшего. Тогда я подумал: было бы здорово, если бы было приложение, которое автоматически собирало новости из Telegram-каналов и озвучивало их голосом на русском языке.
Вернувшись домой, я поискал готовое решение, но ничего подходящего в интернете не нашёл. Решил спросить у ИИ.
Мой диалог с ChatGPT начался так:
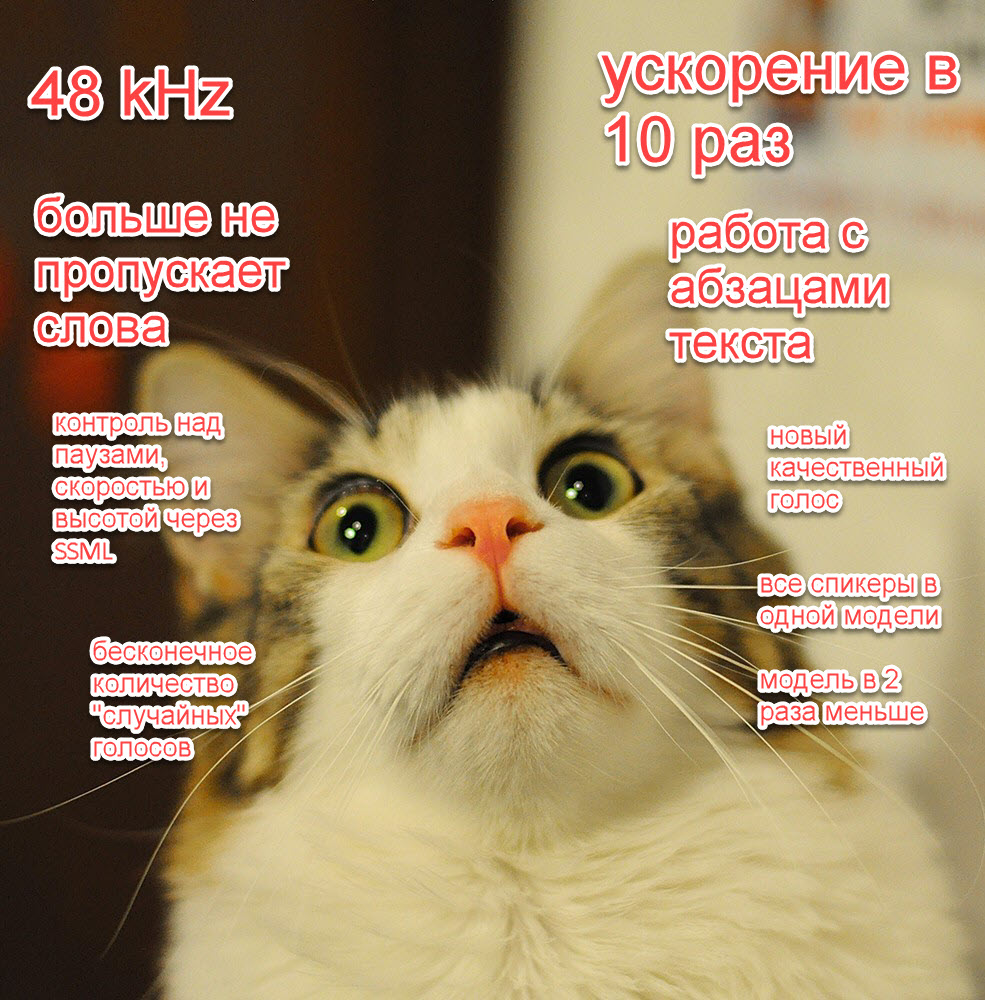
В нашей прошлой статье мы ускорили наши модели в 10 раз, добавили новые высококачественные голоса и управление с помощью SSML, возможность генерировать аудио с разной частотой дискретизации и много других фишек.
В этот раз мы добавили:
eugeny);ё со словарем в 4 миллиона слов и точностью 100% (но естественно с рядом оговорок);Пока улучшение интерфейсов мы отложили на некоторое время. Ускорить модели еще в 3+ раза мы тоже смогли, но пока с потерей качества, что не позволило нам обновить их прямо в этом релизе.
Попробовать модель как обычно можно в нашем репозитории и в колабе.
В нашей прошлой статье про синтез речи мы дали много обещаний: убрать детские болячки, радикально ускорить синтез еще в 10 раз, добавить новые "фишечки", радикально улучшить качество.
Сейчас, вложив огромное количество работы, мы наконец готовы поделиться с сообществом своими успехами:
Это по-настоящему уникальное и прорывное достижение и мы не собираемся останавливаться. В ближайшее время мы добавим большое количество моделей на разных языках и напишем целый ряд публикаций на эту и смежные темы, а также продолжим делать наши модели лучше (например, еще в 2-5 раз быстрее).
Попробовать модель как обычно можно в нашем репозитории и в колабе.
Мы были очень рады, что наша прошлая статья понравилась Хабру. Мы получили много позитивной и негативной обратной связи. Также в ней мы сделали ряд обещаний по развитию нашего синтеза.
Мы достигли существенного прогресса по этим пунктам, но ультимативный релиз со всеми новыми фичами и спикерами может занять относительно много времени, поэтому не хотелось бы уходить в радиомолчание надолго. В этой статье мы ответим на справедливую и не очень критику и поделимся хорошими новостями про развитие нашего синтеза.
Если коротко: