
Мы заворачиваем бинарные данные в base64 чтобы гонять их по текстовым протоколам…
Рубрика «highload» - 18
IT — плохая наука
2014-08-06 в 16:23, admin, рубрики: BigData, highload, высокая производительность, идиоты, Программирование, производительностьКак развивать облачный сервис: обеспечиваем бесперебойную работу и добавляем возможности
2014-07-24 в 13:07, admin, рубрики: highload, product management, release management, SaaS, SaaS / S+S, Блог компании МойСклад, облака, Облачные вычисленияЕсли использовать известное сравнение, развитие облачного сервиса — задача, похожая на замену двигателя на летящем самолете. Но альтернативы нет — ты безнадежно отстанешь, если не будешь постоянно меняться. Сервис МойСклад постоянно меняется уже 7 лет. В этом посте поговорим о том, как это происходит.
Хайлоад в облаке на живом примере
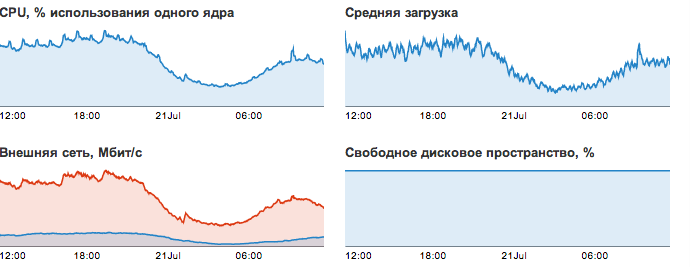
2014-07-21 в 7:49, admin, рубрики: highload, Блог компании Перформикс, мониторинг сервера, Облачные вычисления, облачный хостинг, хозяйке на заметку, хостингЗдравствуйте, с вами хостинг Flops.ru и сегодня мы расскажем о результатах переноса довольно большого и нагруженного проекта в наше облачное окружение. Проект о котором идет речь — линейка адблок-приложений Adguard, разработчики которой любезно поучаствовали в подготовке этой статьи.
В статье мы расскажем о виртуальной инфраструктуре проекта, результатах переноса в облако, а заодно перечислим несколько интересных узких мест и багов, которые удалось обнаружить благодаря миграции. И заодно дадим некоторое количество графиков, иллюстрирующих работу проекта. В общем, приглашаем под кат.
Работа с геолокациями в режиме highload
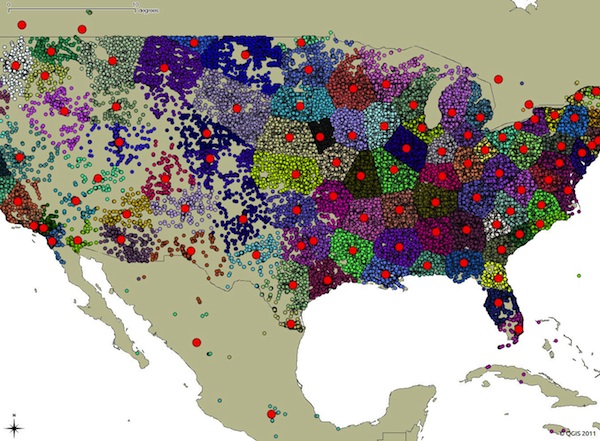
2014-07-01 в 18:05, admin, рубрики: big data, BigData, geo, highload, postgis, postgresql, Алгоритмы, Геоинформационные сервисы, метки: BigData, geo, highload, postgis, postgresql, АлгоритмыПри разработке ПО часто возникают интересные задачи. Одна из таких: работа с гео-координатами пользователей. Если вашим сервисом пользуются миллионы пользователей и запросы к РСУБД происходят часто, то выбор алгоритма играет важную роль. О том как оптимально обрабатывать большое количество запросов и искать ближайшие гео-позиции рассказано под катом.
Оптимизация nginx
2014-06-05 в 9:43, admin, рубрики: highload, nginx, оптимизация, Серверная оптимизация, Серверное администрирование Как известно, nginx очень продуктивный веб-сервер, но всё же его тоже можно ускорить. Я облазил интернет и решил все советы собрать в одном месте.
Читать полностью »
PHP + Java, или In-memory кластер теперь и для PHP разработчиков
2014-05-26 в 7:59, admin, рубрики: caching, cluster, highload, in-memory-data-grid, open source, php, высокая производительность, кеширование, кластер, кэшированиеIntro
PHP + Java. Картинка взята отсюда
В этом комментарии к статье под названием «Пишите код каждый день» я сказал, что скоро покажу свой проект, на который я выделял ежедневно 1 час (кроме выходных). Так как в последнее время моя работа связана с написанием распределенных Java приложений, которые используют in-memory data grid (IMDG) в качестве хранилища данных, то мой проект связан именно с этим.
Подробнее про IMDG можно почитать в моих предыдущих статьях (1, 2). Но если кратко, то это кластерное распределенное хранилище объектов по ключам, которое держит все данные в памяти, за счет чего достигается высокая скорость доступа к данным. Позволяет не только хранить, но и обрабатывать данные, не извлекая их из кластера.
И если интерфейс для обработки данных у каждого конкретного IMDG свой, то интерфейс доступа к данным обычно идентичен хеш-таблице.
О чем эта статья
Большинство IMDG написано на Java и поддерживают API для Java, C++, C#, при этом API для веб языков программирования (Python, Ruby, PHP) не поддерживается, а протокол для написания клиентов сильно ограничен. Именно этот факт я и считаю основным тормозом для проникновения IMDG в массы — отсутствие поддержки самых массовых языков.
Так как производители IMDG пока не предоставляют поддержку веб языков, то веб программисты не имеют возможностей по такому же легкому масштабированию приложений, какие есть у серверных Java разработчиков. Поэтому я решил сделать нечто подобное самостоятельно и выложить в open source, взяв в качестве движка open source IMDG JBoss Infinispan (компания JBoss, принадлежащая Red Hat, довольно хорошо известна в кругу java разработчиков). Мой проект называется Sproot Grid, пока доступен только для PHP, но если у сообщества будет интерес, то сделаю и интеграцию с Ruby и Python.
В этой статье я еще раз расскажу про in-memory data grid и про то, как конфигурировать, запускать и использовать Sproot Grid.
Читать полностью »
PRFRL — как устроен интерфейс аналитики
2014-05-15 в 17:16, admin, рубрики: highload, newrelic, php, pinba, xdebug, Блог компании PRFLR, производительность, метки: highload, newrelic, pinba, xdebug, производительностьВ этом посте хотелось бы рассказать больше про концепцию панели аналитики. Собственно именно она дает разработчикам уникальные возможности для поиска проблемных по производительности мест в коде.
PRFLR — это система аналитики, направленная на скорейшее обнаружения проблемных по производительности мест в работе приложений. Realtime и непосредственно на Production серверах.
В первую очередь PRFLR ориентирован на высоконагруженные серверные приложения работающие на больших кластерах, однако применим для небольших проектов, десктоп и мобильных приложений. Конечно если вас действительно волнует вопрос их быстродействия.
Начинаем работать с графовой базой данных Neo4j
2014-04-16 в 10:51, admin, рубрики: highload, neo4j, php, метки: highload, neo4j, PHPВ нашем проекте возникла следующая задача — есть база с большим количеством товаров, на уровне сотен тысяч. У каждого товара есть сотни динамически создаваемых характеристик. Необходимо обеспечить быструю фильтрацию по товарам по набору различных характеристик. Время формирования ответа должно быть не более 0.3 секунды, нужно поддерживать сложную логику в стиле.
(характеристика1 = true AND (характеристика2 < 100)) OR (характеристика1 = false AND (характеристика3 > 17)) ... далее обычно мешанина из ANDORТипичный пример подобного функционала — hotline.ua/computer/myshi-klaviatury/

У нас все реализовано в рамках MySQL + Symfony2/Doctrine, скорость неудовлетворительная — ответы формируются в течении 1-10 секунд. Мои попытки оптимизировать все это хозяйство — под катом.
Читать полностью »
Мифы и легенды про Big Data
2014-04-09 в 5:25, admin, рубрики: big data, highload, java, аналитика, Блог компании ВымпелКом (Билайн), реляционные базы данных, телефония, метки: big data, highload, java, аналитика, реляционные базы данных 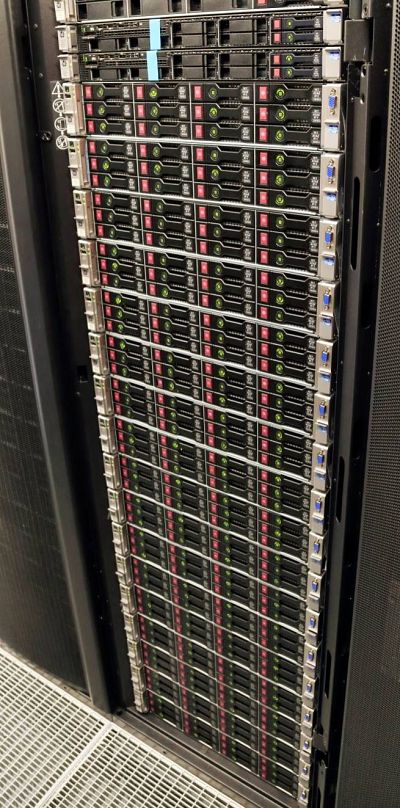
Один из наших кластеров для пилотных задач (Data node: 18 servers /2 CPUs, 12 Cores, 64GB RAM/, 12 Disks, 3 TB, SATA — HP DL380g)
— Что такое Big Data вообще?
Все знают, что это обработка огромных массивов данных. Но, например, работа с Oracle-базой на 20 Гигабайт или 4 Петабайта — это ещё не Big Data, это просто highload-БД.
— Так в чём ключевое отличие Big Data от «обычных» highload-систем?
В возможности строить гибкие запросы. Реляционная база данных, в силу своей архитектуры, предназначена для коротких быстрых запросов, идущих однотипным потоком. Если вы вдруг решите выйти за пределы таких запросов и собрать новый сложный, то базу придётся переписывать – или же она умрёт под нагрузкой.
— Откуда берётся эта новая нагрузка?
Если чуть углубиться в архитектуру, то можно увидеть, что традиционные базы данных хранят информацию очень дисперсионно. Например, у нас номер абонента может быть на одном сервере в одной таблице, а его баланс — в другой таблице. Быстродействие требует максимального разбиения данных. Как только мы начинаем делать сложные join'ы, производительность резко падает. Читать полностью »
Один год из жизни проекта Ответы@Mail.ru
2014-03-07 в 10:16, admin, рубрики: hardware, high performance, highload, Блог компании Mail.Ru Group, высокая производительность, ит-инфраструктура, метки: hardware, high performance, highload 
В данной статье я постараюсь вспомнить и описать все сложности и подводные камни, которые встречались на пути реализации задач, связанных с проектом Ответы, также расскажу и про архитектуру проекта.
Все началось с того, что мой контракт подошел к концу (в течение года я участвовал в работе над почтой Mail.ru). «Снова меня ждут приключения», — пронеслось в мыслях, — «новая страна, новая работа». Я пошел к своему начальству и в ходе обсуждений все-таки получил порцию приключений в виде интересной задачки — заняться проектом Ответы.Читать полностью »