
При сопровождении ERP систем иногда возникает необходимость массового изменения кода процедур, функций, триггеров или пакетов. Например для замены вызова одной процедуры на вызов другой.
Если надо поменять пару процедур, то можно сделать это в ручную, но когда надо изменить несколько сотен объектов, то приходиться задуматься об автоматизации процесса. В статье описан пример автоматизации для СУБД ORACLE 11g.
Читать полностью »
Рубрика «sql» - 63
Изменение исходников ( DDL ) на лету
2016-03-31 в 21:45, admin, рубрики: DDL, ERP-системы, oracle, sql, Анализ и проектирование систем, инструменты разработчика, КодоБред, ораклМасштабирование до 100 миллионов пользователей. Кэшировать или не кэшировать?
2016-03-30 в 15:49, admin, рубрики: api, cash, ehcache, java, join, mysql, sql, wix.com, Блог компании Wix.com, конструктор сайтов, кэш, кэширование запросов, кэширование на практике, создание сайтов Это вторая часть цикла «Масштабирование Wix до 100 миллионов пользователей». Вступление читайте тут.
Когда мы только запускали Wix, был использован стек Tomcat, Hibernate и Ehcache c базой данных MySQL и фронтендом на Flash. Почему мы выбрали этот стек? Да просто потому, что у нашего первого бэкенд-разработчика уже был опыт работы с ним. Частью этой архитектуры был Ehcache – отличная кэш-библиотека для Hibernate и JVM, которая создавала абстракцию в виде карты для кэша памяти и которая могла также быть сконфигурирована как распределенный кэш. Ehcache, в отличие от Memcached, запускается как процесс в JVM и в точности реплицирует состояние кэша для всех узлов кластера. Обратим внимание, что в то время (около 2006–2008 гг.) Encache все еще был независимым open source проектом и не был частью Terracotta (в рамках Terracotta модель репликации и дистрибуции может быть иной, но для данной статьи это не столь важно).
Аспекты использования кэша
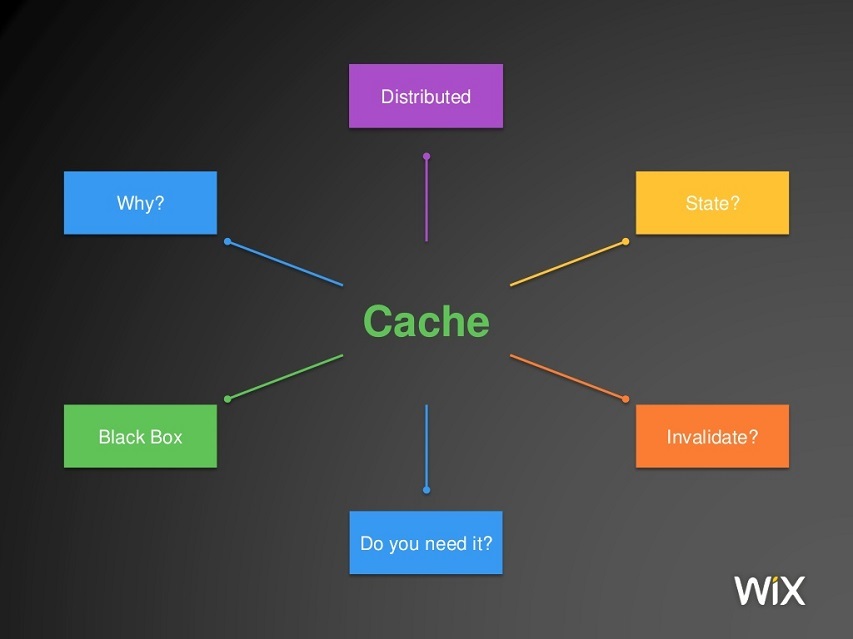
Поскольку у нас уже были реальные клиенты, мы установили два сервера Tomcat для обеспечения дополнительной надежности. Следуя правилам выстраивания архитектуры, мы установили распределенный Ehcache-кластер между серверами. Мы исходили из того, что MySQL работает медленно (как и любая другая SQL-система), а значит кэш оперативной памяти обеспечит гораздо более высокую скорость чтения и снизит нагрузку на базу данных.Читать полностью »
Визуализация инструментов обработки данных с Github
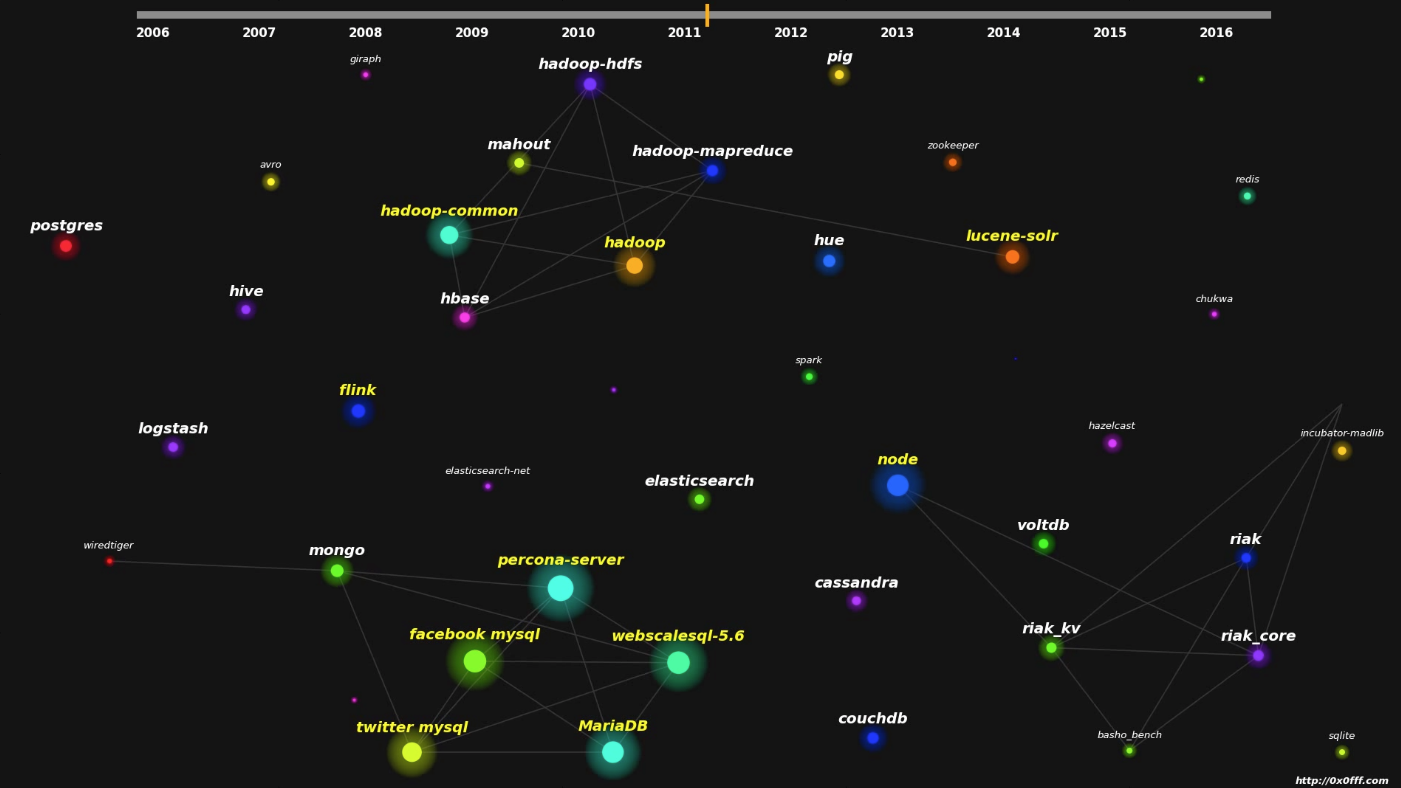
2016-03-29 в 9:31, admin, рубрики: big data, github, Hadoop, mysql, nosql, postgres, postgresql, spark, sql, visualizationВ своей работе вы используете MySQL, Postgres или Mongo, а может даже Apache Spark? Хотите знать с чего начинались эти проекты и куда они движутся сейчас? В этой статье я представлю соответствующую визуализацию
Microsoft DevCon 2016 — компьютерное зрение, SQL Server 2016, Data Science и не только
2016-03-28 в 8:28, admin, рубрики: azure, data science, devcon, DevCon 2016, Microsoft Azure, Microsoft SQL Server, open source, sql, sql server 2016, windows, Блог компании Microsoft, разработка под windows, метки: devcon 2016
Друзья, с удовольствием делюсь с вами анонсами сразу нескольких мастер-классов, которые ожидают участников в первый день конференции DevCon 2016!
Новый формат конференции предлагает вам окунуться не просто в атмосферу технологий Microsoft, а с помощью наших экспертов затронуть самые актуальные темы разработки под Windows, использования сервисов Azure, особенностей нового выпуска SQL Server 2016 и аналитики данных.
Мы рады представить вам темы мастер-классов и познакомить с экспертами:
Читать полностью »
Интерфейс работы с таблицей: быстро-неудобно — медленно-удобно
2016-03-25 в 11:21, admin, рубрики: offset, sql, интерфейсы, разработка, таблица, метки: грид, таблицаЕсть вопросы, которые, казалось бы, не могут быть не решены. Слишком часто мы с ними встречаемся в повседневной жизни. Но посмотришь внимательно — и оказывается, нет, не решены. Все делают по-разному. И не всегда хорошо. Одним из таких вопросов является взаимодействие пользовательского интерфейса работы с таблицей и системы управления базами данных (СУБД).
Требования понятны. Данные должны отображаться быстро, создавать минимальную нагрузку на СУБД и работа с ними должна быть удобна пользователю. Решения вроде тоже все есть. Но все равно даже в очень успешных проектах применены технологии, которые заставляют предположить, что разработчики решили еще раз придумать “самое лучшее” решение.
Хотелось бы рассмотреть современные подходы к решению этой задачи и подумать, есть ли наилучший вариант. И, если нет, когда что лучше использовать. Читать полностью »
Строим надёжный процессинг данных — лямбда архитектура внутри Google BigQuery
2016-03-17 в 5:00, admin, рубрики: big data, big data analytics, bigquery, data mining, etl, sql, Администрирование баз данных, базы данных, хранение данных, метки: big data analytics, bigquery В этой статье хочу поделиться способом, который позволил нам прекратить хаос с процессингом данных. Раньше я считал этот хаос и последующий ре-процессинг неизбежным, а теперь мы забыли что это такое. Привожу пример реализации на BiqQuery, но трюк довольно универсальный.
У нас вполне стандартный процесс работы с данными. Исходные данные в максимально сыром виде регулярно подгружаются в единое хранилище, в нашем случае в BigQuery. Из одних источников (наш собственный продакшн) данные приходят каждый час, из других (обычно сторонние источники) данные идут ежедневно.
В последствии данные обрабатываются до состояния пригодного к употреблению разнообразными пользователями. Это могут быть внутренние дашборды; отчёты партнёрам; результаты, которые идут в продакшн и влияют на поведение продукта. Эти операции могут быть довольно сложными и включать несколько источников данных. Но по большей части мы с этим справляется внутри BigQuery с помощью SQL+UDF. Результаты сохраняются в отдельные таблицы там же.
Читать полностью »
SQL Server 2016 RC0
2016-03-09 в 16:40, admin, рубрики: Microsoft SQL Server, sql, sql server, sql server 2016, Администрирование баз данных  На глаза попалась уже вторая новость на Хабре о том, что скоро Microsoft «подружит» SQL Server и Linux.
Но ни слова не сказано про SQL Server 2016 Release Candidate, который стал доступен для загрузки буквально на днях.
В следующем месяце планируется выпустить RTM, поэтому далее под катом разбор некоторых нововведений, которые будут доступны в рамках новой версии: отличия в установке, дефолтные трейс-флаги, новые функции и киллер-фича для анализа плана выполнения.
Читать полностью »
Не пропустите подробности о новом SQL Server 2016 и поддержке Linux, смотрите онлайн мероприятие 10 марта в 18:00 (MCK)
2016-03-09 в 11:22, admin, рубрики: linux, Microsoft SQL Server, sql, sql server, Администрирование баз данных, базы данных, Блог компании MicrosoftПодключайтесь к прямой трансляции из Нью-Йорка «Презентация платформы управления данными на базе SQL Server 2016»

Добавьте мероприятие в календарь.
По нашей ссылке на трансляцию будет доступен синхронный перевод на русский язык.
Когда: 10 марта 2016
Начало трансляции: 18:00 (МСК)
Читать полностью »
Тестирование базы данных. Версия разработчика
2016-03-09 в 9:10, admin, рубрики: eclipse, sql, тестирование, Тестирование IT-системНесколько лет занимаюсь программированием баз данных и столько же вижу как непросто идет тестирование функционала, реализованного в самой базе. Такая задача требует от тестировщика не только знаний SQL, но, порой, и понимания тонкостей работы тестируемого функционала. А разработчики не всегда стремятся описать свое решение во всех деталях.
Стало интересно — как сейчас тестируется логика базы данных.Читать полностью »
История про хитрожо… индуса, encrypted procedures, DAC и «режим Бога»
2016-03-07 в 14:30, admin, рубрики: dac, dedicated administrator connection, MetaData, Microsoft SQL Server, sql, sql server, stored procedures, sys.sysobjvalues, with encryption, криптография  На той неделе пришлось разбираться в логике работы одного бесплатного тула. Почти детективная история вышла с ее автором, который впоследствии оказался индусом канадского происхождения проживающим в Южной Америке. Конечно же, практическая ценность была не в биографии автора, а в запросах, которые отправлялись приложением на сервер.
Установил. Запустил. Стал в стоечку и начал собирать профайлером все, чем приложение должно было «порадовать» сервер. Смею разочаровать – ничего радостного сервер в ближайшие два часа не увидел. В основном встречались разного рода перлы в запросах, которые явно не претендовали на комплименты:
SELECT
    LogTruncations = (
        SELECT TOP 1 SUM(cntr_value)
        FROM ##tbl_cnt
        WHERE counter_name = 'Log Truncations'
    ),
    LogShrinks = (
        SELECT TOP 1 SUM(cntr_value)
        FROM ##tbl_cnt
        WHERE counter_name = 'Log Shrinks'
    ),
    LogGrowths = (
        SELECT TOP 1 SUM(cntr_value)
        FROM ##tbl_cnt
        WHERE counter_name = 'Log Growths'
    ),
    ...
Поскольку их можно написать на порядок проще и сократить логические чтения из таблицы:
SELECT
    LogTruncations = SUM(CASE WHEN counter_name = 'Log Truncations' THEN cntr_value END),
    LogShrinks = SUM(CASE WHEN counter_name = 'Log Shrinks' THEN cntr_value END),
    LogGrowths = SUM(CASE WHEN counter_name = 'Log Growths' THEN cntr_value END),
    ...
FROM ##tbl_cnt
На этом можно было бы и закончить… Но практически под конец я увидел, что приложение вызывает пользовательские хранимые процедуры из tempdb. Поймал себя на мысли: «Когда приложение успело их создать… и главное зачем?»
Читать полностью »