Рубрика «data mining» - 37

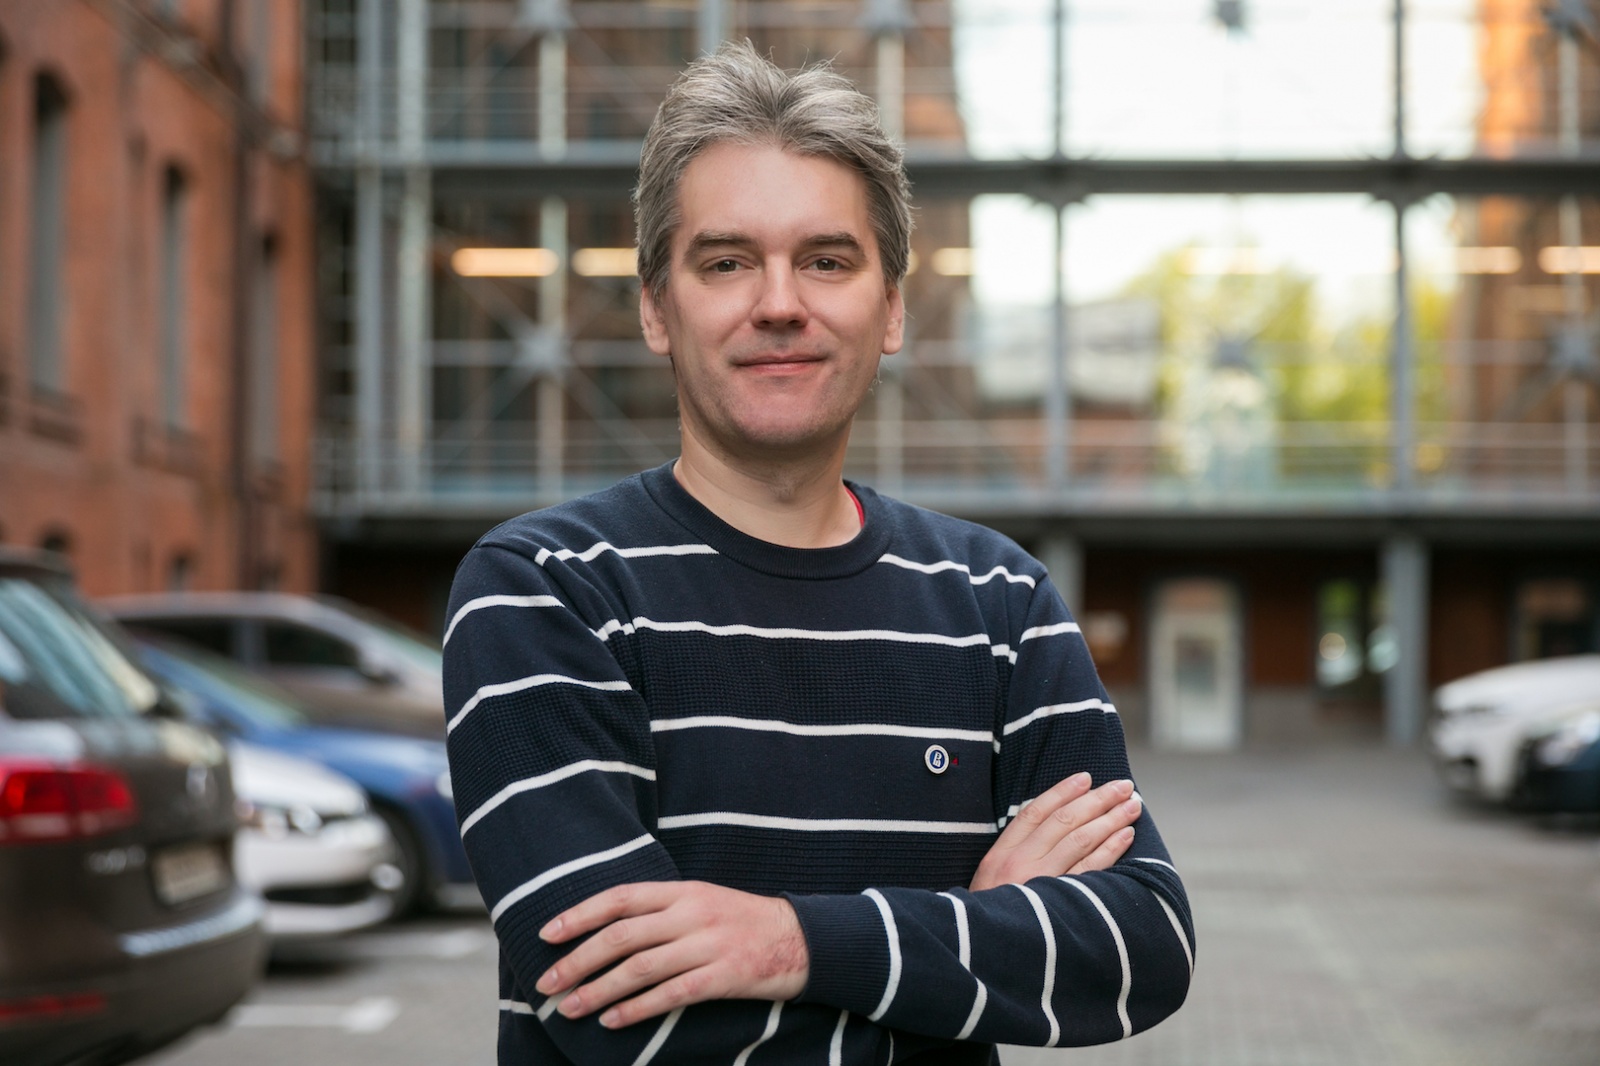
О машинном обучении, истории и жизни с Дмитрием Ветровым - 1

В рамках открытого курса по машинному обучению мы продолжаем общаться с заметными представителями этой области. Нашими первыми собеседниками были Александр Дьяконов, Константин Воронцов и Евгений Соколов, см. видео в YouTube-канале курса. В этот раз мы пообщались с Дмитрием Ветровым.

Читать полностью »

Пойди туда, не знаю куда: по следам конференции SmartData - 1

Конференций, связанных с AI / ML / data science в последнее время и у нас стало довольно много. Организаторы до сих пор ищут форматы, концепции конференций меняются, но состав спикеров повторяется процентов на 50.

Задача поиска формата стояла и перед программным комитетом SmartData. Задача эта довольно размытая. Кто тот человек, который занимается анализом и / или обработкой данных, что ему интересно? От участников конференции мы получили частичные ответы на эти вопросы, но данных хочется больше. В связи с этим хочу поделиться тем представлением об идеальном мире, которое сложилось на данный момент, и пригласить читателей к дискуссии в комментариях. Помогите сделать такую конференцию, на которую вам потом самим захочется сходить.

Кроме вопросов о ваших интересах и задачах, за кликом вас ждут две ранее не публиковавшиеся видеозаписи выступлений с первой конференции, технический приём написания текстов на Хабр и один забавный факт о беспилотных автомобилях.
Читать полностью »

Несколько дней назад мы публиковали обзор первого дня Data Science Weekend 2018, который прошел 2-3 марта на Мансарде Rambler&Co. Изучив практику использования алгоритмов машинного обучения, теперь перейдем к обзору второго дня конференции, в течении которого спикеры рассказывали об использовании различных инструментов дата инженера для нужд дата-платформ, ETL, сервисах подсказок при поиске и многом другом.

Обзор второго дня Data Science Weekend 2018. Data Engineering, ETL, поисковые сервисы и многое другое - 1
Читать полностью »

imageС развитием компьютерных мощностей и появлением множества технологий обработки изображений всё чаще стал возникать вопрос: а можно ли научить машину видеть и распознавать образы? Например, отличать кошку от собаки или даже бладхаунда от бассета? О точности распознавания говорить не приходится: наш мозг несравнимо быстрее может понять, что перед нами, при условии, что раньше мы получили достаточно сведений об объекте. Т.е. даже видя только часть собаки, мы можем с уверенностью сказать, что это собака. А если ты — собаковод, то легко определишь и породу собаки. Но как научить машину различать их? Какие существуют алгоритмы? А можно ли обмануть машину? (Спойлер: конечно можно! Точно так же, как и наш мозг.) Попробуем осмыслить все эти вопросы и по возможности ответить на них. Итак, приступим.
Читать полностью »

Искусственный интеллект и машинное обучение — две хайповые тенденции последних лет. Необходимые для AI&ML объемы вычислений обычно выполняются в ЦОДах на специальном высокопроизводительном и энергоэффективном оборудовании (например, серверах с TPU). Эволюция циклична, и маятник качнулся обратно, в сторону вычислений на периферийных устройствах, таких как ПК, планшеты и IoT. В частности, это приведет к повышению скорости реакции устройств на голосовые команды и повысит комфортность общения с персональными ассистентами.

Встречаем Windows Machine Learning — WinML - 1

WinML — это новый набор API-интерфейсов, который позволит разработчикам использовать все возможности любого устройства Windows 10 для вычислений предварительно обученных моделей машинного обучения и загруженных в приложение в формате Open Neural Network Exchange (ONNX).
Читать полностью »

Привет! 2-3 марта на Мансарде наших партнёров, компании Rambler&Co, прошел уже традиционный Data Science Weekend, на котором было множество выступлений специалистов в области работы с данными. В рамках этой статьи расскажем вам о самых интересных моментах первого дня нашей конференции, когда все внимание было уделено практике использования алгоритмов машинного обучения, управлению коллективами и проведению соревнований в области Data Science.

Обзор первого дня Data Science Weekend 2018. Практика машинного обучения, новый подход к соревнованиям и многое другое - 1
Читать полностью »

image
(source)

Иногда мне приходится рассказывать другим людям как работает машинное обучение и, в частности, нейронные сети. Обычно я начинаю с градиентного спуска и линейной регрессии, постепенно переходя к многослойным перцептронам, автокодировщикам и свёрточным сетям. Все понимающе кивают головой, но в какой-то момент кто-нибудь прозорливый обязательно спрашивает:

А почему так важно, чтобы переменные в линейной регрессии были независимы?

или

А почему для изображений используются именно свёрточные сети, а не обычные полносвязные?

"О, это просто", — хочу ответить я. — "потому что если бы переменные были зависимыми, то нам пришлось бы моделировать условное распределение вероятностей между ними" или "потому что в небольшой локальной области гораздо проще выучить совместное распределение пикселей". Но вот проблема: мои слушатели ещё ничего не знают про распределения вероятностей и случайные переменные, поэтому приходится выкручиваться другими способами, объясняя сложнее, но с меньшим количеством понятий и терминов. А что делать, если попросят рассказать про батч нормализацию или генеративные модели, так вообще ума не приложу.

Так давайте не будем мучить себя и других и просто вспомним основные понятия теории вероятностей.

Читать полностью »

Здравствуйте, коллеги! В этой статье я кратко расскажу об особенностях построения решения по классификации тем обращений клиентов в контактный центр, с которыми мы столкнулись при разработке.

Определение тем обращений используется для отслеживания тенденций и прослушивания интересующих записей. Традиционно, эта задача решается путём проставления соответствующего тега оператором, но при данном подходе большую роль играет «человеческий» фактор, и тратится много человеко-часов работы операторов.

Разработка системы классификации тем обращений в контактный центр - 1
Читать полностью »

Статистика в последнее время получила мощную PR поддержку со стороны более новых и шумных дисциплин — Машинного Обучения и Больших Данных. Тем, кто стремится оседлать эту волну необходимо подружится с уравнениями регрессии. Желательно при этом не только усвоить 2-3 приемчика и сдать экзамен, а уметь решать проблемы из повседневной жизни: найти зависимость между переменными, а в идеале — уметь отличить сигнал от шума.

Регрессия

Для этой цели мы будем использовать язык программирования и среду разработки R, который как нельзя лучше приспособлен к таким задачам. Заодно, проверим от чего зависят рейтинг Хабрапоста на статистике собственных статей.

Читать полностью »

Мем об аналитике: - Их аналитика этого не умеет; - Сделай свою; - Долго, да и данных много; - А облако?; - Ты что белены объелся? Дорого!; - $300 за 1kk DAU

На рынке много продуктов, подходящих для игровой аналитики: Mixpanel, Localytics, Flurry, devtodev, deltaDNA, GameAnalytics. Но все же многие игровые студии строят свое решение.

Я работал и работаю со многими игровыми компаниями. Я заметил, что по мере роста проектов, в студиях появляется необходимость в продвинутых сценариях аналитики. После того, как несколько игровых компаний заинтересовались данным подходом, было решено задокументировать его в серии из двух статей.

Ответы на вопросы "Почему?", "Как это сделать?" и "Сколько это стоит?" вы найдете под катом.

Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js