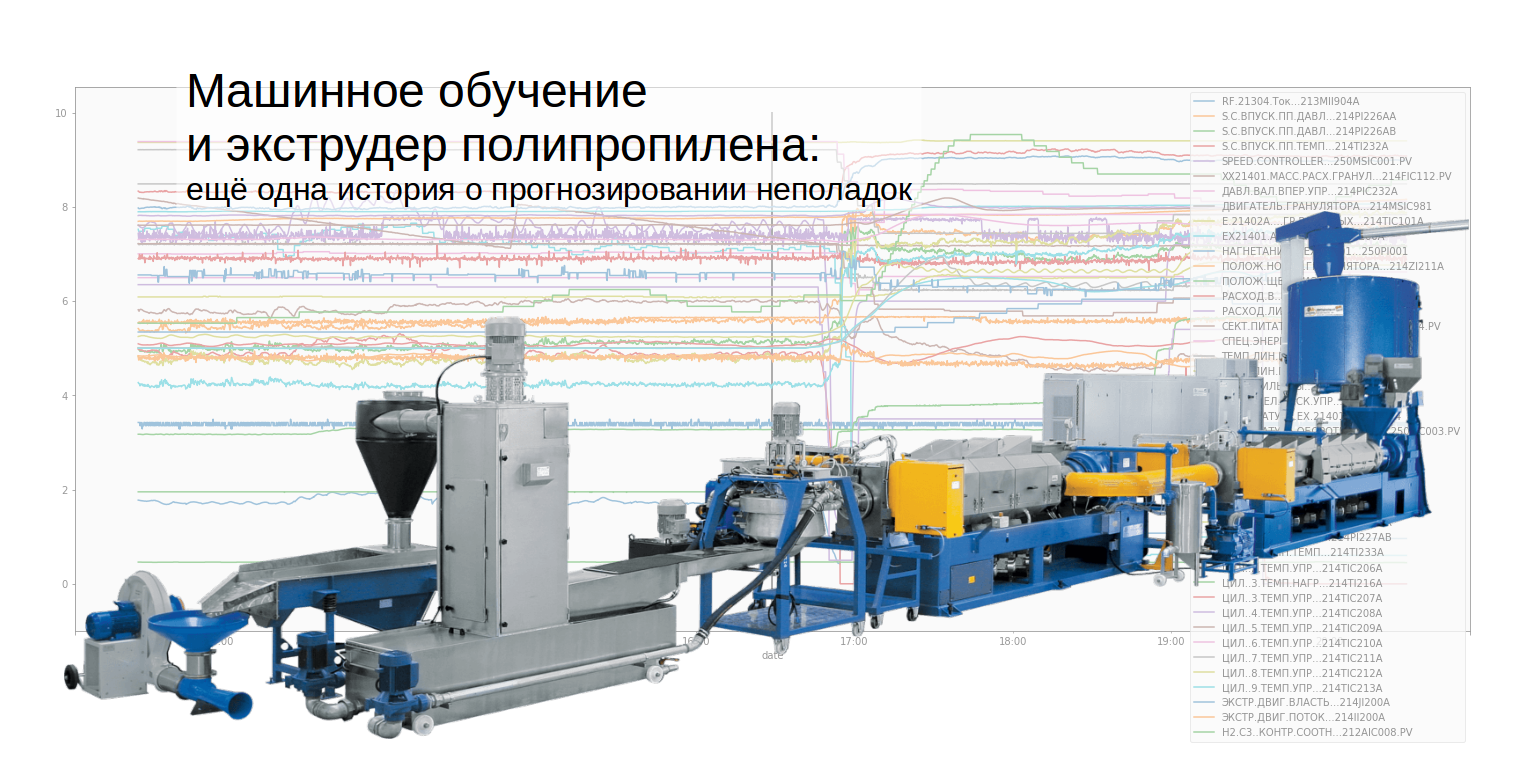
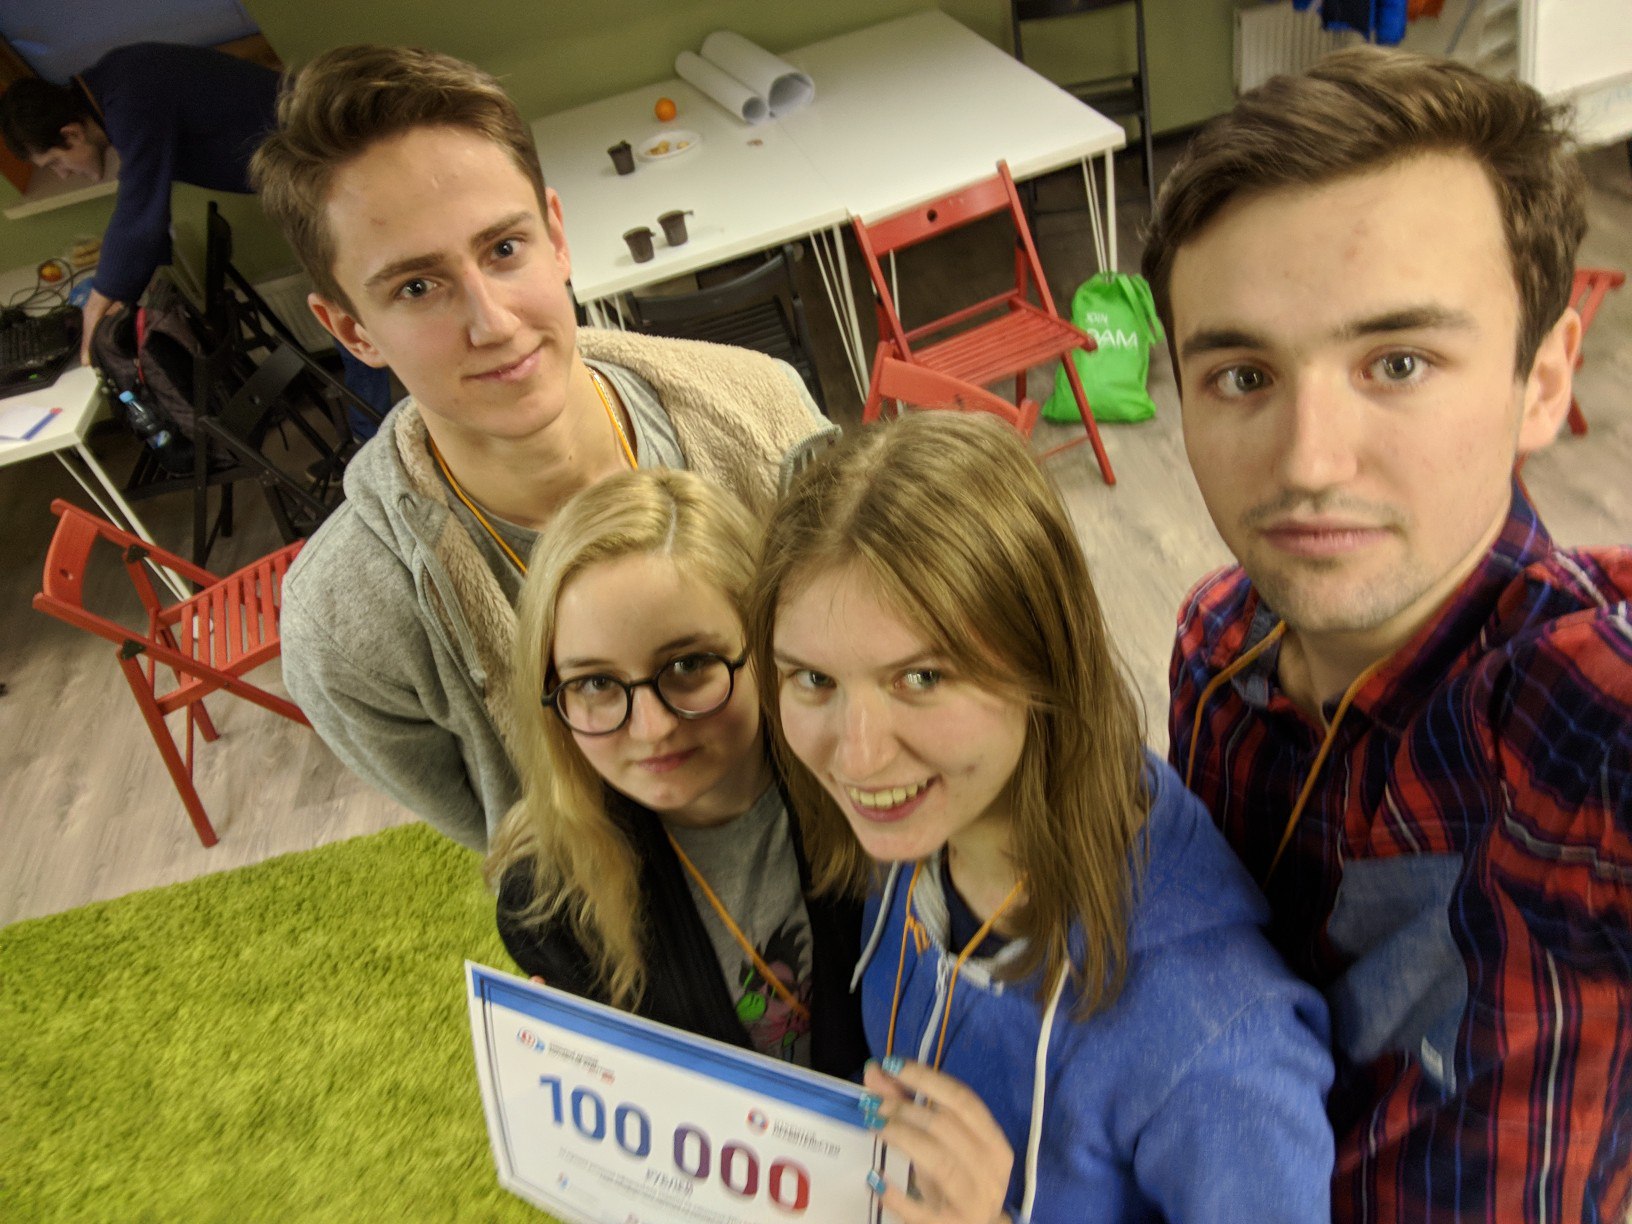
Хакатон "Цифровой завод", организованный Сибуром и AI Community, состоялся на прошлых выходных. Одна из двух задач хакатона была на тему predictive maintenance — нужно было предсказывать проблемы в работе экструдера. Её мы и решили. Рассказ сосредоточен в основном на data science'ной части решения, и о том, как нам удалось научиться неплохо прогнозировать довольно редкие события.
Читать полностью »
Рубрика «data science» - 31
Машинное обучение и экструдер полипропилена: история 3 места на хакатоне Сибура
2018-05-29 в 18:23, admin, рубрики: data mining, data science, machine learning, predictive maintenance, python, машинное обучение, прототипирование, Сибур, хакатон, ХакатоныПостановка Data Science задач и взаимодействие с бизнесом
2018-05-23 в 8:39, admin, рубрики: big data, data mining, data science, python, Блог компании ID Finance, машинное обучение
Привет. В этот раз снова о Data Science. Думаю, многим знакома методология CRISP-DM, о которой говорят на большинстве курсов, но вот про первый пункт (business understanding) информации достаточно мало, в зря, ведь он очень важный.
Поэтому в этой статье мы поговорим о взаимодействии с бизнесом и о том, какие обычно бывают проблемы и сложности в этом вопросе. Давайте разберем все на примере.Читать полностью »
Просто добавь воды: разработка с H2O.ai
2018-05-23 в 7:46, admin, рубрики: AI, Apache Spark, azure, azure iot, data science, DSVM, h2o, machine learning, microsoft, Microsoft Azure, python, R, spark, Блог компании Microsoft, ИИ, искусственный интеллект, машинное обучение, Питон, Разработка для интернета вещейПривет! В течение последних нескольких лет интерес к технологиям машинного обучения и искусственного интеллекта быстро рос. Решение H2O.ai становится все более популярным в этой сфере: оно поддерживает быстрые алгоритмы машинного обучения в оперативной памяти и недавно получило поддержку глубокого обучения. Сегодня поговорим о разработке с использованием H2O.
Обработка текстов на естественных языках
2018-05-18 в 7:31, admin, рубрики: data mining, data science, machine learning, natural language processing, nlp, Блог компании Mail.Ru Group, машинное обучение, Семантический анализ текста
Сегодня мы затрагиваем такую интересную тему, как естественные языки. Сейчас в эту область вкладываются очень большие деньги и в ней решают немало разнообразных задач. Она привлекает внимание не только индустрии, но и научного сообщества.
Читать полностью »
AI.Hack Санкт-Петербург
2018-05-10 в 11:04, admin, рубрики: data science, академический университет, анализ данных, Блог компании СПБАУ, кейс, машинное обучение, открытые данные, СПбАУ, ХакатоныПривет! В этом посте расскажу вам про один из самых классных хакатонов с DS-треком, проходившем недавно в Питере. Под катом — общий обзор, кейсы, которые мы решали, и, конечно, о том, как сразу обе команды АУ смогли стать победителями.

Муниципальные мойры или Что влияет на карьеру чиновника
2018-05-01 в 19:59, admin, рубрики: data science, академический университет, анализ данных, Блог компании СПБАУ, кейс, машинное обучение, открытые данные, ХакатоныПривет! Как и было обещано в предыдущем посте про Why So Serious Hack, мы подготовили следующий рассказ в этой серии. В этот раз речь пойдет про хакатон «Муниципальные мойры», который проводился 21-22 апреля Европейским университетом в Санкт-Петербурге.

Управление проектами машинного обучения с высокой ценой ошибки. Лекция в Яндексе
2018-04-29 в 13:42, admin, рубрики: data science, Блог компании Яндекс, машинное обучение, нейронные сети, работа с заказчиком, управление проектамиМодели машинного обучения нужно уметь не только разрабатывать, но и «продавать» заказчику. Если у него не будет понимания, почему предлагается именно такое решение, то всё закончится статьёй в журнале и выступлением на конференции. Директор компании Loginom Алексей Арустамов обращает внимание на ключевые моменты, которые важно отразить в описании модели. Это выступление прошло пару недель назад на конференции Яндекса из серии «Data & Science».
Если у вас цена ошибки маленькая, то вообще все равно, что там интерпретировать. Дали вы не ту рекомендацию — ну и бог с ней. В поиске что-то вывели — ну и ничего страшного. Но все меняется, когда речь идет о вещах, связанных с большими издержками, где цена ошибки очень большая. И тогда люди не очень любят доверять черному ящику. Это просто здравый смысл.
Mail.Ru Group на пятом московском Data Fest
2018-04-27 в 12:08, admin, рубрики: big data, data fest, data mining, data science, machine learning, mail.ru, mail.ru group, Блог компании Mail.Ru Group, визуализация данных, машинное обучение
Друзья, до самого долгожданного события года в сфере data science остался 1 день! 28 апреля состоится пятый московский Data Fest. Под катом наш рассказ о докладах и активностях Mail.Ru Group на конференции.
Читать полностью »
Как мы участвовали в хакатоне от OpenData
2018-04-23 в 16:41, admin, рубрики: data science, Linked data, open data, академический университет, анализ данных, Блог компании СПБАУ, кейс, машинное обучение, открытые данные, ХакатоныВсем привет, в этой статье я хочу рассказать про Why So Serious Hack. Про то, что вообще нас туда привело, чем хакатоны в классическом понимании отличаются от хакатонов с контестом и что нам помогло выиграть.
Самые страшные ошибки, которые допускают DS. Встреча в офисе Авито 24 апреля
2018-04-20 в 11:22, admin, рубрики: AI Community, data science, machine learning, Блог компании Avito, веб-аналитика, математика, машинное обучение, Учебный процесс в ITПривет! На следующей неделе, в среду, 24 апреля, приглашаем специалистов по Data Science на митап, который мы организуем вместе с AI Community и AI Today. Будем говорить о самых страшных ошибках, которые допускают DS. Подробно обсудим CRISP-DM и Tips&Tricks, которые можно использовать в работе. Вы услышите доклады Ивана Гуза, Игоря Слинько и Станислава Гафарова. Регистрируйтесь на встречу и приглашайте коллег. Под катом — тезисы выступлений, ссылки на регистрацию и видеотрансляцию митапа.