Рубрика «data science» - 32

image

Друзья, приглашаем вас на пятый московский Data Fest, который состоится 28 апреля на территории дизайн-завода FLACON. Data Fest — крупнейшая бесплатная конференция для исследователей, инженеров и разработчиков, связанных с анализом и обработкой данных, машинным обучением, а также тем, что пресса любит называть AI.

Вы узнаете про AI в продуктах Mail.Ru Group и «умные» ответы в Почте Mail.Ru, как работают рекомендации и компьютерное зрение во ВКонтакте и Одноклассниках, а также машинный перевод в Alibaba и что такое Quantum Machine Learning, а также многое-многое другое!
Читать полностью »
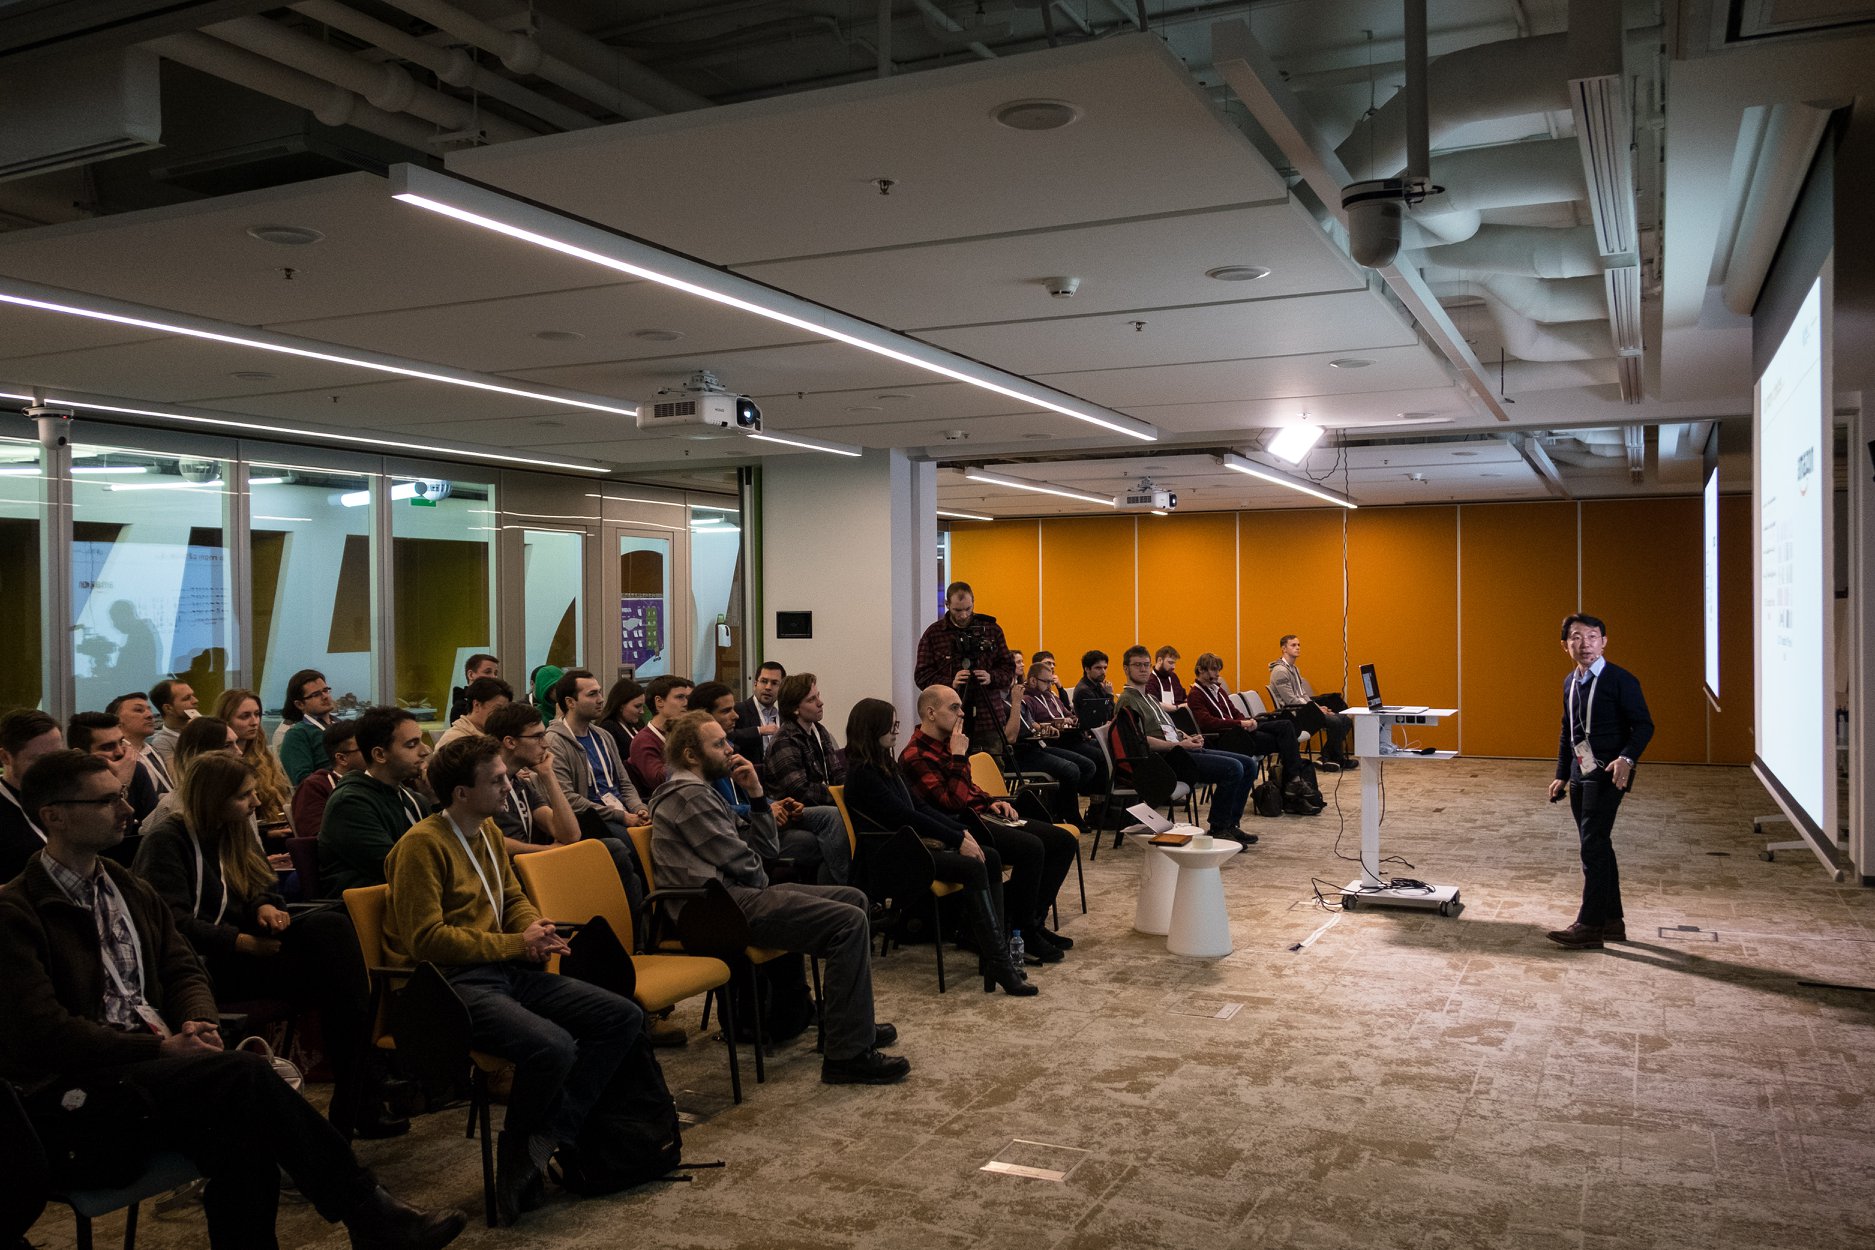
Всем привет! Публикуем отчёт с митапа Avito Data Science Meetup: Personalization, который проходил у нас в офисе. Участники обсуждали моделирование пользовательских предпочтений в мультимодальных данных и кластеризацию волатильных объявлений с помощью EM-алгоритма. Под катом — видеозаписи, презентации, ссылка на фотоотчёт.

Персонализируй это. Отчёт с Avito Data Science Meetup: Personalization - 1

Читать полностью »

Я уже делился рассказом о нашем опыте применения искусственного интеллекта в поиске на hh.ru, а сегодня хотел бы остановиться на измерении качества этого поиска поподробнее.
Как в hh.ru тестируют поиск по вакансиям - 1
Для нормальной работы поиска крайне важна система метрик — локальных, A/B-тестов, очередей на проде и т. д., и эта система требует отдельного внимания и ресурсов. Неправильно думать, что достаточно просто запилить крутой ML и прикрутить все эти метрики «скотчем»; недостаточно также измерять качество работы уже работающей системы — не так уж важно, использует ли она ML или представляет собой Lucene «из коробки». Читать полностью »

Меня зовут Иван Серов, я работаю в департаменте Data Science финтех-компании ID Finance. Data scientist –довольно молодая, но очень востребованная профессия, которая обросла множеством мифов. В этом посте я расскажу о нескольких заблуждениях, с которыми сталкиваются начинающие дата-саентисты (DS).

Пять мифов о Data Science - 1
Читать полностью »

В этой статье я бы хотел обсудить базовые принципы построения практического проекта по (т. н. «интеллектуальному») анализу данных, а также зафиксировать необходимую терминологию, в том числе русскоязычную.

Согласно википедии,

Анализ данных — это область математики и информатики, занимающаяся построением и исследованием наиболее общих математических методов и вычислительных алгоритмов извлечения знаний из экспериментальных (в широком смысле) данных; процесс исследования, фильтрации, преобразования и моделирования данных с целью извлечения полезной информации и принятия решений.

Говоря чуть более простым языком, я бы предложил понимать под анализом данных совокупность методов и приложений, связанных с алгоритмами обработки данных и не имеющих четко зафиксированного ответа на каждый входящий объект. Это будет отличать их от классических алгоритмов, например реализующих сортировку или словарь. Читать полностью »

У нас было 2 виртуальные машины, 75 сайтов, тысячи метрик, две базы данных и одна очередь ActiveMQ, Python и целое множество библиотек всех сортов и расцветок, pandas, а также numpy, dash, flask, SQL Alchemy. Не то чтобы это был необходимый запас для системы, но если начал собирать компоненты, становится трудно остановиться. Единственное, что вызывало у меня опасение — это JavaScript. Ничто в мире не бывает более беспомощным, безответственным и порочным, чем JS зомби. Я знал, что рано или поздно мы перейдем и на эту дрянь.

image
Читать полностью »

Рубрика «Читаем статьи за вас». Февраль — Март 2018 - 1

Привет! Продолжаем публиковать рецензии на научные статьи от членов сообщества Open Data Science из канала #article_essense. Хотите получать их раньше всех — вступайте в сообщество!

Читать полностью »

Рубрика «Читаем статьи за вас». Декабрь 2017 — Январь 2018 - 1

Привет! Продолжаем публиковать рецензии на научные статьи от членов сообщества Open Data Science из канала #article_essense. Хотите получать их раньше всех — вступайте в сообщество!

Читать полностью »

Пойди туда, не знаю куда: по следам конференции SmartData - 1

Конференций, связанных с AI / ML / data science в последнее время и у нас стало довольно много. Организаторы до сих пор ищут форматы, концепции конференций меняются, но состав спикеров повторяется процентов на 50.

Задача поиска формата стояла и перед программным комитетом SmartData. Задача эта довольно размытая. Кто тот человек, который занимается анализом и / или обработкой данных, что ему интересно? От участников конференции мы получили частичные ответы на эти вопросы, но данных хочется больше. В связи с этим хочу поделиться тем представлением об идеальном мире, которое сложилось на данный момент, и пригласить читателей к дискуссии в комментариях. Помогите сделать такую конференцию, на которую вам потом самим захочется сходить.

Кроме вопросов о ваших интересах и задачах, за кликом вас ждут две ранее не публиковавшиеся видеозаписи выступлений с первой конференции, технический приём написания текстов на Хабр и один забавный факт о беспилотных автомобилях.
Читать полностью »

Всем привет!

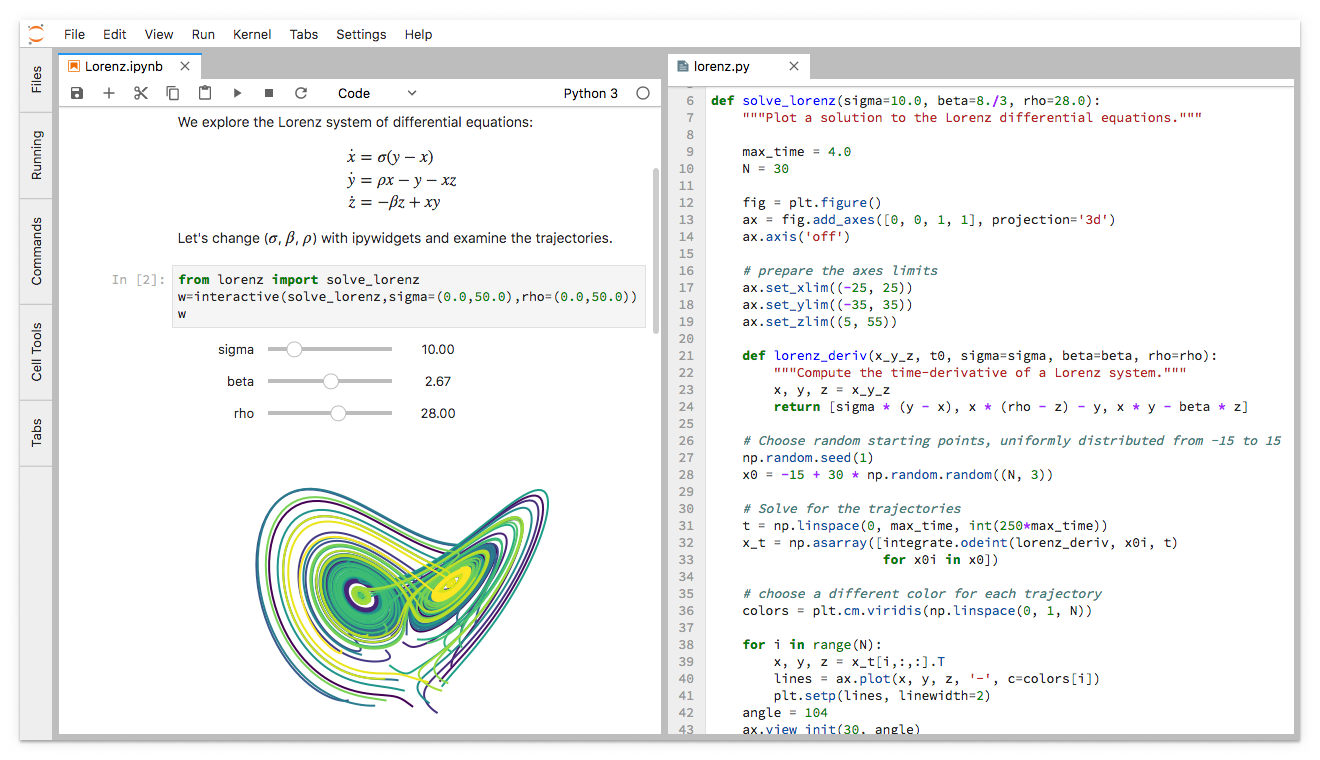
Одним из основных инструментов на нашем курсе «Разработчик BigData» является Jupyter. Глянем, что его разработчики приготовили в новой итерации и что уже доступно в бета-версии.

Поехали.

Вкратце: JupyterLab готов к ежедневному использованию (установка, документация, экскурс через Binder)

JupyterLab — это интерактивная среда разработки для работы с блокнотами, кодом и данными.

Что есть в новом JupyterLab для пользователей? - 1
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js