
Сценарий знакомый: открываешь в pandas файл побольше, ноутбук задумывается, вентилятор набирает обороты, и через минуту всё падает с MemoryError. Следом обычно приходит совет от старших коллег или из интернета: pandas для маленьких данных, для больших есть Spark. Мне захотелось проверить этот совет цифрами. Не на кластере в облаке, где Spark чувствует себя как дома, а на машине, которая больше похожа на рабочий ноутбук аналитика.
Рубрика «DuckDB»
«Переходи на Spark», говорили они. Сравнил pandas, Polars, DuckDB и PySpark на слабой машине
2026-09-28 в 8:09, admin, рубрики: DuckDB, pandas, parquet, polars, pyspark, python, анализ данных, обработка данных, производительностьКак фильтры Блума в 10 раз ускорили SQLite
2025-02-28 в 13:01, admin, рубрики: B-дерево, DuckDB, ruvds_перевод, sqlite, star schema benchmark, базы данных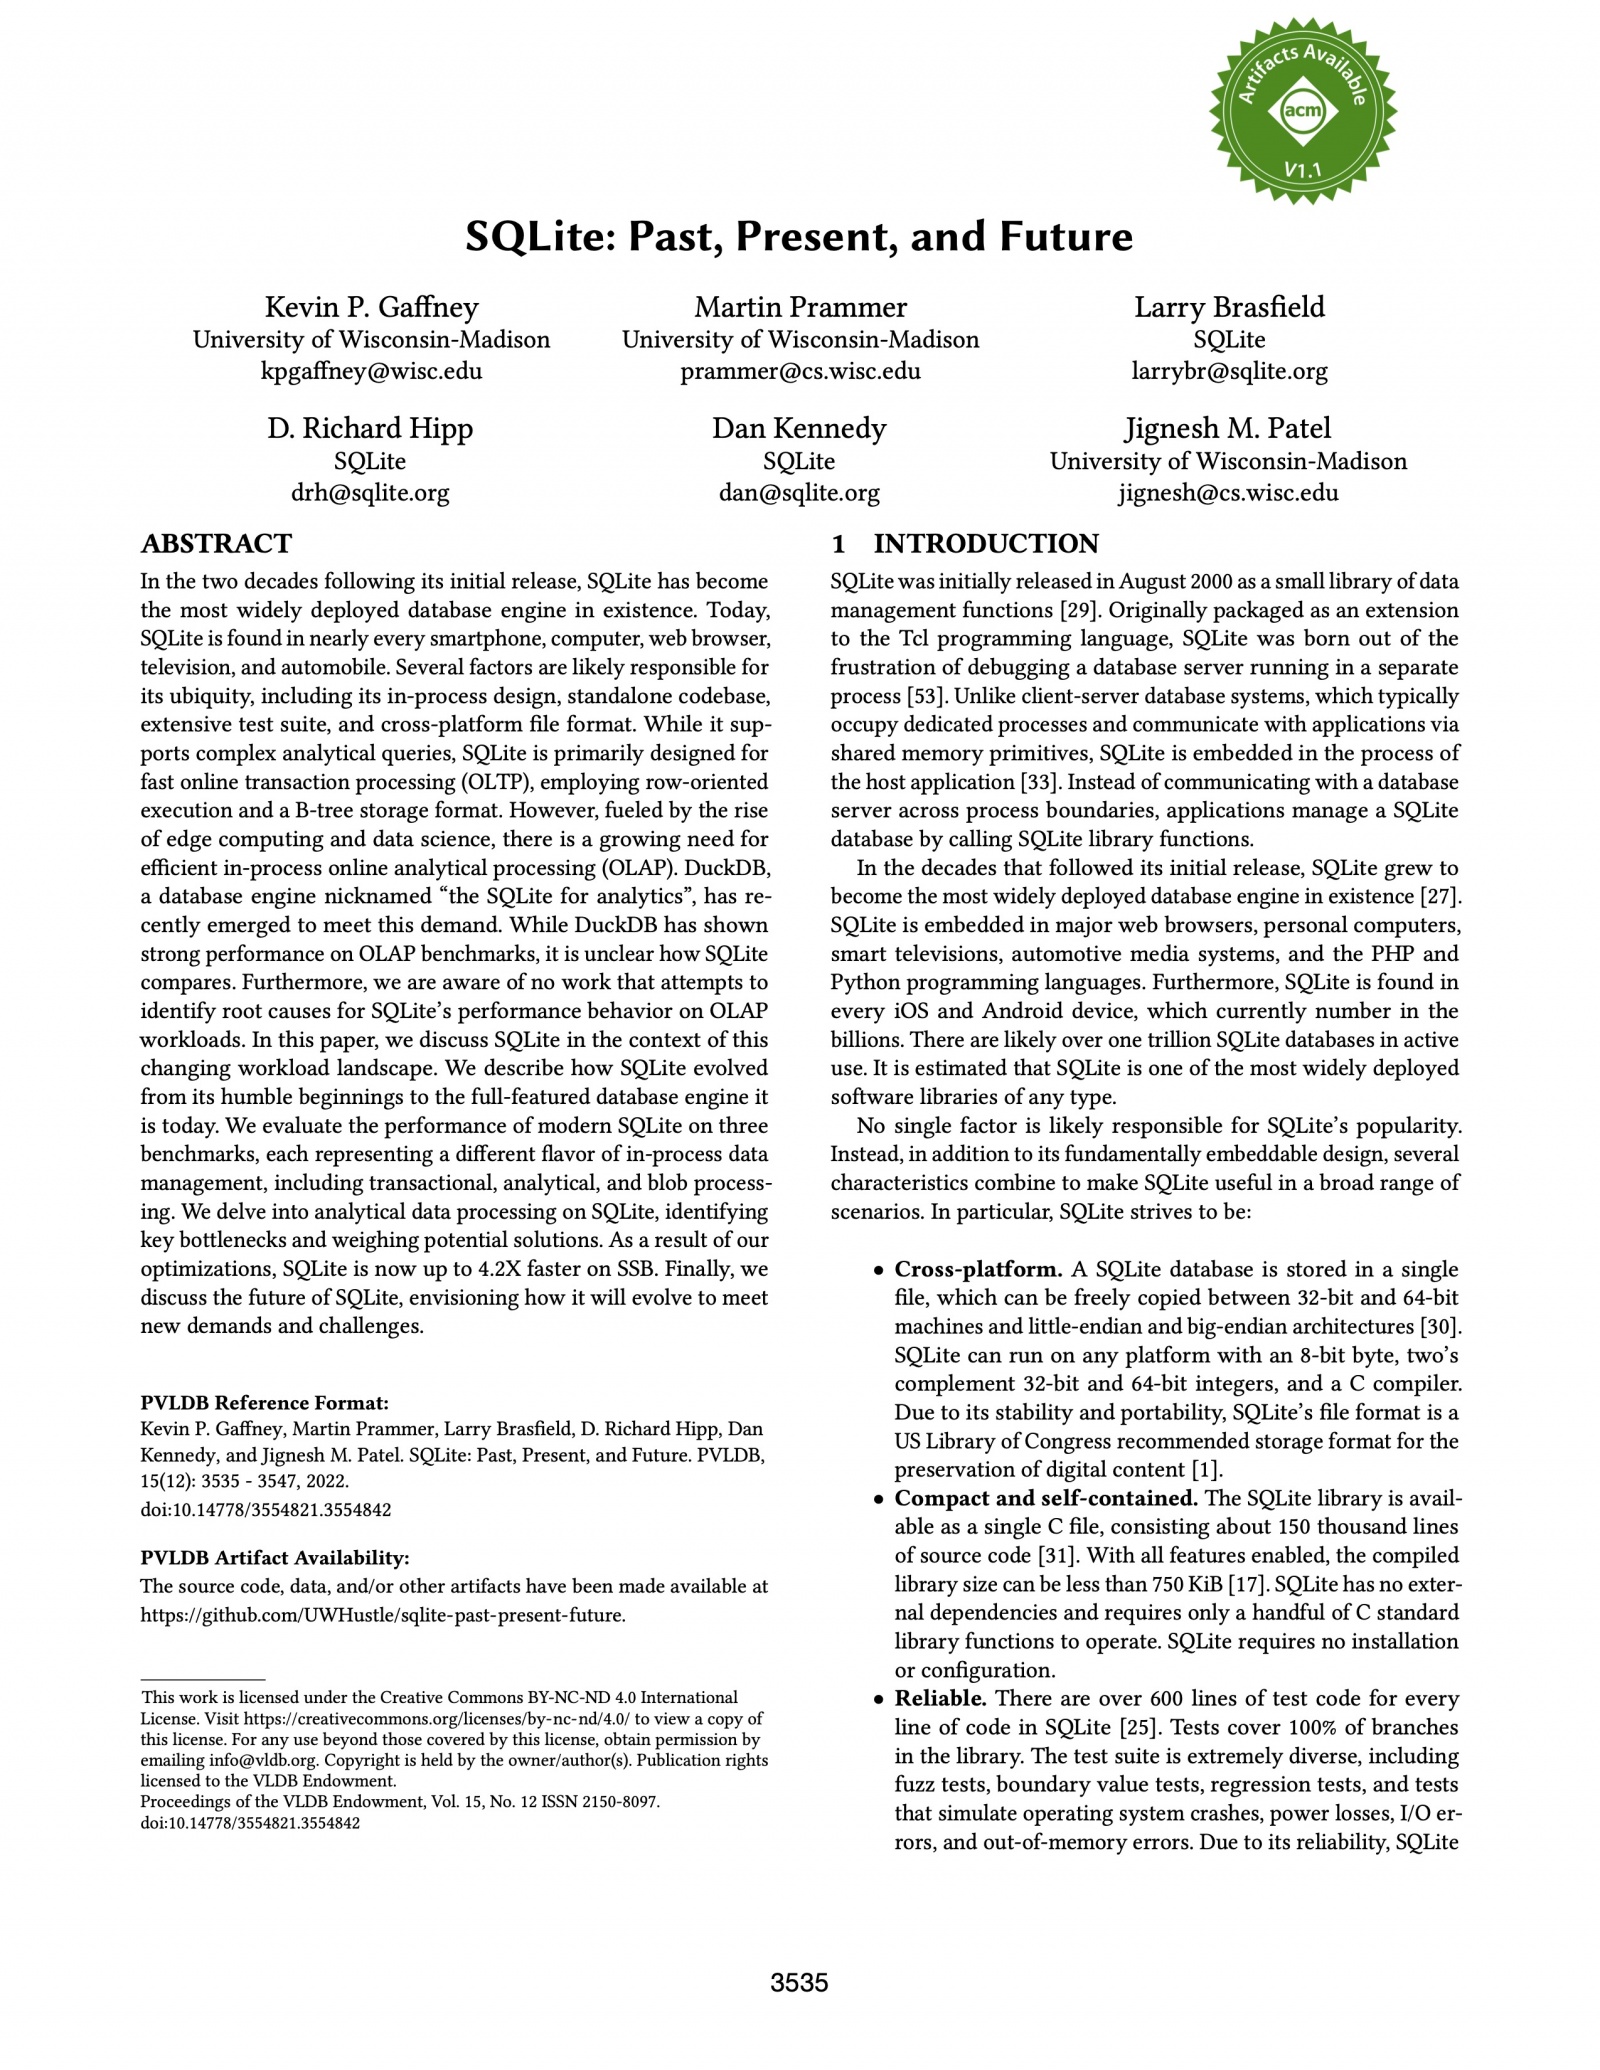
Это интригующая история о том, как исследователи с помощью грамотного использования фильтров Блума смогли в 10 раз ускорить аналитические запросы в SQLite. Ниже я приведу свой краткий обзор работы «SQLite: Past, Present, and Future (2022)», и объясню некоторые внутренние особенности баз данных, включая механизм реализации соединений.Читать полностью »
Почему СУБД такие медленные
2024-10-21 в 9:01, admin, рубрики: cassandra, CedarDB, DuckDB, dynamodb, imdb, LeanStore, mongodb, mysql, NVMe, OrioleDB, pcie, postgresql, PostgreSQL 17, redis, ruvds_статьи, SATA, spdk, sqlite, ssd, TPC-DS, TPC-H, UmbraDB, Valkey, резидентная БД, соединение хеш-таблиц, структуры данных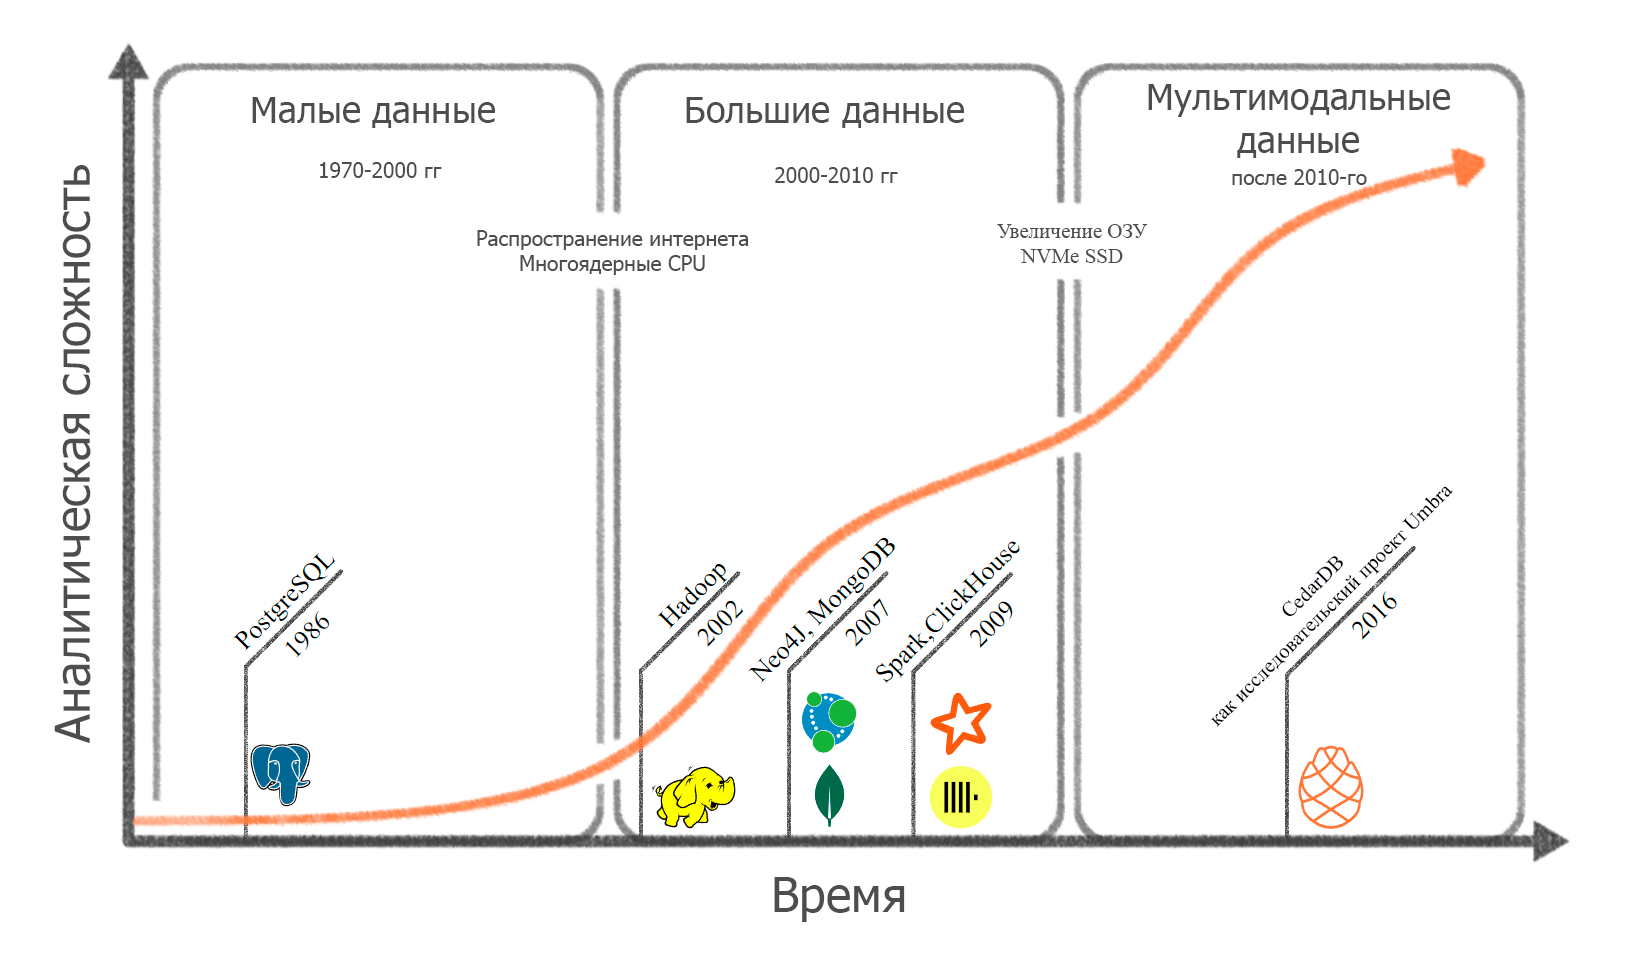
Недавно на Хабре публиковался перевод статьи «Просто выберите Postgres» (оригинал, англ. яз) с аргументами, что Postgres — оптимальная БД для десктопных и мобильных приложений. Аналогичное мнение высказывают в других популярных статьях вроде «До свидания MongoDB, здравствуй PostgreSQL». Главным недостатком SQLite называют то, что данные хранятся в одном файле, а MongoDB (а также DynamoDB и Cassandra) — низкую производительность:
«Всё это связано с тем, что подобные базы данных, по сути, представляют собой огромную распределённую хеш-таблицу. Единственные операции, работающие без необходимости сканирования всей базы данных — это поиск по секционному ключу и сканы, при которых используется ключ сортировки.
…Если паттерны доступа существенно изменятся, то может потребоваться полная повторная обработка всех данных».
Более производительные резидентные БД хранят данные в памяти (Redis, Valkey), но их использование ограничено объёмом ОЗУ.
После такого заявления интересно посмотреть на независимые тесты производительности разных СУБД.Читать полностью »
Я написал одну из самых быстрых библиотек датафреймов
2023-05-26 в 14:01, admin, рубрики: CockroachDB, Decode, DuckDB, execute, fetch, Groupby, mysql, postgresql, python, Rust, simd, timeweb_статьи_перевод, Блог компании Timeweb Cloud, Программирование, СУБД
❯ 1. Вступление
У меня в портфолио есть несколько готовых пет-проектов на Rust, и я заметил, что позиция «а у нас уже получилась DataFrame?» нисколько меня не устраивает. Поэтому я подумал, не сделать ли мне элементарный контейнер, который решал бы мою конкретную задачу. Но этот проект вышел из-под контроля.
Год спустя, написав немало кода, я создал одну из самых быстрых библиотек датафреймов, применимую в Rust и Python. Вот мой первый официальный «Hello World» на polars, размещённый у меня в блоге. Надеюсь, что с помощью этого поста я смогу пояснить читателю некоторые решения, которые мне довелось принять при проектировании, и вам станет понятнее, как Polars работает под капотом.
Читать полностью »