Рубрика «github» - 33

Рецепт полезного код-ревью от разработчика из Яндекса - 1

Привет. Меня зовут Сергей, последние пять лет я работаю в Яндексе. За это время участвовал в разработке одиннадцати проектов. Писал код на JavaScript, Python и C++. Некоторые проекты делал в одиночку, другие разрабатывал в группе из восьми человек. Но в каждой команде, на всех проектах, вне зависимости от языка программирования я использовал код-ревью.

С помощью код-ревью я постоянно узнаю что-то новое. Иногда, глядя на чужой код, хочется воскликнуть: "А что, так тоже можно?". В чужом коде я нахожу интересные приёмы и беру их себе на вооружение. Много новых знаний черпаю из комментариев к моему коду. Для меня стало открытием, что люди любят делиться своим опытом. Даже когда я разрабатываю проект в одиночку, то прошу ребят из другой команды посмотреть мои пулреквесты. Это мотивирует писать красивый и понятный код.

Но так было не всегда. Когда-то ревью было для меня наказанием. Я мог неделю с вдохновением писать код, вкладывая в него все силы. Отправлял пулреквест, трижды пинговал ревьювера, а в ответ получал сухое "вроде ок" или, что ещё хуже, десятки комментариев не по существу.

Мне на ревью приходили пулы из пяти тысяч строк. Я часами пытался разобраться в коде, по сотне раз скроллил от функции к тесту и обратно. Писал десятки бесполезных комментариев о пропущенной точке с запятой. Всё это жутко меня раздражало. Часто откладывал ревью на потом, и у меня накапливались десятки непросмотренных пулов.

Если вы чувствовали это на себе, значит, статья для вас. Сегодня я расскажу о приёмах и инструментах, которые использую каждый день на протяжении пяти лет ежедневного код-ревью.
Читать полностью »

T2F: проект преобразования текста в рисунок лица при помощи глубинного обучения - 1

Код проекта доступен в репозитории

Введение

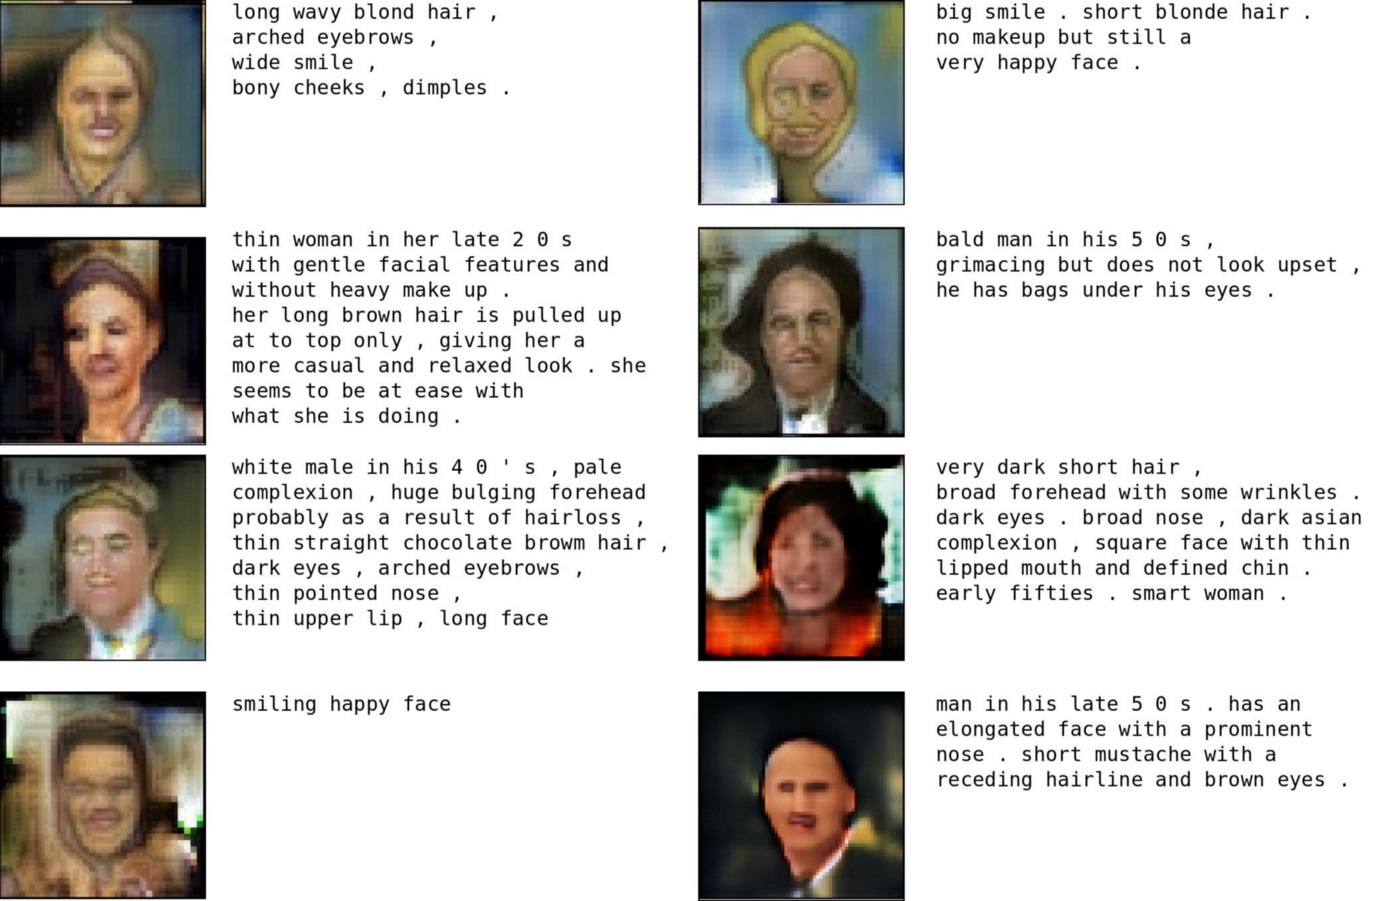
Когда я читал описания внешнего вида персонажей в книгах, мне всегда было интересно, как бы они выглядели в жизни. Вполне можно представить себе человека в целом, но описание наиболее заметных деталей – задача сложная, и результаты разнятся от человека к человеку. Много раз у меня не получалось представить себе ничего, кроме весьма размытого лица у персонажа до самого конца произведения. Только когда книгу превращают в фильм, размытое лицо заполняется деталями. К примеру, я никогда не мог представить себе, как именно выглядит лицо Рэйчел из книжки "Девушка в поезде". Но когда вышел фильм, я смог сопоставить лицо Эмили Блант с персонажем Рэйчел. Наверняка у людей, занимающихся подбором актёров, уходит много времени на то, чтобы правильно изобразить персонажей сценария.
Читать полностью »

Эта статья — продолжение статьи про организацию процессов Continuous Integration / Continuous Delivery, автоматизирующих сборку, тестирование и доставку приложений применимо к решениям на платформе InterSystems.

Рассмотрим такие темы как:

  • Контейнеры 101
  • Контейнеры на разных этапах цикла разработки ПО
  • Continuous Delivery с контейнерамиЧитать полностью »

Всем привет!

Однажды меня спросили заказчики, нет ли у меня в проектах целочисленного БПФ, на что я всегда отвечал, что это уже сделано другими в виде готовых, хоть и кривых, но бесплатных IP-ядер (Altera / Xilinx) – берите и пользуйтесь. Однако, эти ядра не оптимальны, обладают набором «особенностей» и требуют дальнейшей доработки. В связи с чем, уйдя в очередной плановый отпуск, который не хотелось провести бездарно, я занялся реализацией конфигурируемого ядра целочисленного БПФ.

Реализация целочисленного БПФ на ПЛИС - 1
КДПВ (процесс отдладки ошибки переполнения данных)

В статье я хочу рассказать, какими способами и средствами реализуются математические операции при вычислении быстрого преобразования Фурье в целочисленном формате на современных кристаллах ПЛИС. Основу любого БПФ представляет узел, который носит название «бабочка». В бабочке реализуются математические действия – сложение, умножение и вычитание. Именно о реализации «бабочки» и её законченных узлов будет идти рассказ в первую очередь. За основу взяты современные семейства ПЛИС фирмы Xilinx – это серия Ultrascale и Ultrascale+, а также затрагиваются старшие серии 6- (Virtex) и 7- (Artix, Kintex, Virtex). Более старшие серии в современных проектах – не представляют интереса в 2018 году. Цель статьи – раскрыть трудности и особенности реализации кастомных ядер цифровой обработки сигналов на примере БПФ.
Читать полностью »

Разработчики из GitHub на прошлой неделе выложили в открытый доступ исходники своего балансировщика нагрузки — GLB Director. Команда трудилась над этим проектом несколько лет.

Чем примечательно их решение, как оно устроено, и кто еще передавал системы распределения нагрузки в open source, рассказываем далее.

GitHub открыли код своего балансировщика нагрузки — как работает их решение - 1Читать полностью »

image

Часто бывает так, что у разработчика со-временем накапливается некоторая коллекция кода который он использует в своих проектах.

Одни скрипты он использует в одних проектах, другие в других.

Эти скрипты со-временем совершенствуются, убираются баги, оптимизируются. Поэтому появляется вопрос, как синхронизировать новые версии скриптов с теми, которые в проектах.

Тут есть несколько вариантов:

Первый вариант:

Создать один репозиторий и поместить туда все скрипты. Затем этот репозиторий подключается как подмодуль к проекту и используется.

Минусы:

  1. в проект копируются все скрипты включая ненужные.
  2. подмодуль не commit-ится в репозиторий проекта, поэтому если будет недоступен удаленный репозиторий подмодуля, то мы не сможет выкачать проект целиком.

Второй вариант:

Каждый скрипт отдельно хранить на Github gist и подключать нужные как подмодули
Минус тот-же, что и в первом варианте во втором пункте.

Третий вариант:

Использовать Git Subtree.

(Данное решение является альтернативой для Git submodules)
Читать полностью »

Юля: Так, кто вчера менял мою процедуру?
Лёша: не я
Максим: не я
— Ребят, может Git заведём ?
Серёжа: давно пора!
прошло 2 недели…

Юля: ребяяят?
— Юль, а ты не коммитила?
Юля: damn нет(…

Вот так всё и началось. Ну а что, каждый символ и каждую строчку коммитить?

А может всё это будет происходить само?) На этом моменте в голову начинают приходить
DDL-триггеры, Temporal table и картина складывается. Решено, будем хранить версии внутри
SQL Server'a !)

Контроль версий внутри SQL Server'a - 1

Читать полностью »

Если очень кратко — это перевод на русский проекта The Super Tiny Compiler — проекта призванного помочь с изучением основ компилирования на рабочем примере.

image

Если хотите подробностей — прошу под кат. Если же нет — можно идти напрямую к переводу, он на гитхабе.
Читать полностью »

Сегодня Mislav Marohnić объявил о том, что разработчики Github избавились от jQuery на фронтенде GitHub.com. Казалось бы, в самом этом факте нет ничего примечательного, если бы не один интересный момент.

Проблема выбора нового фреймворка для фронтенда была решена радикально — решено было обойтись без фреймворков в принципе. Вместо них были использованы следующие средства:

  • querySelectorAll (который предположительно был вдохновлен когда-то именно jQuery),
  • fetch для работы с AJAX,
  • delegated-events для обработки событий,
  • полифиллы для работы с DOM,
  • пользовательские элементы (Custom Elements), которые сейчас на подъеме.

Помимо Custom Elements, ничего другого из Web Components было решено не использовать. Разработчики присматривались к Shadow DOM и были бы не против прибегнуть к нему — однако, в силу того, что на полифиллах скорость поиска в DOM оставляет желать лучшего, им пришлось пока отложить эту затею.

Зачем разработчикам в принципе потребовалось все это сделать? По их словам, для того, чтобы «отдавать» посетителям меньше килобайт, иметь возможность использовать более явно выраженный синтаксис для выполнения манипуляций с DOM, а также ради возможности использовать библиотеку Flow.JS для статического анализа типов. По словам разработчиков, процесс ухода с jQuery занял годы.
Читать полностью »

Аннотация

Итак, мои коллеги-ученые, не спрашивайте, что вы можете сделать для воспроизводимости — спросите, что воспроизводимость может сделать для вас!

Здесь я перечислю пять причин, по которым возможность воспроизводимости данных окупается в долгосрочной перспективе и представляет личный интерес для каждого амбициозного, ориентированного на карьеру ученого.


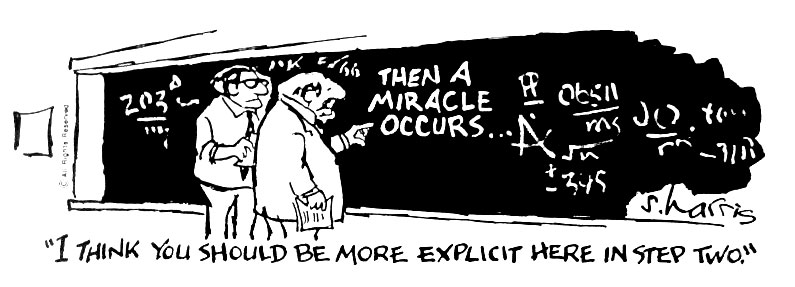
Сложное уравнение в левой половине черной доски, еще более сложное уравнение — в правой. Краткое предложение связывает два уравнения: «Здесь происходит чудо». Два математика, в глубоких раздумьях. «Я думаю, Вы должны быть более конкретны на втором шаге», — говорит один другому.
image

Примерно так выглядит ситуация, когда вы пытаетесь понять, как автор перешел от большого и сложного набора данных к плотной статье с множеством сложных графиков. Без доступа к данным и аналитическому коду такой переход можно объяснить разве что чудом. А в науке не должно быть чудес.

Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js