В ноябре 2021 проходила конференция EMNLPЧитать полностью »
В ноябре 2021 проходила конференция EMNLPЧитать полностью »
Привет. Я последние пару лет играюсь с естественной речью на русском языке. Решил поделиться своим опытом по работе с поэзией. Будет две статьи: вот эта и про рифму (когда дойдут руки всё доделать).
Половина программистов, прочитав заголовок, скорее всего подумала, что задача очень простая: сравнить две маски. Но есть нюансы, которые сильно влияют на результат, и о них то я и расскажу.
Речь пойдёт о так называемом силлабо-тоническом стихосложенииЧитать полностью »
Во многих популярных курсах машинного и глубокого обучения вас научат классифицировать собак и кошек, предсказывать цены на недвижимость, покажут еще десятки задач, в которых машинное обучение, вроде как, отлично работает. Но вам расскажут намного меньше (или вообще ничего) о тех случаях, когда ML-модели не работают так, как ожидалось.
Частой проблемой в машинном обучении является неспособность ML-моделей корректно работать на большем разнообразии примеров, чем те, что встречались при обучении. Здесь идет речь не просто о других примерах (например, тестовых), а о других типахЧитать полностью »
Текст написан иностранным агентом – лицом, проживающим за пределами России (в Канаде)
За пару дней до Рождества на Хабре появился пост про транслитерацию польского языка кириллицейЧитать полностью »
Початково рыцер Еди, под вплывем Дартха Сидиоуса прешедл на цемна стронэ Моцы и прыял тытул „Дартх Вадер”.
Вы поняли что-то из предыдущего предложения? Это польский язык. Это не перевод, это польский язык как он есть, просто записаный кириллицей. Вчера, я случайно оказался на польском сайте, там всё было написано по польски, ничего не понятно, и мне вдруг стало любопытно, что если конвертировать польский текст в кириллицу, смогу ли я, внезапно, понимать его? Ну хоть на сколько-то понимать. Готового такого конвертера я нигде не нашел, ни на гитхабе ни в переводчиках типа Гугла. Пришлось написать самому.

После релиза нашей первой модели, расставляющей знаки препинания и большие буквы, было много пожеланий доработать её, чтобы она могла обрабатывать тексты целиком, а не отдельные предложения. Это коллективное пожелание и было осуществлено в нашей новой версии модели.
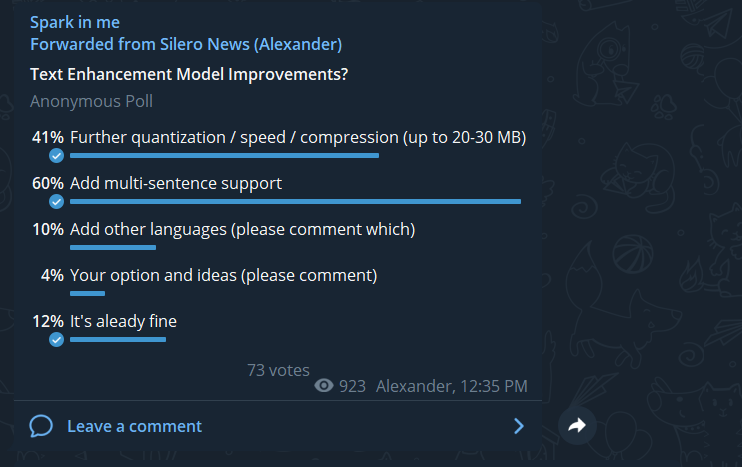
В целом, архитектура и датасеты остались прежними. Что изменилось:
NLI (natural language inference) – это задача автоматического определения логической связи между текстами. Обычно она формулируется так: для двух утверждений A и B надо выяснить, следует ли B из A. Эта задача сложная, потому что она требует хорошо понимать смысл текстов. Эта задача полезная, потому что "понимательную" способность модели можно эксплуатировать для прикладных задач типа классификации текстов. Иногда такая классификация неплохо работает даже без обучающей выборки!
До сих пор в открытом доступе не было нейросетей, специализированных на задаче NLI для русского языка, но теперь я обучил целых три: Читать полностью »
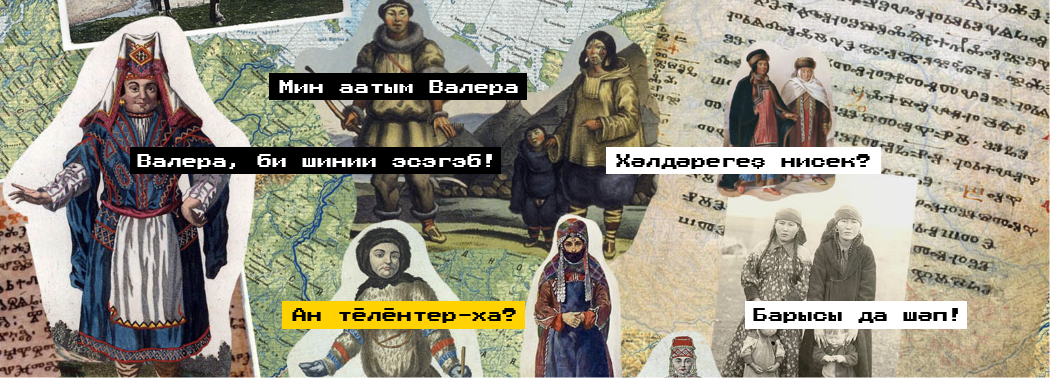
Сложный был год: налоги, катастрофы, бандитизм и стремительное исчезновение малых языков. С последним мириться было нельзя...
На территории России проживает большое количество народов, говорящих более чем на 270 языках. Около 150 языков насчитывает менее 1 тысячи носителей, а за последние 20 лет 7 языков уже исчезло.
Этот проект — мои "пять копеек" по поддержке языкового разнообразия. Его цель — помощь исследователям в области машинного перевода, лингвистам, а также энтузиастам, радеющим за свой родной язык. Помогать будем добыванием параллельных корпусов, — своеобразного "топлива", при помощи которого современные модели все успешнее пытаются понять человеческий язык.
Сегодняшние языки — башкирский и чувашский, с популяризаторами которых я в последнее время тесно общался. Сначала я покажу как в принципе извлечь корпус из двух текстов на разных языках. Затем мы столкнемся с тем, что на рассматриваемых языках предобученная модель не тренировалась и попробуем ее дообучить.
Экспериментировать мы будем в среде Colab'а, чтобы любой исследователь при желании смог повторить этот подход для своего языка.
Для выравнивания двух текстов я написал на python'е библиотеку lingtrain_aligner. Код у нее открыт. Она использует ряд предобученных моделей, можно подключать и свои. Одной из самых удачных мультиязыковых моделей сейчас является LaBSE. Она обучалась на 109 языках. Так как соотношение текстов смещено в сторону популярных языков, то для них качество эмбеддингов (эмбеддингом называют вектор чисел применительно к данным, которые он описывает) будет лучше.
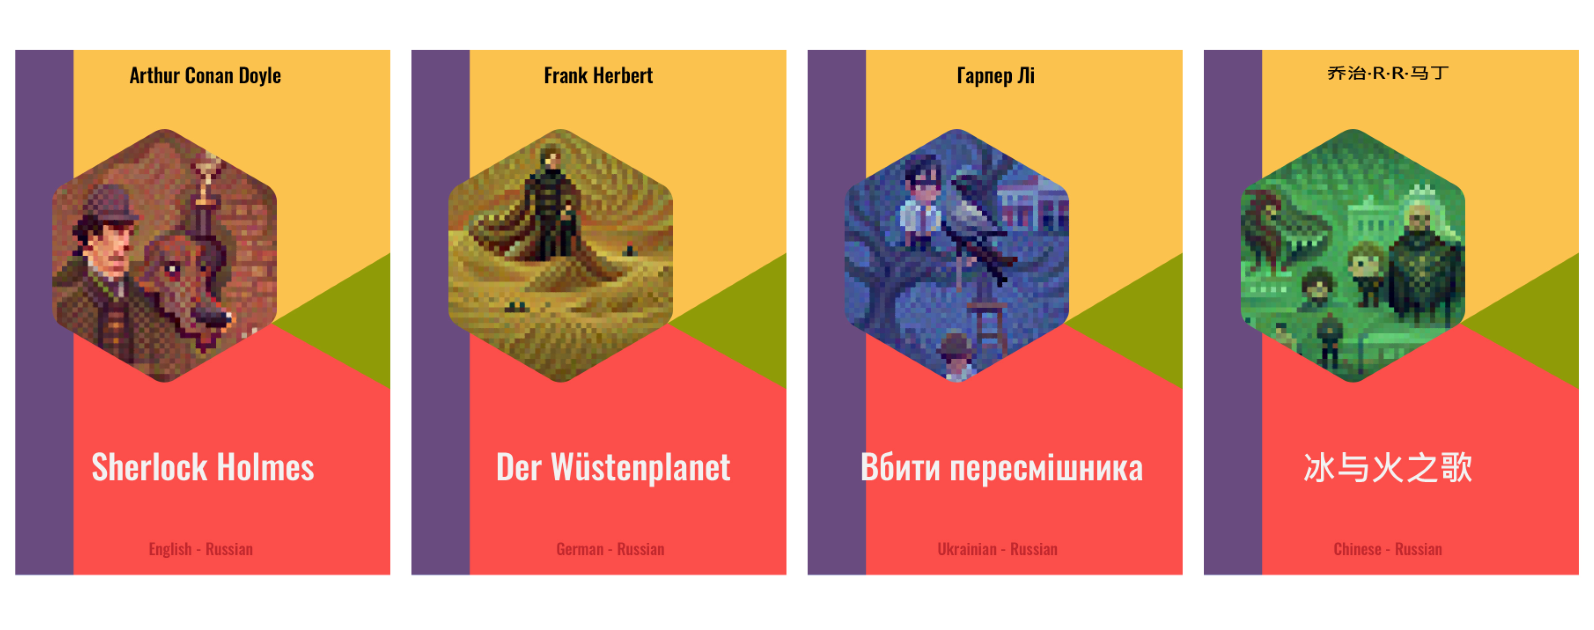
Статья будет интересна все любителям программирования, иностранных языков и красивых книг. Сначала мы сделаем параллельную книгу, имея на руках два обычных текста. Затем мы проиллюстрируем ее картинками в стиле pixel art на основе лишь текстовых подсказок.
Книгу можно сделать более чем на сотне языков с восстановлением и подсветкой связей между предложениями:
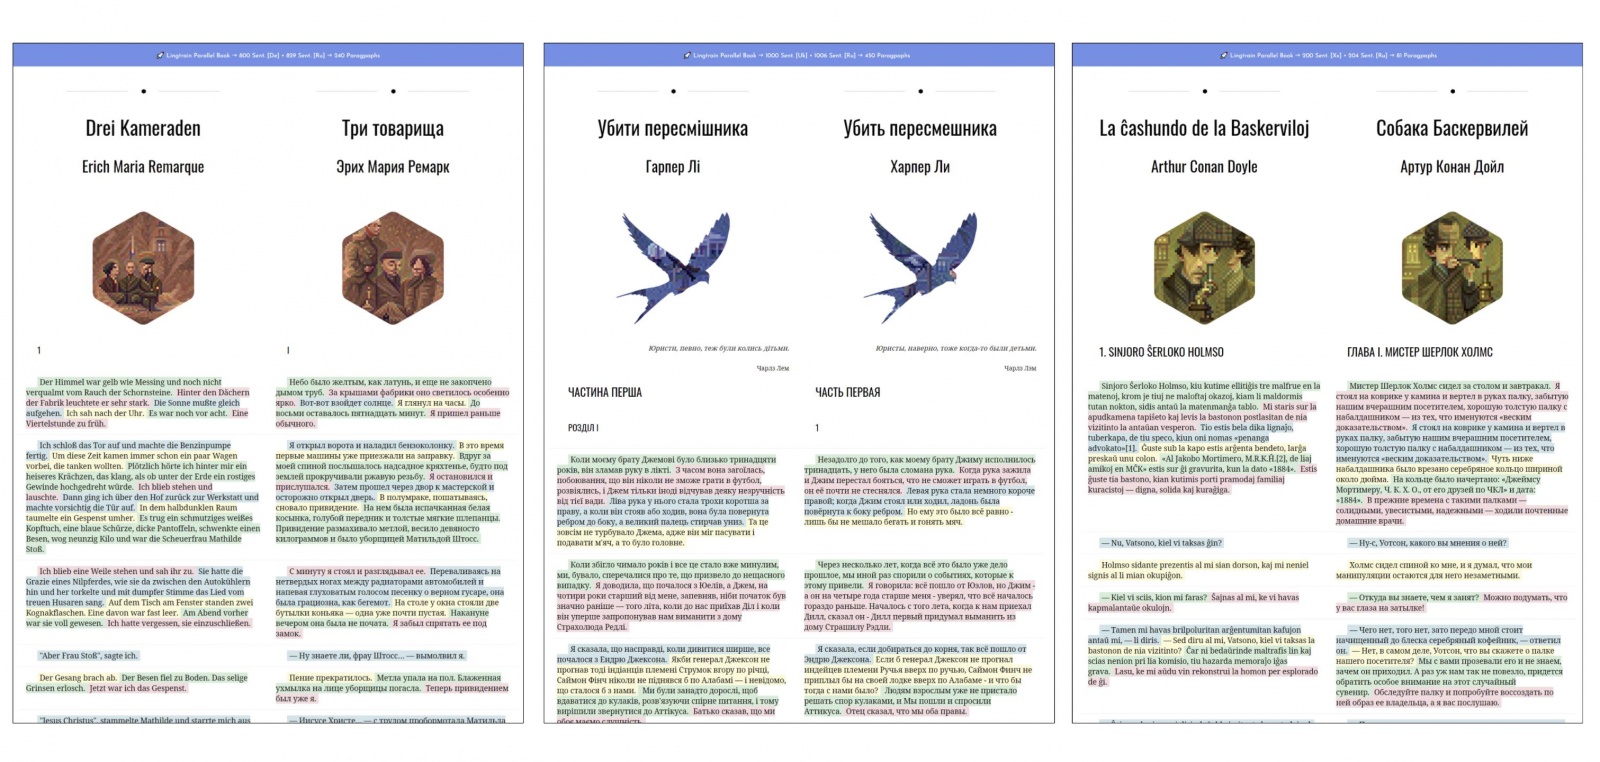
А теперь давайте сделаем такую книгу сами.