Рубрика «параллельное программирование» - 13

Бесплатная YouTube-трансляция Joker 2017: Java 9, Concurrency, GC, Spring и, конечно, паззлеры - 1

Круг замкнулся. Ровно год назад мы провели открытую трансляцию Joker 2016 для всех тех, у кого не было возможности зарегистрироваться. С тех пор мы провели более десятка трансляций с конференций по .NET, JavaScript, DevOps, мобильным технологиям, тестированию и Java, само собой.

Что стало лучше за год? Мы отработали технологию, пофиксили пару уязвимостей, начали транслировать через YouTube (а не через кастомный интерфейс), научились задавать вопросы от участников трансляции, забанили добрую сотню троллей, научились проводить интервью в перерывах без задержек и проволочек, начали делать трансляцию в 1440р… наверное, есть что-то еще.

Собственно, уже совсем скоро вы сможете увидеть, что у нас получилось — 3 ноября в 9:30 утра мы начнем двухдневную бесплатную трансляцию главного трека Joker 2017. Трансляция будет идти с одним перерывом «на сон». А еще она будет в разрешении 1440р, так что в кои-то веки вам понадобятся ваши крутые мониторы.

В программу вошли доклады Cay Horstmann, Алексея Шипилёва, Баруха jbaruch Садогурского, Тагира lany Валеева, Николая xpinjection Алименкова, Евгения EvgenyBorisov Борисова, Сергея Milfgard Абдульманова и еще кое-кого.

Интересно? Давайте под кат.
Читать полностью »
Глубокое обучение с R и Keras на примере Carvana Image Masking Challenge - 1

Привет!

Пользователи R долгое время были лишены возможности приобщиться к deep learning-у, оставаясь в рамках одного языка программирования. С выходом MXNet ситуация стала меняться, но своеобразная документация и частые изменения, ломающие обратную совместимость, все еще ограничивают популярность данной библиотеки.

Гораздо привлекательнее выглядит использование R-интерфейсов к TensorFlow и Keras с бекендами на выбор (TensorFlow, Theano, CNTK), подробной документацией и множеством примеров. В этом сообщении будет разобрано решение задачи сегментации изображений на примере соревнования Carvana Image Masking Challenge (победители), в котором требуется научиться отделять автомобили, сфотографированные с 16 разных ракурсов, от фона. "Нейросетевая" часть полностью реализована на Keras, за обработку изображений отвечает magick (интерфейс к ImageMagick), параллельная обработка обеспечивается parallel+doParallel+foreach (Windows) или parallel+doMC+foreach (Linux).

Читать полностью »

Привет! Я капитан команды СПбГУ, принимавшей участие в соревнованиях ASC. На прошлой неделе вышла статья stealapanda об опыте работы с мощнейшим суперкомпьютером мира Sunway Taihulight. Стало ясно, что многие впервые слышат о таком мероприятии. В своей статье я хочу рассказать в целом об HPC соревнованиях, как они проводятся и какие навыки пригодятся если вы захотите вписаться в эту увлекательную авантюру. Также на примере ASC опишу как это все проходит.

Что такое HPC соревнования и чем они отличаются от обычного спортивного программирования

Читать полностью »

Двое из ларца

Предисловие

Эта статья является продолжением цикла статей про асинхронность:

  1. Асинхронность: назад в будущее.
  2. Асинхронность 2: телепортация сквозь порталы.

Спустя 3 года я решил расширить и обобщить имеющийся спектр асинхронного взаимодействия с использованием сопрограмм. Помимо этих статей также рекомендуется ознакомиться с универсальным адаптером:

  1. Универсальный адаптер

Введение

Рассмотрим электрон. Что он из себя представляет? Отрицательно заряженная элементарная частица, лептон, обладающий некоторой массой. Это означает, что он может участвовать по меньшей мере в электромагнитных и гравитационных взаимодействиях.
Читать полностью »

Послевкусие от Kotlin, часть 3. Корутины — делим процессорное время - 1

Java позволяет писать последовательный, параллельный и асинхронный код. Асинхронный — это когда регистрируется callback, который запустится после какого-либо события (например, файл прочитан). Это позволяет избежать блокировки потока, но ломает последовательность выполнения, так что на java пишут такой код скорее когда нет других вариантов. Kotlin даёт решение — корутины, с ними асинхронный код выглядит почти так же, как последовательный.

По корутинам мало статей. Конкретных примеров, показывающих их преимущества — ещё меньше.

Что нашёл:

Последнее интересно — большинство enterprise приложений всё время что-нибудь ждут: БД, другие приложения, изредка и файл нужно прочесть. И всё это может быть полностью асинхронным, а значит всё приложение можно перевести на асинхронную обработку запросов.

Итак, посмотрим как ведут себя корутины под нагрузкой.
Читать полностью »

Это история о том, как мы замедляли ускоряли расчеты на самом мощном суперкомпьютере в мире.

Behind the scene of TOP-1 supercomputer - 1

Читать полностью »

TensorFlow — современная платформа глубокого обучения и машинного обучения, дающая возможность извлекать максимальную производительность из оборудования Intel. Эта статья познакомит сообщество разработчиков искусственного интеллекта (ИИ) с методиками оптимизации TensorFlow для платформ на базе процессоров Intel Xeon и Intel Xeon Phi. Эти методики были созданы в результате тесного сотрудничества между специалистами корпораций Intel и Google. Представители обеих корпораций объявили об этом сотрудничестве на первой конференции Intel AI Day в прошлом году.

Оптимизация TensorFlow на современных архитектурах Intel - 1
Читать полностью »

Продолжаем серию полезностей, которыми мы делимся с вами. Теперь уже вновь по Java.

Если вы уже знакомы со Stream API и использовали его, то знаете, что это удобный способ обработки данных. С помощью различных встроенных операций, таких как map, filter, sort и других можно преобразовать входящие данные и получить результат. До появления стримов разработчик был вынужден императивно описывать процесс обработки, то есть создавать цикл for по элементам, затем сравнивать, анализировать и сортировать при необходимости. Stream API позволяет декларативно описать, что требуется получить без необходимости описывать, как это делать. Чем-то это напоминает SQL при работе с базами данных.

Stream API & ForkJoinPool - 1

Стримы сделали Java-код компактнее и читаемее. Еще одной идеей при создании Stream API было предоставить разработчику простой способ распараллеливания задач, чтобы можно было получить выигрыш в производительности на многоядерных машинах. При этом нужно было избежать сложности, присущей многопоточному программированию. И это удалось сделать, в Stream API есть методы BaseStream::parallel и Collection.parallelStream(), которые возвращают параллельный стрим.
Читать полностью »

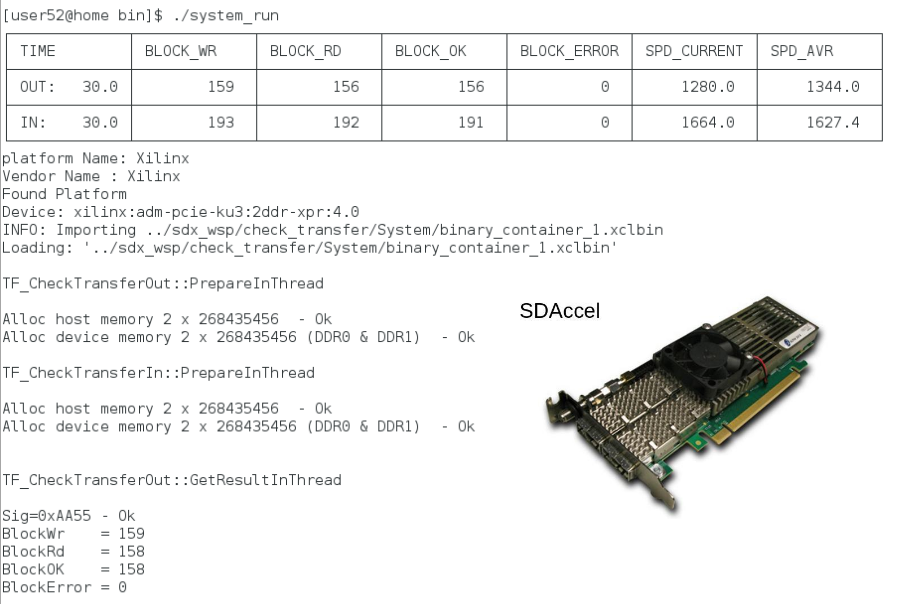
SDAccel — проверяем передачу данных - 1

В предыдущей статье «SDAccel – первое знакомство» я попытался описать основы применения OpenCL на ПЛИС Xilinx. Теперь настало время поделиться результатами экспериментов по передаче данных на модуле ADP-PCIe-KU3. Проверяется передача данных в обоих направлениях. Исходный код программ размещён на GitHub: https://github.com/dsmv/sdaccel

Читать полностью »

Около года назад наша команда переписала бэкенд одного малоизвестного приложения с 5 млн. пользователей с использованием «latency and fault tolerance» Hystrix. Это позволило значительно повысить надежность приложения при падении или задержках в нижестоящих системах (их около 10, что для серьезной системы не много), предоставило замечательный инструмент (Hystrix Dashboard) мониторинга нагрузки внешних систем (теперь мы знаем кто тормоз), позволило оптимизировать размеры различных пулов в приложении. Однако, осталась проблема длительной обработки отдельных тяжелых запросов, решению которой и посвящена эта статья.
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js