Рубрика «python» - 193

Первым делом, приступая к работе с новым набором данных, нужно понять его. Для того чтобы это сделать, нужно, например, выяснить диапазоны значений, принимаемых переменными, их типы, а также узнать о количестве пропущенных значений.

Библиотека pandas предоставляет нам множество полезных инструментов для выполнения разведочного анализа данных (Exploratory Data Analysis, EDA). Но, прежде чем воспользоваться ими, обычно нужно начать с функций более общего плана, таких как df.describe(). Правда, надо отметить, что возможности, предоставляемые подобными функциями, ограничены, а начальные этапы работы с любыми наборами данных при выполнении EDA очень часто сильно похожи друг на друга.
Ускорение разведочного анализа данных с использованием библиотеки pandas-profiling - 1

Автор материала, который мы сегодня публикуем, говорит, что он — не любитель выполнения повторяющихся действий. В результате он, в поисках средств, позволяющих быстро и эффективно выполнять разведочный анализ данных, нашёл библиотеку pandas-profiling. Результаты её работы выражаются не в виде неких отдельных показателей, а в форме довольно подробного HTML-отчёта, содержащего большую часть тех сведений об анализируемых данных, которые может понадобиться знать перед тем, как приступать к более плотной работе с ними.
Читать полностью »

Введение

Рассмотрим дискретное вейвлет – преобразования (DWT), реализованное в библиотеке PyWavelets PyWavelets 1.0.3. PyWavelets — это бесплатное программное обеспечение с открытым исходным кодом, выпущенное по лицензии MIT.

При обработке данных на компьютере может выполняться дискретизированная версия непрерывного вейвлет-преобразования, основы которого описаны в моей предыдущей статье. Однако, задание дискретных значений параметров (a,b) вейвлетов с произвольным шагом Δa и Δb требует большого числа вычислений.

Кроме того, в результате получается избыточное количество коэффициентов, намного превосходящее число отсчетов исходного сигнала, которое не требуется для его реконструкции.

Дискретное вейвлет – преобразование (DWT), реализованное в библиотеке PyWavelets, обеспечивает достаточно информации как для анализа сигнала, так и для его синтеза, являясь вместе с тем экономным по числу операций и по требуемой памяти.

Когда нужно использовать вейвлет-преобразование вместо преобразования Фурье

Преобразования Фурье будет работать очень хорошо, когда частотный спектр стационарный. При этом частоты, присутствующие в сигнале, не зависят от времени, и сигнал содержит частоты xHz, которые присутствует в любом месте сигнала. Чем нестационарнее сигнал, тем хуже будут результаты. Это проблема, так как большинство сигналов, которые мы видим в реальной жизни, нестационарны по своей природе.
Читать полностью »

И сотворил Гвидо строки по образу C, по образу массивов символов сотворил их. И увидел Гвидо, что это хорошо. Или нет?

Представьте, что вы пишете совершенно идиоматичный код по обходу неких данных с вложенностью. Beautiful is better than ugly, simple is better than complex, так что вы останавливаетесь на следующем варианте кода:

from collections.abc import Iterable

def traverse(list_or_value, callback):
    if isinstance(list_or_value, Iterable):
        for item in list_or_value:
            traverse(item, callback)
    else:
        callback(list_or_value)

Вы пишите юнит-тест, и что бы вы думали? Он не работает, причём не просто не работает, а

>>> traverse({"status": "ok"}, print)
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
  File "<stdin>", line 4, in traverse
  File "<stdin>", line 4, in traverse
  File "<stdin>", line 4, in traverse
  [Previous line repeated 989 more times]
  File "<stdin>", line 2, in traverse
  File "/usr/local/opt/python/libexec/bin/../../Frameworks/Python.framework/Versions/3.7/lib/python3.7/abc.py", line 139, in __instancecheck__
    return _abc_instancecheck(cls, instance)
RecursionError: maximum recursion depth exceeded in comparison

Как? Почему? В поисках ответа вы погрузитесь в удивительный мир коллекций бесконечной глубины.
Читать полностью »

image

Я живу в хорошем городе. Но, как и во многих других, поиск парковочного места всегда превращается в испытание. Свободные места быстро занимают, и даже если у вас есть своё собственное, друзьям будет сложно к вам заехать, ведь им будет негде припарковаться.

Поэтому я решил направить камеру в окно и использовать глубокое обучение, чтобы мой компьютер сообщал мне, когда освободится место:

image

Это может звучать сложно, но на самом деле написать рабочий прототип с глубоким обучением — быстро и легко. Все нужные составляющие уже есть — нужно всего лишь знать, где их найти и как собрать воедино.

Поэтому давайте немного развлечёмся и напишем точную систему уведомлений о свободной парковке с помощью Python и глубокого обученияЧитать полностью »

Предисловие

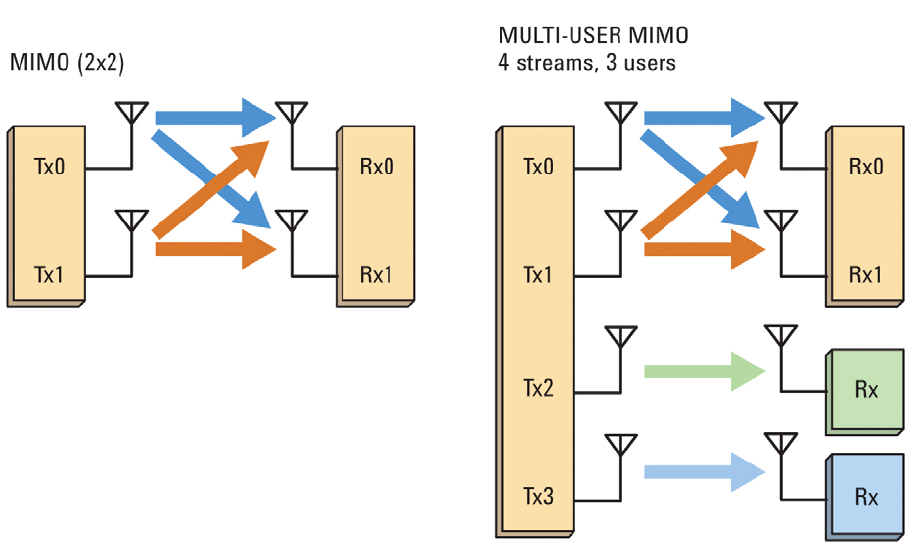
В качестве дополнения к моей недавней статье хотелось бы также поговорить о теме MU (Multi User) MIMO. Есть у мною уже упомянутого профессора Хаардта одна очень известная статья, где он вместе со своими коллегами предлагает алгоритм разделения пользователей по нисходящему каналу (Down Link) на основе линейных методов, а именно блоковой диагонализации (Block Diagonalization) канала. Статья имеет внушающее количество цитирований, а также является краеугольной публикацией для одного из заданий экзамена. Поэтому почему бы и не разобрать основы предлагаемого алгоритма?

MU-MIMO: один из алгоритмов реализации - 1
(ссылка на источник иллюстрации)

Читать полностью »

Привет! Сегодня мы построим систему, которая будет при помощи Spark Streaming обрабатывать потоки сообщений Apache Kafka и записывать результат обработки в облачную базу данных AWS RDS.

Представим, что некая кредитная организация ставит перед нами задачу обработки входящих транзакций «на лету» по всем своим филиалам. Это может быть сделано с целью оперативного расчета открытой валютой позиции для казначейства, лимитов или финансового результата по сделкам и т.д.

Как реализовать этот кейс без применения магии и волшебных заклинаний — читаем под катом! Поехали!

Apache Kafka и потоковая обработка данных с помощью Spark Streaming - 1

(Источник картинки)
Читать полностью »

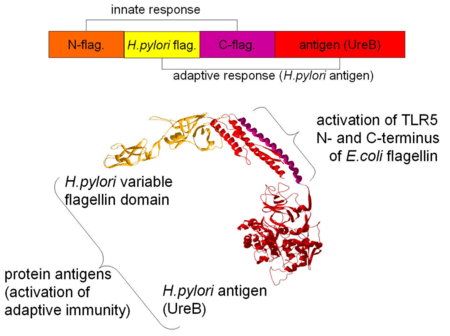
Что, если у вас идея для классного, полезного белка, и вы хотите получить его в реальности? Например, хотите создать вакцину против H. pylori (как словенская команда на iGEM 2008), создав гибридный белок, который сочетает фрагменты флагеллина E. coli, стимулирующие иммунный ответ с обычным флагеллином H. pylori?

Разработка белков в облаке с помощью Python и Transcriptic или Как создать любой белок за $360 - 1
Дизайн гибридного флагеллина вакцины против H. pylori, представленный командой Словении на iGEM 2008

Удивительно, но мы очень близки к тому, чтобы создать любой белок, какой хотим, не выходя из блокнота Jupyter, благодаря последним разработкам в геномике, синтетической биологии и совсем недавно — в облачных лабораториях.

В этой статье я покажу код Python от идеи белка до его экспрессии в бактериальной клетке, не прикасаясь к пипетке и не разговаривая ни с одним человеком. Общая стоимость составит всего несколько сотен долларов! Используя терминологию Виджая Панде из A16Z, это Биология 2.0.
Читать полностью »

Цели данной публикации:

  • Краткое введение в Consumer Driven Contracts (CDC)
  • Настройка CI pipeline на основе CDC

Consumer Driven Contracts

В этой части мы пройдемся по основным моментам CDC. Данная статья не является исчерпывающей на тему контрактного тестирования. Существует достаточное количество материалов на эту тему на том же Хабре.

Для продолжения нам необходимо познакомиться с основными положениями CDC:

  • Контактное тестирование находится на уровне Service/Integration Tests над Unit Tests согласно пирамиде автотестирования (Mike Cohn)
  • Контрактное тестирование может применяться, когда есть 2 (или более) сервиса, которые взаимодействуют друг с другом
  • Сonsumer driven подход означает, что первым шагом в реализации является написание теста на стороне потребителя. Результатом теста является пакт (контракт) в формате json, который описывает взаимодействие между потребителем (например, веб-интерфейс / мобильный интерфейс: сервис, который хочет получить некоторые данные) и поставщиком (например, серверный API: сервис, который предоставляет данные)
  • Следующим шагом является проверка договора с провайдером. Это полностью осуществлено фреймворком Pact.Читать полностью »

Чтобы дойти до сложных алгоритмов обработки, стоит проанализировать стандартные схемы, с чего я и предлагаю начать.

Для примеров обработки будет использоваться изображение с различным наборов цветов:

image

Для старта нам потребуется два модуля библиотеки:

from PIL import Image, ImageDraw 

Настроим инструменты для комфортной дальнейшей работы:

image = Image.open('test.jpg')  # Открываем изображение
draw = ImageDraw.Draw(image)  # Создаем инструмент для рисования
width = image.size[0]  # Определяем ширину
height = image.size[1]  # Определяем высоту
pix = image.load()  # Выгружаем значения пикселей

Приступим

PIL работает с изображениями в формате RGB.
Читать полностью »

Подборка @pythonetc, апрель 2019 - 1

Это десятая подборка советов про Python и программирование из моего авторского канала @pythonetc.

Предыдущие подборки.
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js