
Представляю вашему вниманию очередной выпуск обзора наиболее интересных материалов, посвященных теме анализа данных и машинного обучения.
Читать полностью »
Рубрика «big data» - 120
Обзор наиболее интересных материалов по анализу данных и машинному обучению №32 (19 — 25 января 2015)
2015-01-25 в 16:14, admin, рубрики: big data, data mining, data science, data science digest, machine learningВизуализация многомерных данных с помощью диаграмм Эндрюса
2015-01-23 в 6:35, admin, рубрики: big data, python, Большие данные, визуализация данных В эпоху Big Data графическое представление многомерных данных является весьма актуальной задачей. Однако результат визуализации не всегда соответствует ожиданиям. Вот пример не самого наглядного графика для изображения многомерных данных «Ирисы Фишера»:

Читать полностью »
Как начать работу в Kaggle: руководство для новичков в Data Science
2015-01-21 в 6:36, admin, рубрики: big data, data mining, kaggle, machine learning, nolearn, python, актуальная проблематика, анализ данных, глубокое обучение, искусственные нейронные сети, искусственный интеллект, новичкам, обучение, Питон, рythonДоброго времени суток, уважаемыее! Сегодня я хотел бы поговорить о том, как не имея особого опыта в машинном обучении, можно попробовать свои силы в соревнованиях, проводимых Kaggle.
Как вам уже, наверное, известно, Kaggle – это платформа для исследователей разных уровней, где они могут опробовать свои модели анализа данных на серьезных и актуальных задачах. Суть такого ресурса – не только в возможности получить неплохой денежный приз в случае, если именно ваша модель окажется лучшей, но и в том (а, это, пожалуй, гораздо важнее), чтобы набраться опыта и стать специалистом в области анализа данных и машинного обучения. Ведь самый важный вопрос, зачастую стоящий перед такого рода специалистами – где найти реальные задачи? Здесь их достаточно.
Мы попробуем поучаствовать в обучающем соревновании, не предусматривающем каких-либо поощрений, кроме опыта.
Читать полностью »
Опыт построения команды Big Data
2015-01-20 в 9:46, admin, рубрики: agile, big data, data mining, команда, разработка, тестирование, Тестирование IT-системПривет!
В последнее время все чаще слышу от своих коллег, которые работают в подразделениях Big Data в разных компаниях утверждения о том, что процесс разработки построен не очень эффективно, что зачастую делается большое количество лишних итераций, а также что есть некоторое непонимание со стороны руководителей всех тонкостей получаемых на выходе продуктов. Поэтому в этой и следующей статьях я постараюсь рассказать о своем опыте построения команды, в которой мы работали достаточно эффективно. Сразу отмечу, что это лишь наш опыт, который не претендует на правильность и полноту. Статья направлена в первую очередь на руководителей разработки и представителей бизнеса.
Читать полностью »
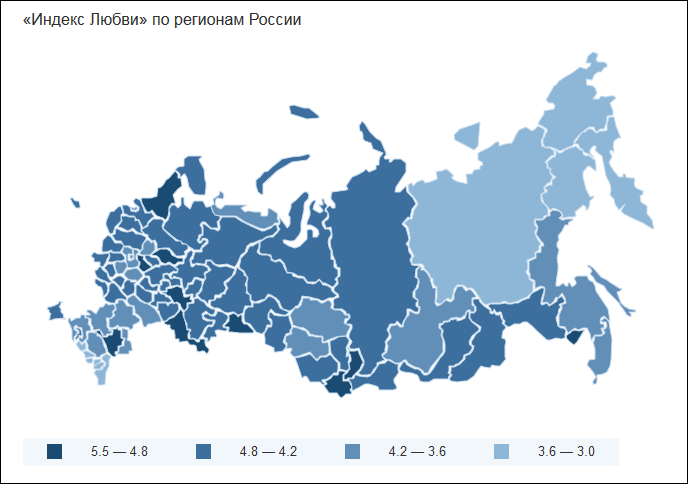
«Любовь и ненависть» на карте России, зима 2014-2015: четвертое исследование эмоционального состояния 35 млн пользователей социальных медиа
2015-01-19 в 13:20, admin, рубрики: big data, Блог компании PalitrumLab, Исследования и прогнозы в IT, исследования пользователей, социальные сетиПредставляем новые данные Brand Analytics по эмоциональному состоянию пользователей социальных сетей в регионах России. В период с 8 по 21 декабря 2014 года было проведено четвертое измерение соотношения позитивных и негативных эмоций в публичных сообщениях российских пользователей соцмедиа. Главный вывод: несмотря на сложную политическую и экономическую ситуацию, в стране сохраняется позитивная динамика общего эмоционального фона.
Обзор наиболее интересных материалов по анализу данных и машинному обучению №31 (12 — 18 января 2015)
2015-01-18 в 15:02, admin, рубрики: big data, data mining, data science, data science digest, machine learning 
Представляю вашему вниманию очередной выпуск обзора наиболее интересных материалов, посвященных теме анализа данных и машинного обучения.
Читать полностью »
Искусство Feature Engineering в машинном обучении
2015-01-17 в 9:45, admin, рубрики: big data, data mining, kaggle, machine learning, python, математикаПривет!
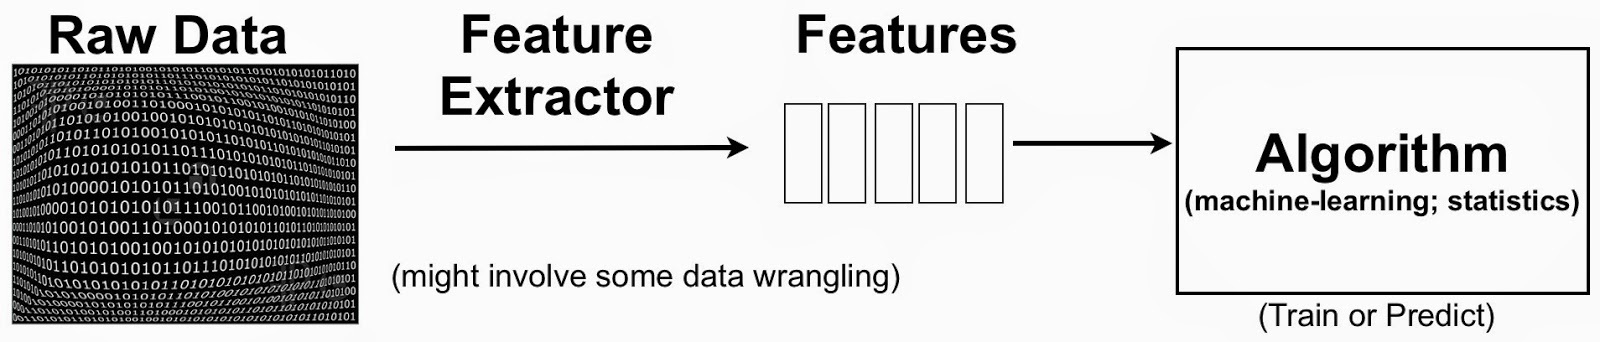
В предыдущей статье (Введение в машинное обучение с помощью Python и Scikit-Learn) мы с вами познакомились с основными этапами решения задач машинного обучения. Сегодня подробнее поговорим о техниках, которые позволяют заметно увеличить качество разрабатываемых алгоритмов. Одна из таких техник — Feature Engineering. Сразу отметим, что это своего рода искусство, обучиться которому можно только прорешав огромное количество задач. Тем не менее, с опытом вырабатываются некие общие подходы, которыми хотелось бы поделиться в данной статье.
Читать полностью »
Неперсонализированные рекомендации: метод ассоциаций
2015-01-14 в 12:57, admin, рубрики: big data, python, Алгоритмы, Блог компании онлайн-кинотеатр ivi.ru, рекомендательные системыПерсональные рекомендации позволяют познакомить пользователя с объектами, о которых он, возможно, никогда не знал (и не узнал бы), но которые могут ему понравиться с учетом его интересов, предпочтений и поведенческих свойств. Однако, часто пользователь ищет не новый объект, а, к примеру, объект A похожий на объект B («Форсаж 2» похож на «Форсаж»), или объект A, который приобретается/потребляется с объектом B (сыр с вином, пиво с детским питанием, гречка с тушенкой и т.д.). Построить такие рекомендации позволяют неперсонализированные рекомендательные системы (НРС).

Рекомендовать похожие/сопутствующие объекты можно, ориентируясь на знания об объектах (свойства, теги, параметры) или на знания о действиях, связанных с объектами (покупки, просмотры, клики). Преимуществом первого способа является то, что он позволяет достаточно точно определить похожие по свойствам объекты («Форсаж 2» и «Форсаж» — похожие актеры, похожий жанр, похожие теги, ...). Однако данный способ не сможет порекомендовать сопутствующие объекты: сыр и вино. Еще одним недостатком этого способа является тот факт, что для разметки всех объектов, доступных на сервисе, требуется не мало усилий.
В то же время почти каждый сервис логирует информацию о том, какой пользователь просмотрел/купил/кликнул какой объект. Данной информации достаточно для построения НРС, которая позволит рекомендовать как похожие, так и сопутствующие объекты.
Под катом описан метод ассоциаций, позволяющий построить неперсонализированные рекомендации, основываясь лишь на данных о действиях над объектами. Там же код на Python, позволяющий применить метод для большого объема данных.
Читать полностью »
Рецепт «Быстрых данных» на основе решения для больших данных
2015-01-13 в 6:51, admin, рубрики: big data, BigData, EMC, Hadoop, high performance, Isilon, Блог компании EMC², высокая производительность, производительность, разработка, системы хранения данных, СХД, хранение данных
При обсуждении работы с большими данными, чаще всего затрагиваются вопросы аналитики и проблемы организации процесса вычислений. Нам с коллегами выпала возможность поработать над задачами другого рода – ускорением доступа к данным и балансированием нагрузки на систему хранения. Ниже я расскажу о том, как мы с этим справились.
Свой «рецепт» мы смастерили из уже существующих «ингредиентов»: железки и программного инструмента. Сначала я расскажу, каким образом перед нами возникла задача ускорения доступа. Затем рассмотрим железку и программный инструмент. В заключение поговорим о двух проблемах, с которыми нам пришлось столкнуться в ходе работы.
Читать полностью »
Введение в машинное обучение с помощью Python и Scikit-Learn
2015-01-13 в 6:39, admin, рубрики: big data, data mining, pythonПривет!
Меня зовут Александр, я занимаюсь машинным обучением и анализом веб-графов (в основном — теоретическим), а также разработкой Big Data продуктов в одном из операторов Большой Тройки. Это мой первый пост — прошу, не судите строго!)
В последнее время ко мне все чаще стали обращаться люди, которые хотят научиться разрабатывать эффективные алгоритмы и участвовать в соревнованиях по машинному обучению с вопросом: «С чего начать?». Некоторое время назад я руководил разработкой инструментов Big Data для анализа медиа и социальных сетей в одном из учреждений Правительства РФ, и у меня остался некоторый материал, по которому обучалась моя команда и которым можно поделиться. Предполагается, что у читателя есть хорошее знание математики и машинного обучения (в команде были в основном выпускники МФТИ и студенты Школы Анализа Данных).
Читать полностью »